
 脚本プランナー▸
 AIアプリ
 AIニュース
Spark-TTS: ゼロショット音声クローンと多言語合成に対応する高性能テキスト読み上げシステム
Spark-TTS: ゼロショット音声クローンと多言語合成に対応する高性能テキスト読み上げシステム紹介
Spark-TTSとは?
Spark-TTSは、SparkAudioチームが開発したテキスト読み上げ(TTS)システムで、Qwen2.5をベースに構築されています。テキストから直接ピッチ、速度、話者のスタイルを制御でき、ゼロショット音声クローン、多言語合成、きめ細やかな音声制御、Web UIによる音声生成をサポートし、テキストを自然で高品質な音声コンテンツに素早く変換できます。従来のTTSシステムとは異なり、LLMが予測したエンコーディングから直接音声を再構築するため、音声生成プロセスが簡素化され、効率が向上しています。
Spark-TTSの主な機能
ゼロショット音声クローン:Spark-TTSはゼロショット音声クローンをサポートしており、特定の話者の学習データがなくても、話者の声を複製することができます。言語をまたいだシナリオやコードスイッチングにおいても、異なる言語や話者間でシームレスに切り替える優れた性能を発揮します。
多言語サポート:このシステムは中国語と英語をサポートしており、言語をまたいだ合成においても高い自然さと正確性を維持します。ユーザーがある言語でテキストを入力すれば、別の言語の音声出力を得ることができます。
きめ細やかな音声制御:ユーザーは性別、ピッチ、速度などのパラメータを調整することで、バーチャル話者の声をカスタマイズでき、バーチャルキャスターやオーディオブックなど、多様な音声コンテンツを必要とするシナリオのニーズに対応できます。
効率的な音声合成:Spark-TTSはQwen2.5アーキテクチャに完全に基づいており、追加の生成モデルを必要とせず、LLMが予測したエンコーディングから直接音声を再構築するため、プロセスが簡素化され、複雑性が軽減されます。
バーチャル話者の作成:ユーザーはパラメータを調整することで、自分だけのバーチャル話者を作成し、そのバーチャル話者に独自の音声スタイルを与えることができます。
Spark-TTSの技術アーキテクチャ
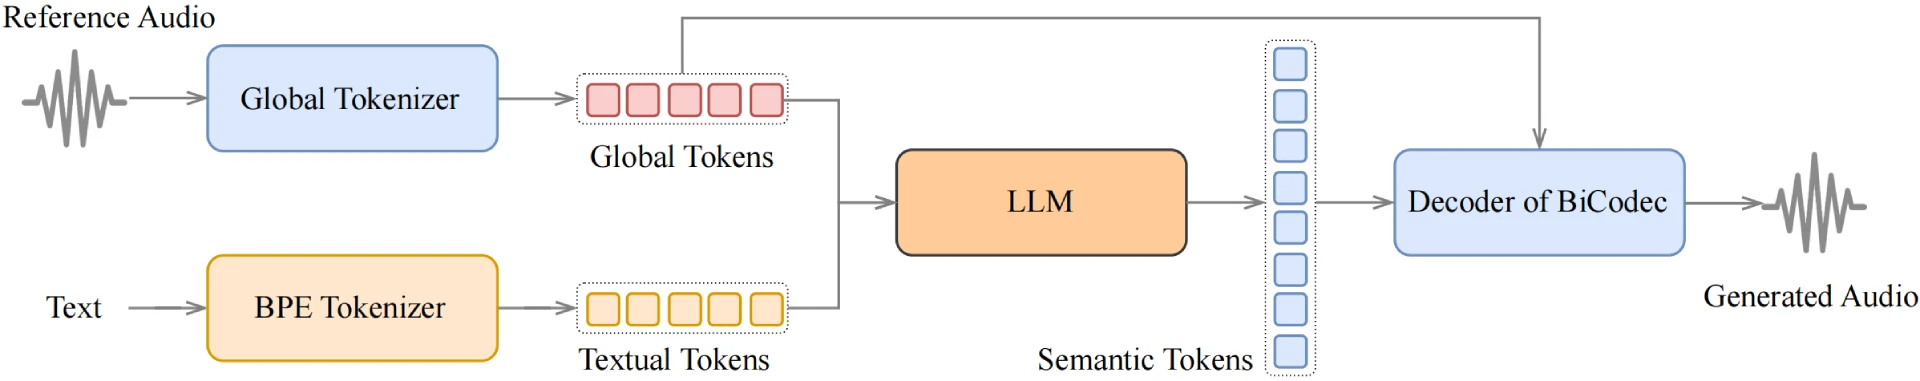
Spark-TTSの技術基盤はBiCodec単一ストリーム音声コーデックであり、音声を低ビットレートのセマンティックトークン(言語内容を担う)と固定長のグローバルトークン(話者属性を担う)に分解します。この分離方式により、音声特性の柔軟な調整が可能となり、Qwen2.5の思考連鎖(Chain-of-Thought)技術と組み合わせることで、音声生成の品質と制御性がさらに向上します。
Spark-TTSの利用シーン
オーディオブック制作:自然な音声品質は、オーディオブックでの使用に特に適しています。
バーチャルキャスター:音声パラメータを調整することで、特定のニーズに合ったバーチャル話者を生成できます。
言語をまたいだ音声合成:複数の言語をサポートしており、世界規模での適用範囲を拡大しています。
Spark-TTSのインストールと使用方法
1. 環境の準備
Pythonのインストール:Python 3.12がすでにインストールされていることを確認してください。
Condaのインストール:仮想環境の管理に使用します。Minicondaの公式サイトからダウンロードしてインストールできます。
2. リポジトリのクローン
git clone https://github.com/SparkAudio/Spark-TTS.git
cd Spark-TTS
3. 依存関係のインストール
conda create -n sparktts -y python=3.12
conda activate sparktts
pip install -r requirements.txt
中国大陸にいる場合は、Alibaba Cloudミラーを使用できます:
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com
4. 事前学習済みモデルのダウンロード
以下のコマンドで事前学習済みモデルをダウンロードします:
from huggingface_hub import snapshot_download
snapshot_download("SparkAudio/Spark-TTS-0.5B", local_dir="pretrained_models/Spark-TTS-0.5B")
5.基本的な使用方法
以下のコマンドを実行して音声合成を行います:
python -m cli.inference \
    --text "text to synthesis." \
    --device 0 \
    --save_dir "path/to/save/audio" \
    --model_dir pretrained_models/Spark-TTS-0.5B \
    --prompt_text "transcript of the prompt audio" \
    --prompt_speech_path "path/to/prompt_audio"
6. Web UIの使用
python webui.py --device 0
GitHubリポジトリ:https://github.com/SparkAudio/Spark-TTS
HuggingFaceモデルライブラリ:https://huggingface.co/spaces/Mobvoi/Offical-Spark-TTS
論文:https://arxiv.org/pdf/2503.01710
デモ:https://sparkaudio.github.io/spark-tts/
関連情報:
Llasa:Llamaベースのテキスト読み上げ(TTS)モデルで、自然で滑らか、感情豊かな生成効果を実現
Octave:Hume AIが発表した、コンテキスト認識と感情適応が可能なTTSモデル














