
 脚本プランナー▸
 AIアプリ
 AIニュース
Step-Audio:Stepfunが発表した初のオープンソース音声インタラクションモデル
Step-Audio:Stepfunが発表した初のオープンソース音声インタラクションモデル紹介
Step-Audioは、業界初の製品レベルのオープンソース音声インタラクションモデルとして、感情、方言、言語、歌、個別スタイルなど、シナリオのニーズに応じて多様な音声表現を生成する能力を持ち、自然でスムーズな対話を実現します。中国語水平試験6級(HSK6)の評価において、Step-Audioは卓越したパフォーマンスを発揮し、「中国語を最も理解するオープンソースモデル」と称賛されています。このAIモデルは、StepFun(阶跃星辰)と吉利汽車集団によって共同開発され、2025年2月18日に正式にオープンソース化されました。
Step-Audioの主な機能:
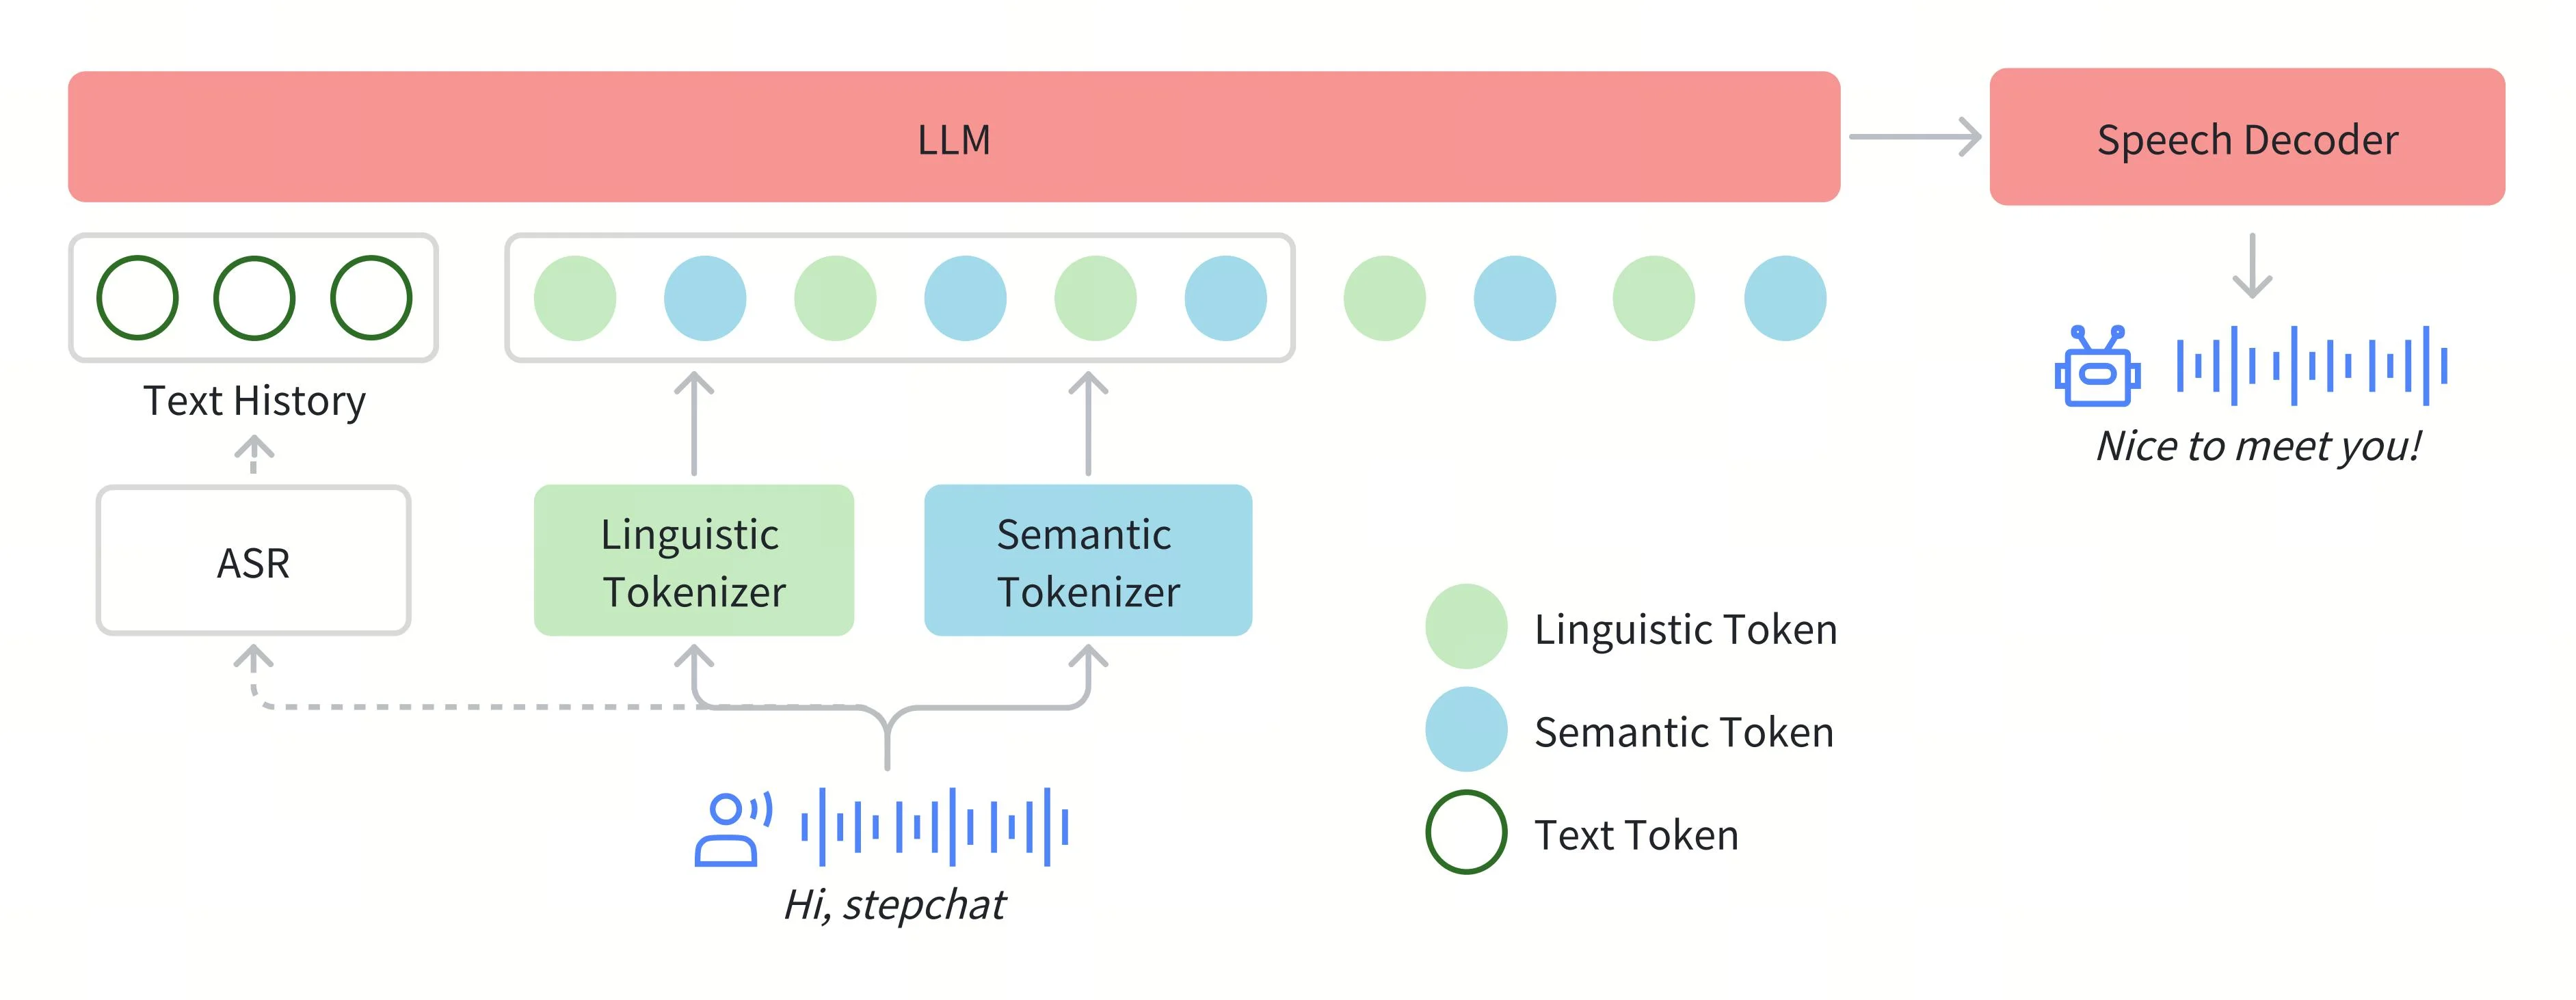
統一モデル:130億パラメータに基づくマルチモーダルモデルにより、音声認識と生成を統合し、音声認識、意味理解、対話、音声クローン、音声編集と合成を同時に処理できます。
多様な感情とスタイル:ニーズに応じて、異なる感情(怒り/喜び/悲しみ)、方言(広東語/四川語など)、言語、歌(ラップ/ハミング)、個別スタイルの音声を生成し、感情、方言、言語、歌を精密に制御します。
高品質な対話:自然で高品質な対話体験を提供し、リアルな会話のように自然でスムーズなインタラクションを実現します。
スマートインタラクション:論理的推論、創作、指示制御、言語、ロールプレイ、テキストゲームなどの高度なインタラクション機能を備えています。
Step-Audioの活用シーン:
スマートカスタマーサービス:個別化され感情豊かな対応を提供し、ユーザー体験を高めます。
オーディオブック:感情を込めた読み上げを生成し、聴く読書体験への没入感を高めます。
ゲームNPC:ゲームキャラクターに自然でスムーズな音声インタラクションを提供します。
会議記録:音声をリアルタイムでテキストに変換し、音声フィードバックを提供します。
教育支援:個別化された教育アシスタントとして、教学スタイルやトーンを調整します。
Step-Audioの技術的特徴:
高圧縮技術:Video-VAEなどの高効率な圧縮技術を採用し、データ処理を最適化します。
二言語処理能力:Hunyuan-CLIPとStep-LLMを活用して中国語と英語のプロンプトを処理します。
DITアーキテクチャとVideo-DPOアルゴリズム:複雑な映像・音声データの処理を最適化します。
大規模データセットによる学習:大規模データセットを構築し、モデルの汎化性能と細部表現を保証します。
Step-Audioの使用方法:
モデルの取得:跃问アプリやHugging FaceなどのプラットフォームでStep-Audioのオープンソース版にアクセスします。
技術レポート:arxiv.orgやGitHubで技術レポートを確認し、詳細を学びます。
APIインターフェース:APIを通じて音声インタラクションを呼び出し、MITオープンソースライセンスに従います。
統合開発:公式ドキュメントやサンプルコードに従って、アプリケーションに統合します。
カスタマイズ学習:上級ユーザーがファインチューニングを行い、特定のシナリオに適応させたり、性能を向上させたりすることができます。
Step-Audioの取得方法
GitHub:https://github.com/stepfun-ai/Step-Audio
ModelScope:[アクセスする]
技術レポート:[アクセスする]
PAI Model Galleryワンクリックデプロイ対応 [アクセスする]














