
 脚本プランナー▸
 AIアプリ
 AIニュース

MakeAnything:コンシステントな連続画像生成モデル
MakeAnything:コンシステントな連続画像生成モデル紹介
MakeAnythingは、シンガポール国立大学が開発した拡散変換器(Diffusion Transformers)に基づくシーケンス生成モデルで、テキスト記述を通じてシーケンス画像を生成することができ、強力な生成能力により一貫性のある複数サブ画像のパズルを提供します。
MakeAnythingの機能特徴:
拡散Transformer:拡散Transformerの卓越した性能を活用して、複雑な画像の生成を実現します。
テキストから画像へ:テキスト記述をさまざまなスタイルの画像に変換することをサポートし、トレーニングとプロンプトによって生成効果を強化します。
サブ画像の一貫性:画像生成プロセスにおいて生成される複数のサブ画像が視覚的に一貫していることを保証します。
MakeAnythingの技術的特徴:
このモデルは非対称低ランク適応(LoRA)技術とReCraftモデルを組み合わせているため、生成プロセスがより効率的になり、静的画像を解釈可能な創作フローに変換して、各ステップをユーザーに明確に把握させ、複数ステップのシーケンス生成時に論理的一貫性と視覚的一貫性を維持するという問題を解決します。
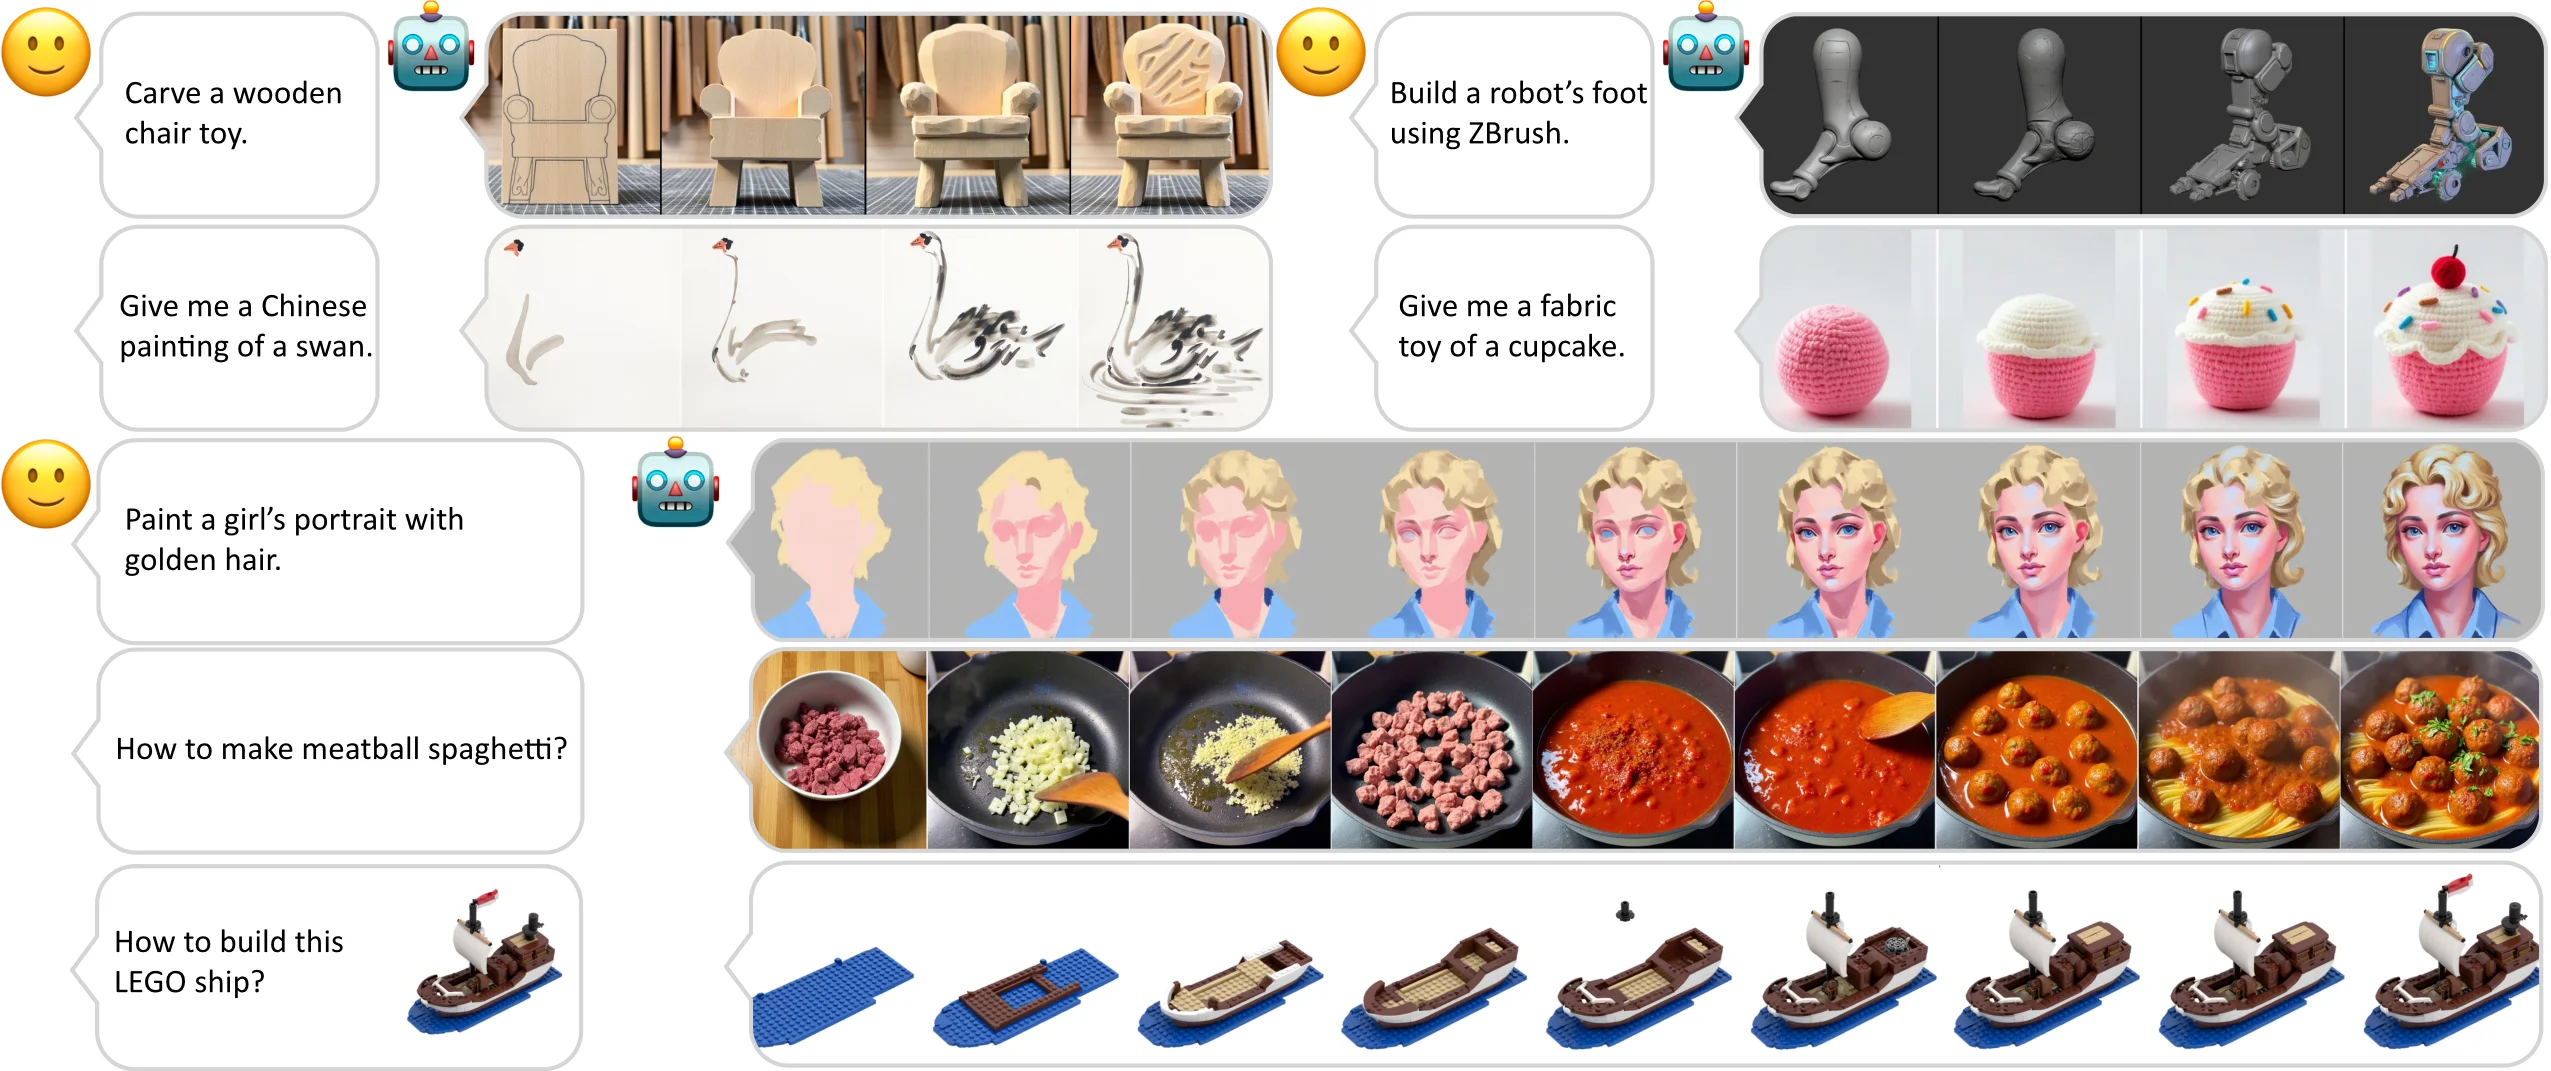
MakeAnythingの使用手順:
トレーニングデータの準備:タスクの要件に応じてテキストと画像データセットを準備し、通常はデータクリーニングとフォーマット整理作業を行う必要があります。
モデルトレーニング:非対称LoRA手法を用いてMakeAnythingデータセットでトレーニングを行い、生成能力を向上させようにモデルを調整します。
コンテンツの生成:トレーニング完了後、ユーザーはテキストプロンプトを入力することができ、モデルはそのプロンプトに基づいて関連する画像やその他のマルチモーダルコンテンツを生成します。
後処理:生成されたコンテンツは後処理段階でさらに最適化することができ、たとえば色彩の調整やディテールの追加などを行い、ユーザーのニーズにより適合させます。
MakeAnythingの応用範囲:
彫刻デザイン:彫刻デザインのスケッチや3Dモデルの生成に使用されます。
絵画創作:自動化されたアーティスティックペインティングに応用され、クリエイターに新しいインスピレーションをもたらします。
自動車の変形:自動車デザインの分野において、異なる視点やスタイルの変形効果を実現します。
手工芸とDIY:ユーザーはさまざまな手工芸技術に関するステップごとの指導を生成し、実際の作業を行うことができます。
料理とレシピ:詳細な料理のステップを生成し、ユーザーが複雑な料理を作る過程を学習するのを支援します。
Github:https://github.com/showlab/MakeAnything














