
 脚本プランナー▸
 AIアプリ
 AIニュース
FireRedASR:小紅書(Xiaohongshu)が公開したオープンソース音声認識モデル
FireRedASR:小紅書(Xiaohongshu)が公開したオープンソース音声認識モデル紹介
FireRedASRは、小紅書(Xiaohongshu)のFireRedチームが2025年2月9日にリリースしオープンソース化した、大規模言語モデルベースの音声認識モデルです。中国語標準語の音声認識分野において新たなSOTA(文字誤り率CER 3.05%)を達成し、中国語方言、英語、歌詞認識もサポートしています。
FireRedASRの主な機能:
高精度な音声認識:FireRedASR-LLM(83億パラメータ)は、公開テストセットにおいて3.05%の文字誤り率(CER)を達成し、新たなSOTAとなりました。従来のSOTAモデルであるSeed-ASR(120億超パラメータ)と比較して、誤り率を8.4%削減しました。
高効率な推論:FireRedASR-AED(11億パラメータ)は、高精度を維持しつつ、推論効率を大幅に向上させており、CERは3.18%です。
マルチシーン対応:FireRedASRは、ショート動画、ライブ配信、音声入力、スマートアシスタントなど、さまざまな日常シーンで優れた性能を発揮し、業界をリードするASRサービスプロバイダやParaformer-Largeと比較して、CERを相対的に23.7%~40.0%削減しています。
歌詞認識能力:歌詞認識能力が必要なシーンにおいて、FireRedASR-LLMのCERは50.2%~66.7%の相対的な削減を実現し、極めて高い適応能力を示しています。
多言語サポート:FireRedASRは標準語をサポートしており、中国語方言や英語の音声認識においても優れた性能を発揮し、応用範囲をさらに広げています。
FireRedASRモデルの2つのコアバージョン:
FireRedASR-LLM
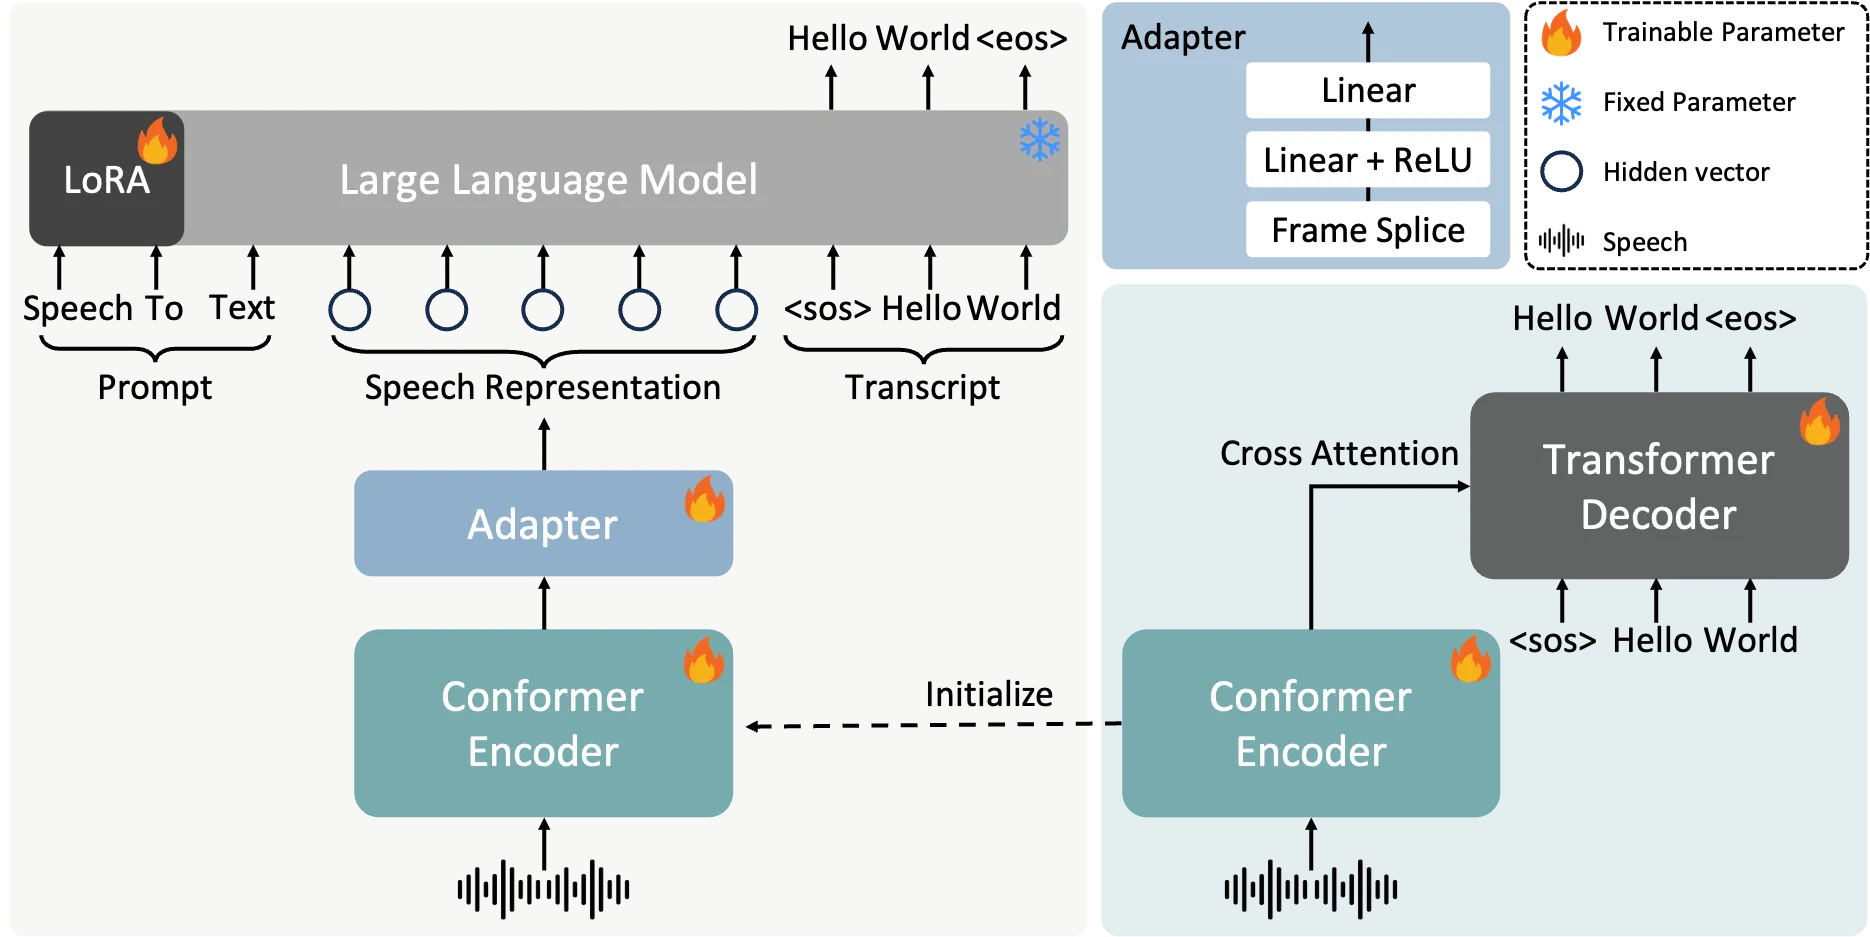
アーキテクチャ:Encoder-Adapter-LLMフレームワークを採用し、大規模言語モデルQwen2-7B-Instructと組み合わせ、LoRAファインチューニングによりエンドツーエンドの音声対話を実現しています。
性能:標準語のベンチマークテストにおいてCERは3.05%で、従来のSOTAモデルと比較して誤り率を8.4%削減。歌詞認識シーンではCERを相対的に50.2%~66.7%削減しています。
特徴:パラメータ数は83億で、極限の精度に重点を置いており、プロ仕様の字幕生成など、高品質が求められるシーンに適しています。
FireRedASR-AED
アーキテクチャ:アテンションエンコーダ・デコーダ(Conformerエンコーダ + Transformerデコーダ)に基づいており、パラメータ数は11億です。
性能:CER 3.18%で、120億パラメータのSeed-ASRを上回り、推論効率もより高くなっています。
特徴:精度と計算効率のバランスが取れており、ライブ字幕や音声アシスタントなどのリアルタイムアプリケーションに適しています。
FireRedASRの技術的なハイライト:
マルチシーン対応:ショート動画やライブ配信などの日常シーンにおいて、CERを相対的に23.7%~40.0%削減。中国語方言や英語もサポートしています。
オープンソースエコシステム:モデルとコードはオープンソース化されており(GitHub)、産業グレードの設計を採用しているため、コミュニティによる二次開発もサポートしています。
学習戦略:LLMバージョンは大半のパラメータを固定し、エンコーダとアダプタのみを学習することで、事前学習能力を保持しています。
FireRedASRの応用シーン
スマート音声インタラクション:FireRedASRはスマート音声アシスタントや音声入力方式などのシーンに応用でき、高精度な音声認識サービスを提供します。
マルチメディアコンテンツ理解:FireRedASRは動画字幕生成や歌詞認識などのマルチメディアコンテンツ理解のシーンにおいて優れた性能を発揮します。
日常シーンへの応用:FireRedASRはショート動画、ライブ配信、音声入力、スマートアシスタントなど、さまざまな日常シーンで優れた性能を発揮し、業界をリードするASRサービスプロバイダやParaformer-Largeと比較して、CERを相対的に23.7%~40.0%削減しています。
FireRedASR関連リンク:
プロジェクトアドレス:https://github.com/FireRedTeam/FireRedASR
論文アドレス:https://arxiv.org/abs/2501.14350














