
 脚本プランナー▸
 AIアプリ
 AIニュース
JoyGen:音声駆動による3Dトーキングフェイス映像生成フレームワーク
JoyGen:音声駆動による3Dトーキングフェイス映像生成フレームワーク紹介
JoyGenは、京東科技と香港大学が共同開発したオーディオ駆動型3D話す顔動画生成フレームワークであり、新たな二段階フレームワークです。この技術の中核は、音声入力を用いて3D深度認識モデルを駆動し、正確な唇と音声の同期を提供することで、話者の唇の動きや表情を精密にシミュレーションし、生成された動画をよりリアルにします。主に動画編集や仮想インタラクションの分野に応用されます。
JoyGenは、130時間分の高品質動画を含む中国語話者顔データセットを使用して学習されています。このデータセットは、公開されているHDTF(高解像度深度マップデータセット)と組み合わせられ、中国語と英語の入力に対応しています。
さらに、JoyGenは音声の感情特徴も考慮しており、生成されたアニメーション内で笑顔やしかめっ面など、人物の感情変化を自然に表現することができます。非常に強力です。
JoyGenの主な機能:
多言語サポート:JoyGenは中国語や英語など、複数の言語の音声入力を処理できます。
高品質な視覚効果:細部までこだわった表情や唇の処理により、生成される動画は非常にリアルです。
正確な唇の同期:音声特徴分析と顔深度マップ技術により、動画内の人物の唇の動きと音声内容を完全に一致させます。
動画編集の最適化:新しい動画を生成するだけでなく、既存の動画に対して唇の動きを編集することも可能で、動画全体を最初から再作成する必要がありません。
効率的な技術アーキテクチャ:単一ステップのUNetアーキテクチャを採用しており、動画編集のフローをよりシンプルにすることができます。
技術原理:
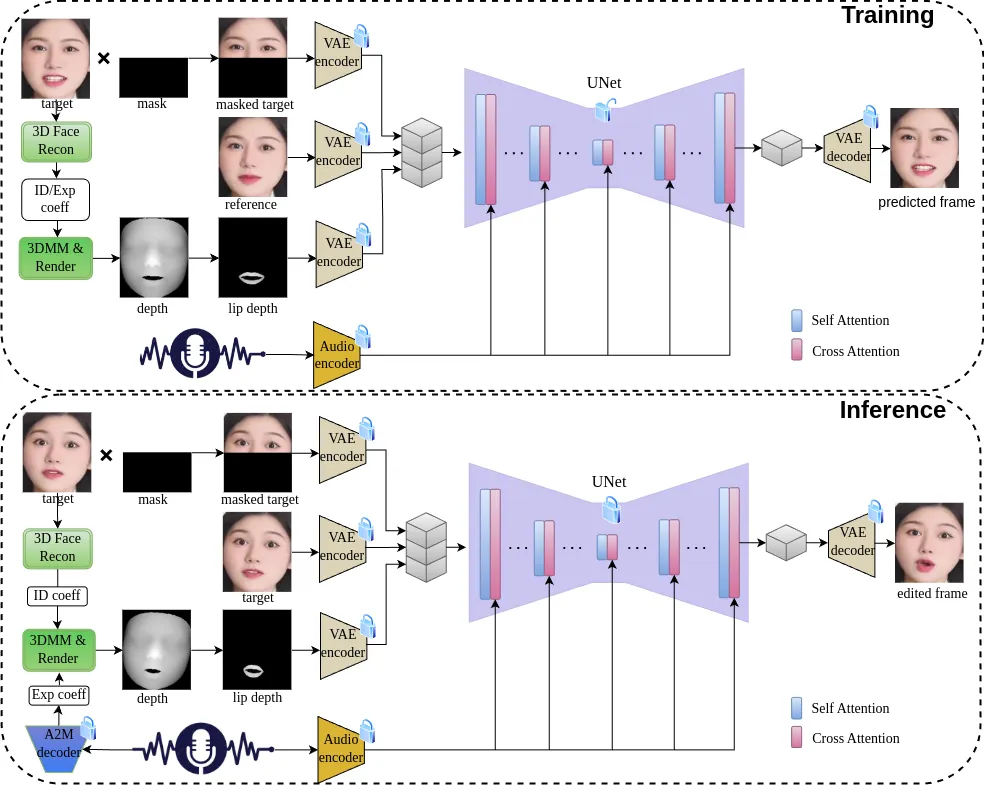
1. オーディオ駆動による唇の動き生成:
3D再構築モデルを利用して顔画像からidentity特徴を抽出し、人物特有の顔構造を定義します。
音声から動きへのモデルを通じて、音声信号を唇の動きを制御する表情係数に変換します。
identity係数と表情係数を組み合わせ、微分可能なレンダリング技術を用いて顔深度マップを生成し、後続の動画合成に備えます。
2. 視覚的外観の合成:
単一ステップのUNetネットワークを用いて音声特徴と深度マップを統合し、正確な唇の動きを含む動画フレームを直接生成します。
クロスアテンション機構を導入し、唇の動きと音声信号の高い一貫性を確保して同期性を強化します。
最適化プロセス(L1損失関数など)を通じて動画品質を保証し、ピクセルレベルと潜在空間の正確性の両方を兼顾します。
JoyGenの使用方法:
環境の構築:ユーザーは特定のconda環境を作成し、Nvdiffrastなどの必要なライブラリを含む必要な依存パッケージをインストールする必要があります。
事前学習済みモデルのダウンロード:JoyGenの事前学習済みモデル(3Dモデルや音声から動きへのモデルなど)を取得します。これらのリソースは通常、プロジェクトのGitHubページで提供されています。
推論の実行:特定のスクリプトとパラメータを実行することで、音声ファイルをリアルな唇の同期を備えた3D話す顔動画に変換することができます。
JoyGenの応用:
バーチャル会議:バーチャル会議における表情表現を強化します。
映画・映像制作:映画やテレビの特殊効果を制作します。
教育・研修:生き生きとした教育動画を制作するために使用されます。
JoyGenは複雑な顔動画生成を大幅に簡素化し、デジタルヒューマンコンテンツ制作、バーチャル会議、エンターテインメントなどの分野で非常に大きな役割を果たします。
GitHub:https://github.com/JOY-MM/JoyGen














