
 脚本プランナー▸
 AIアプリ
 AIニュース
Tarsier:バイトダンスが発表した大規模視覚言語モデル
Tarsier:バイトダンスが発表した大規模視覚言語モデル紹介
Tarsierはバイトダンスが発表した大規模視覚言語モデル(LVLM)シリーズであり、動画理解タスクに特化しており、動画キャプション生成、質問応答、グラウンディング、ハルシネーションテストなどの機能を備えています。
Tarsierの主な機能
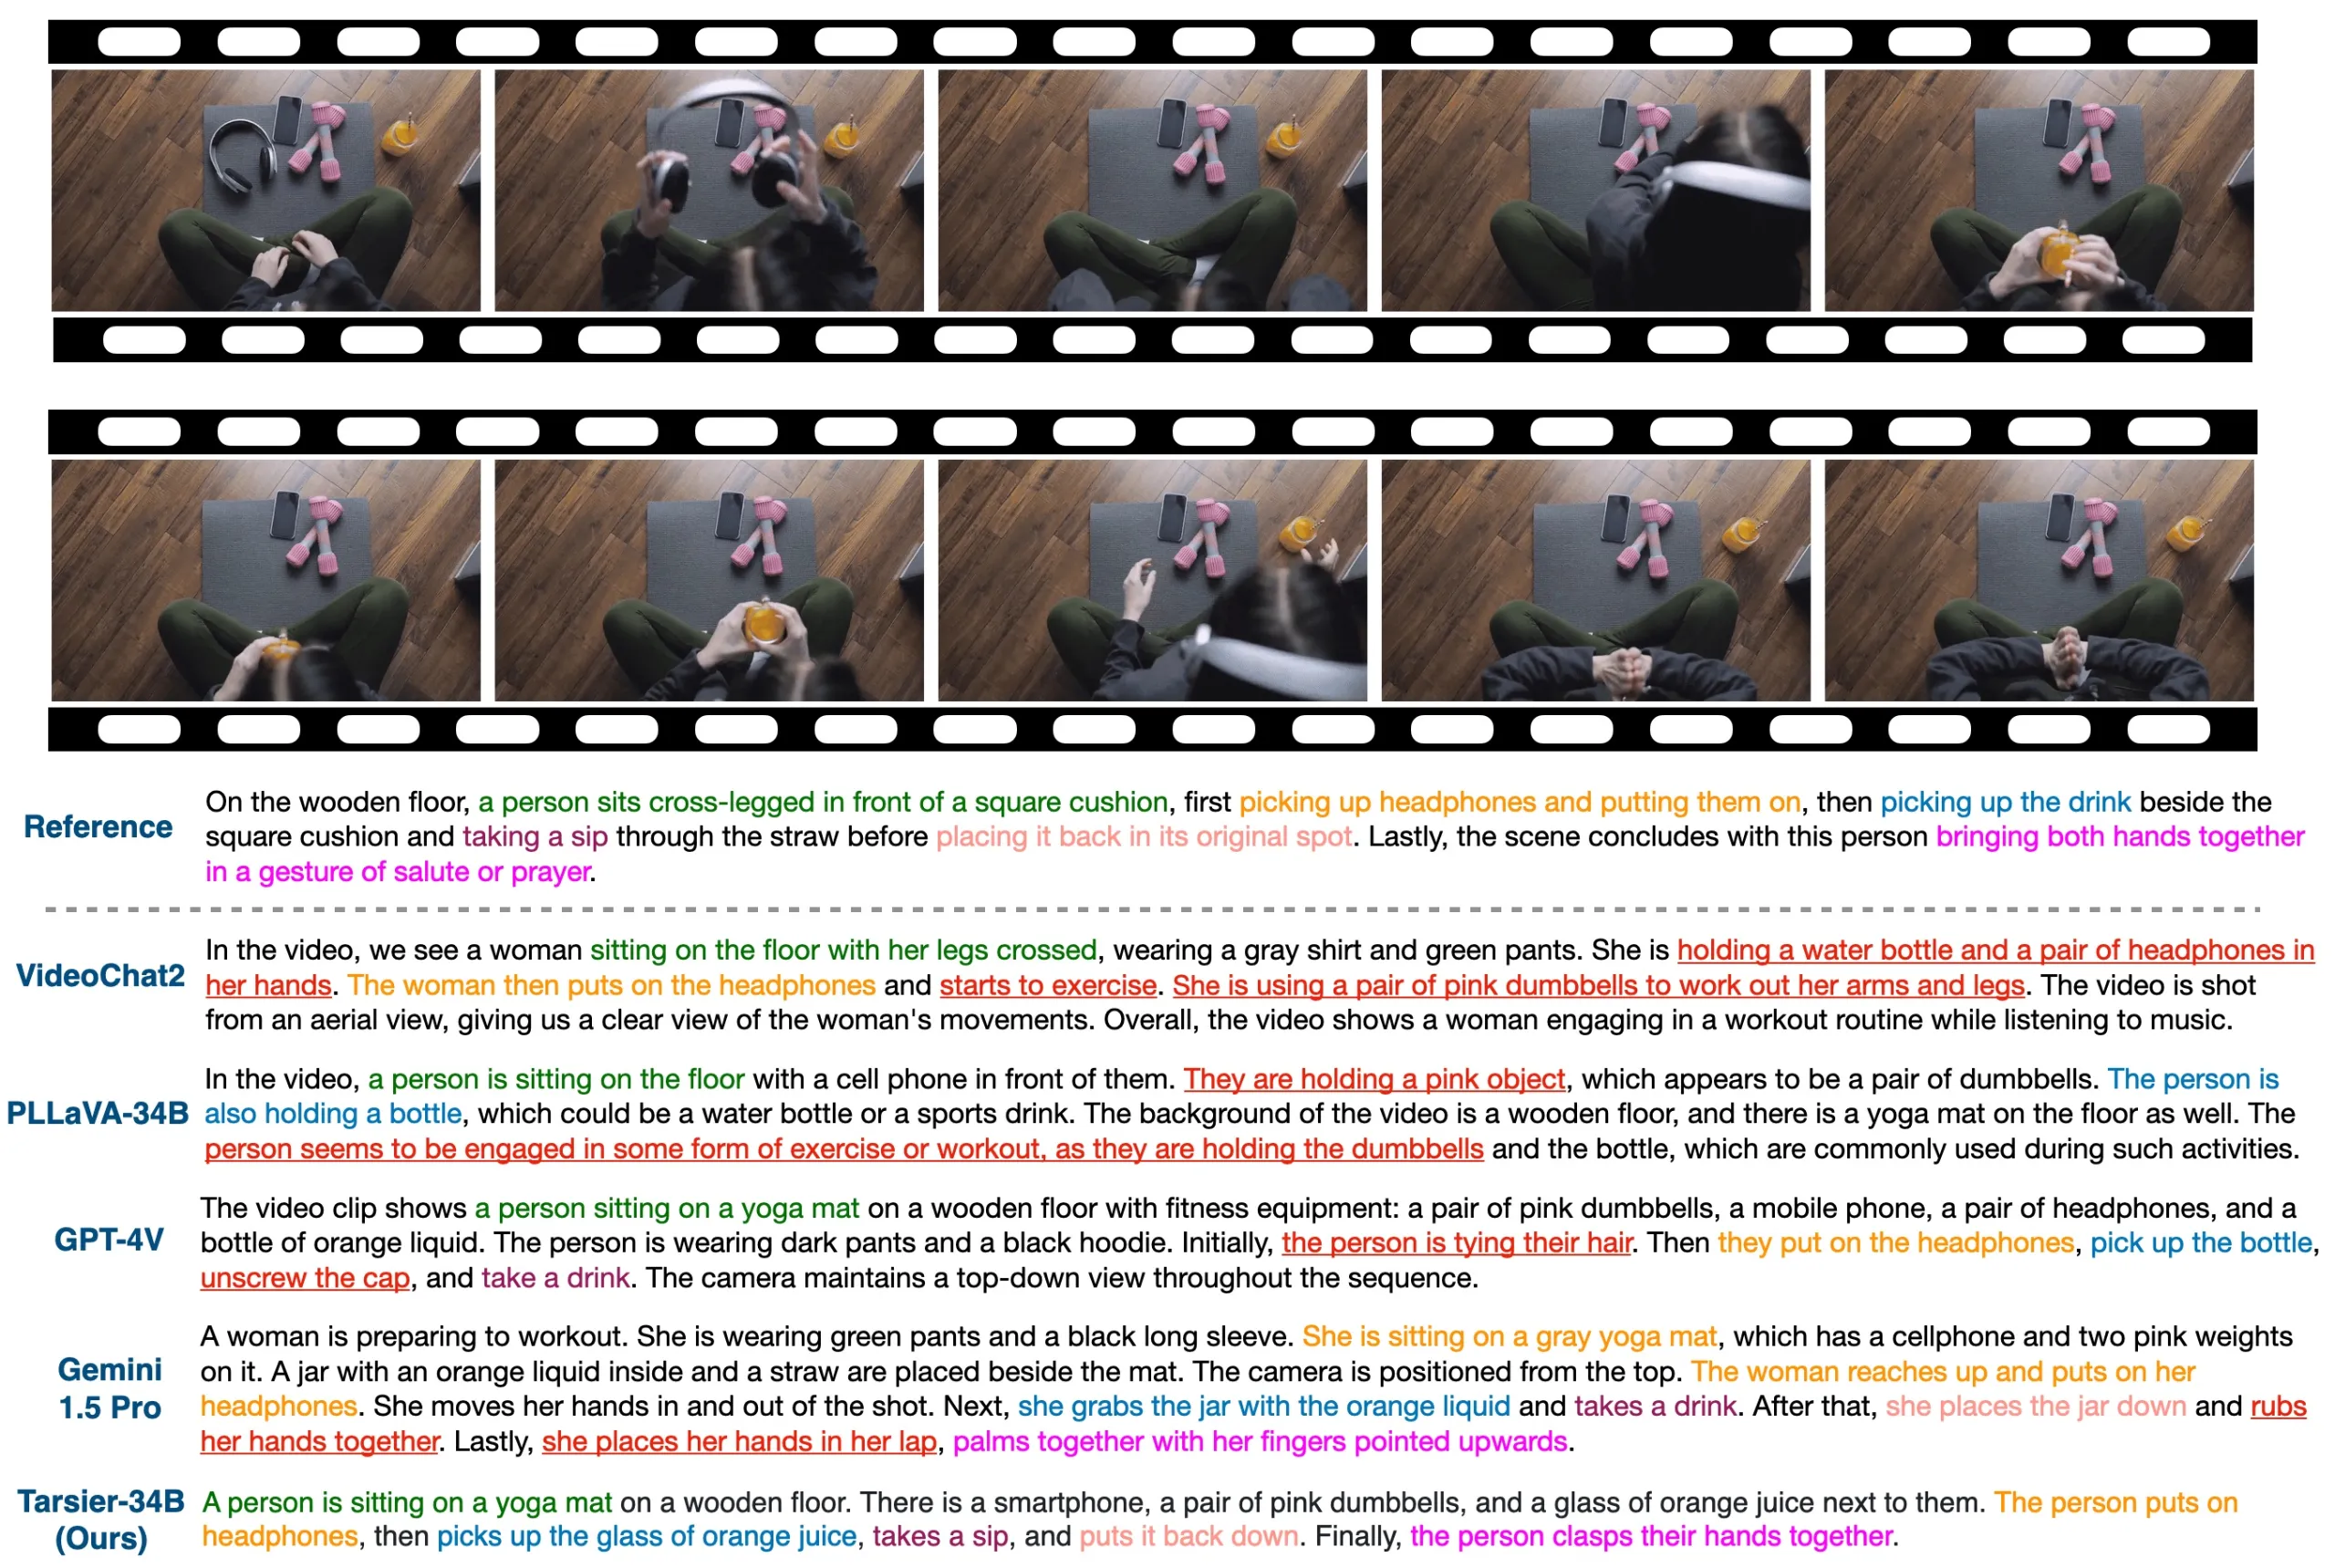
動画キャプション生成:Tarsierは高品質な動画キャプションを生成でき、動画内の動作、シーン、プロットなどの細部をカバーし、ユーザーが動画内容をより深く理解するのに役立ちます。
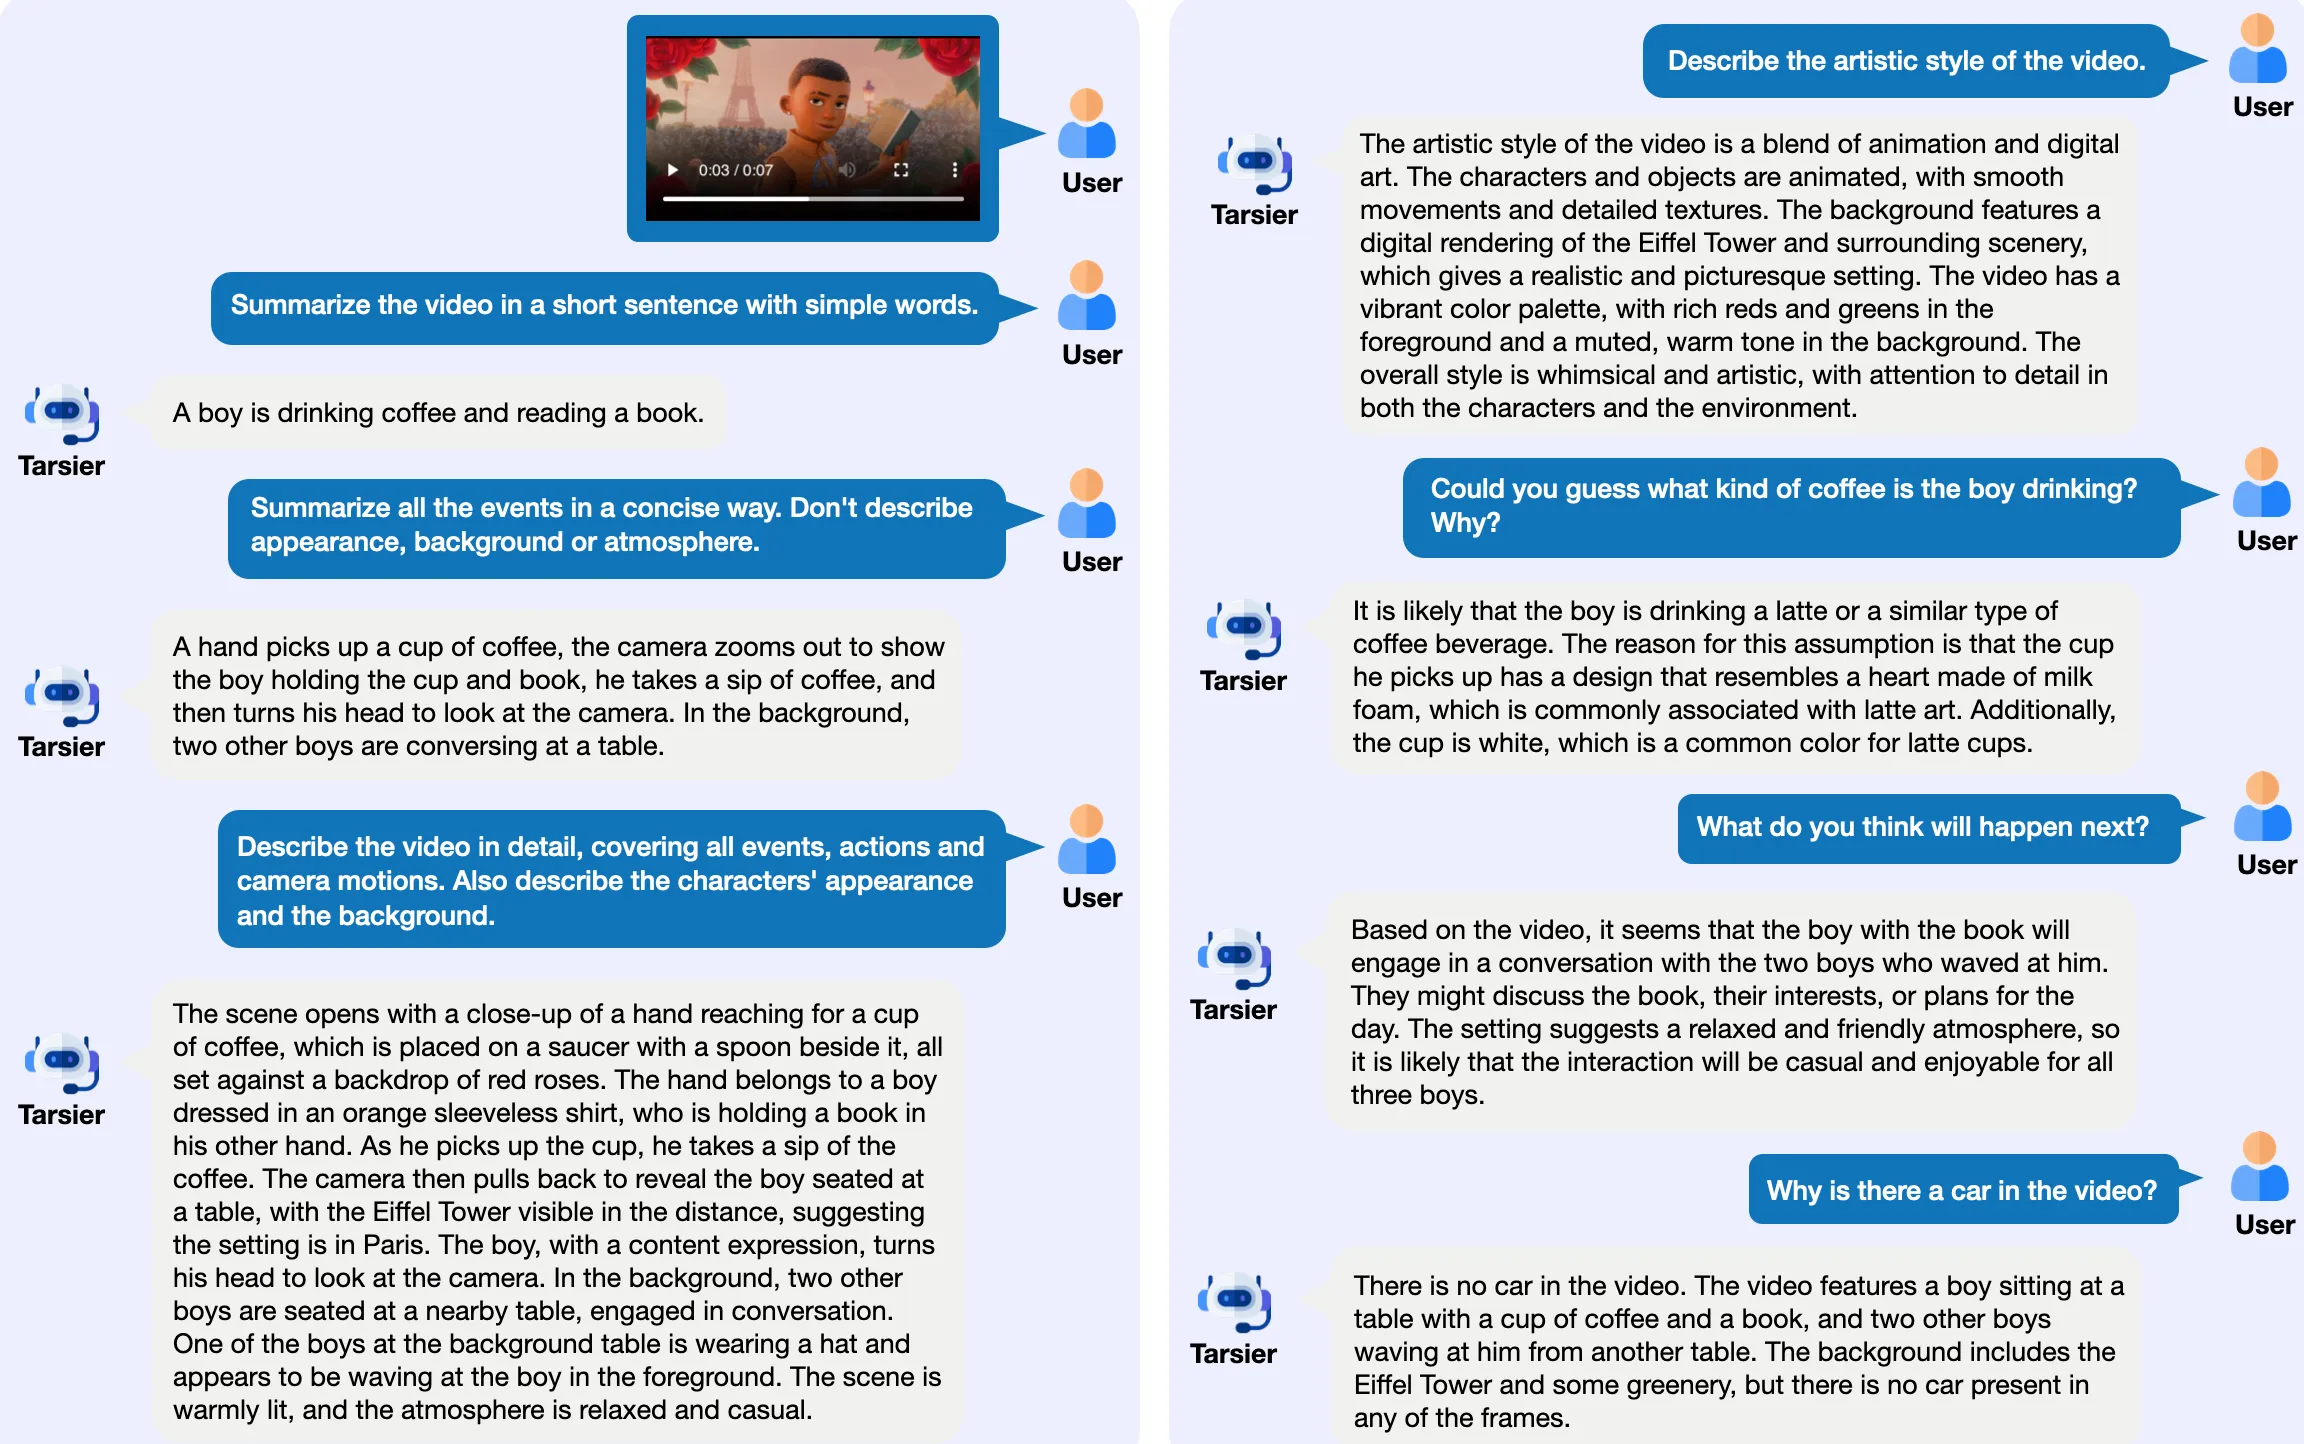
質問応答機能:Tarsierモデルは動画に関する質問応答機能をサポートしており、ユーザーは動画内容に基づいて質問を行い、モデルが関連する回答を提供します。
グラウンディング機能:動画内で特定のイベントが発生する時間を検出し定位します。複数の動画セグメントの定位をサポートし、動画内の特定のオブジェクトやシーンを識別してマークすることができます。
ハルシネーションテスト:トレーニング戦略を最適化することで、Tarsier2はモデルが誤った情報を生成する可能性を大幅に低減しました。
多言語サポート:複数言語での動画キャプション生成をサポートしています。
Tarsierの応用シナリオ:
コンテンツ制作:Tarsierはコンテンツ制作者が動画キャプションを生成するのを支援し、動画のアクセシビリティと検索エンジン最適化(SEO)の効果を向上させます。
教育分野:教育用動画において、Tarsierは詳細な内容説明を提供し、学生の学習教材の理解を深めるのに役立ちます。
ソーシャルメディア:ソーシャルプラットフォームはTarsierを活用して動画コンテンツの自動キャプションを生成し、ユーザー体験を向上させることができます。
動画監視:セキュリティ監視分野において、Tarsierは動画ストリームを分析してリアルタイムの説明を生成し、セキュリティ担当者が潜在的な脅威を迅速に特定するのを支援します。
ロボット:特定のタスクに対する詳細な手順指示を生成します。
自動運転:車両が道路状況を認識し、意思決定を支援するのに役立ちます。
Tarsierモデルの最新バージョンであるTarsier2は、特にデータ量と多様性の面で顕著な改善が行われています。事前学習データは1100万から4000万の動画テキストペアに拡張され、モデルの学習能力が強化されました。さらに、Tarsier2は教師あり微調整フェーズにおいて細粒度の時間的整合性を導入し、動画キャプションの精度と詳細把握能力をさらに向上させました。直接選好最適化(DPO)トレーニングを通じて、Tarsier2は人間の選好により合致した動画キャプションを生成し、ハルシネーション生成の可能性を低減できます。
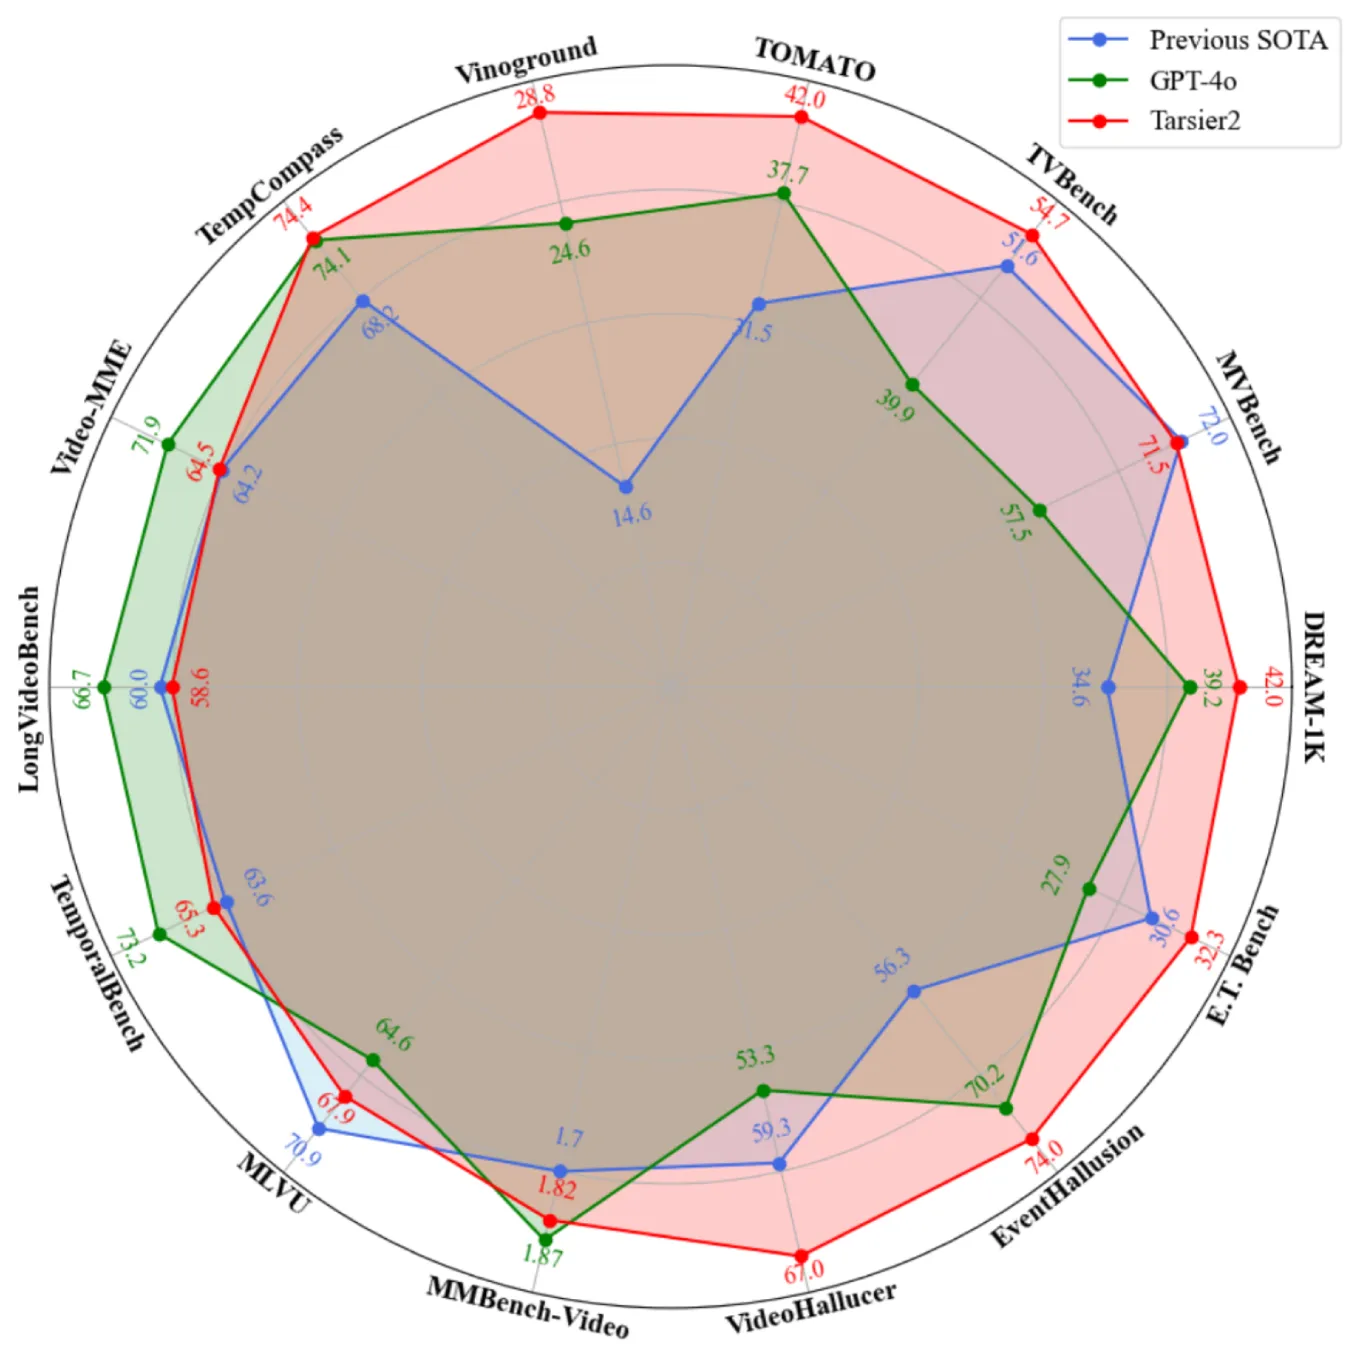
性能評価において、Tarsier2はDREAM-1Kベンチマークテストで優れた性能を発揮し、F1スコアでGPT-4oを2.8%、Gemini-1.5-Proを5.8%上回りました。15の公開ベンチマークテストにおいて、Tarsier2は新たな最高結果を達成し、動画質問応答、動画グラウンディング、ハルシネーションテスト、質問応答などの機能を網羅し、強力な汎用視覚言語モデルとしての汎用性を示しています。
動画キャプション生成以外にも、質問応答、グラウンディング、エンボディド・インテリジェンスなどのタスクにおいても強力な性能を発揮しています。
論文:https://arxiv.org/abs/2501.07888
Code: https://github.com/bytedance/tarsier
Dataset: https://huggingface.co/datasets/omni-research/DREAM-1K
Demo: https://huggingface.co/spaces/omni-research/Tarsier2-7b














