
 脚本プランナー▸
 AIアプリ
 AIニュース
Darwinモデル:材料科学・化学・物理学向けの大規模モデル
Darwinモデル:材料科学・化学・物理学向けの大規模モデル紹介
Darwinモデルは、自然科学分野(特に物理、化学、材料科学)のために設計された大規模言語モデル(LLM)であり、構造化された知識と非構造化された知識を統合することで、科学研究における言語モデルの有効性を向上させます。
Darwinの主な機能:
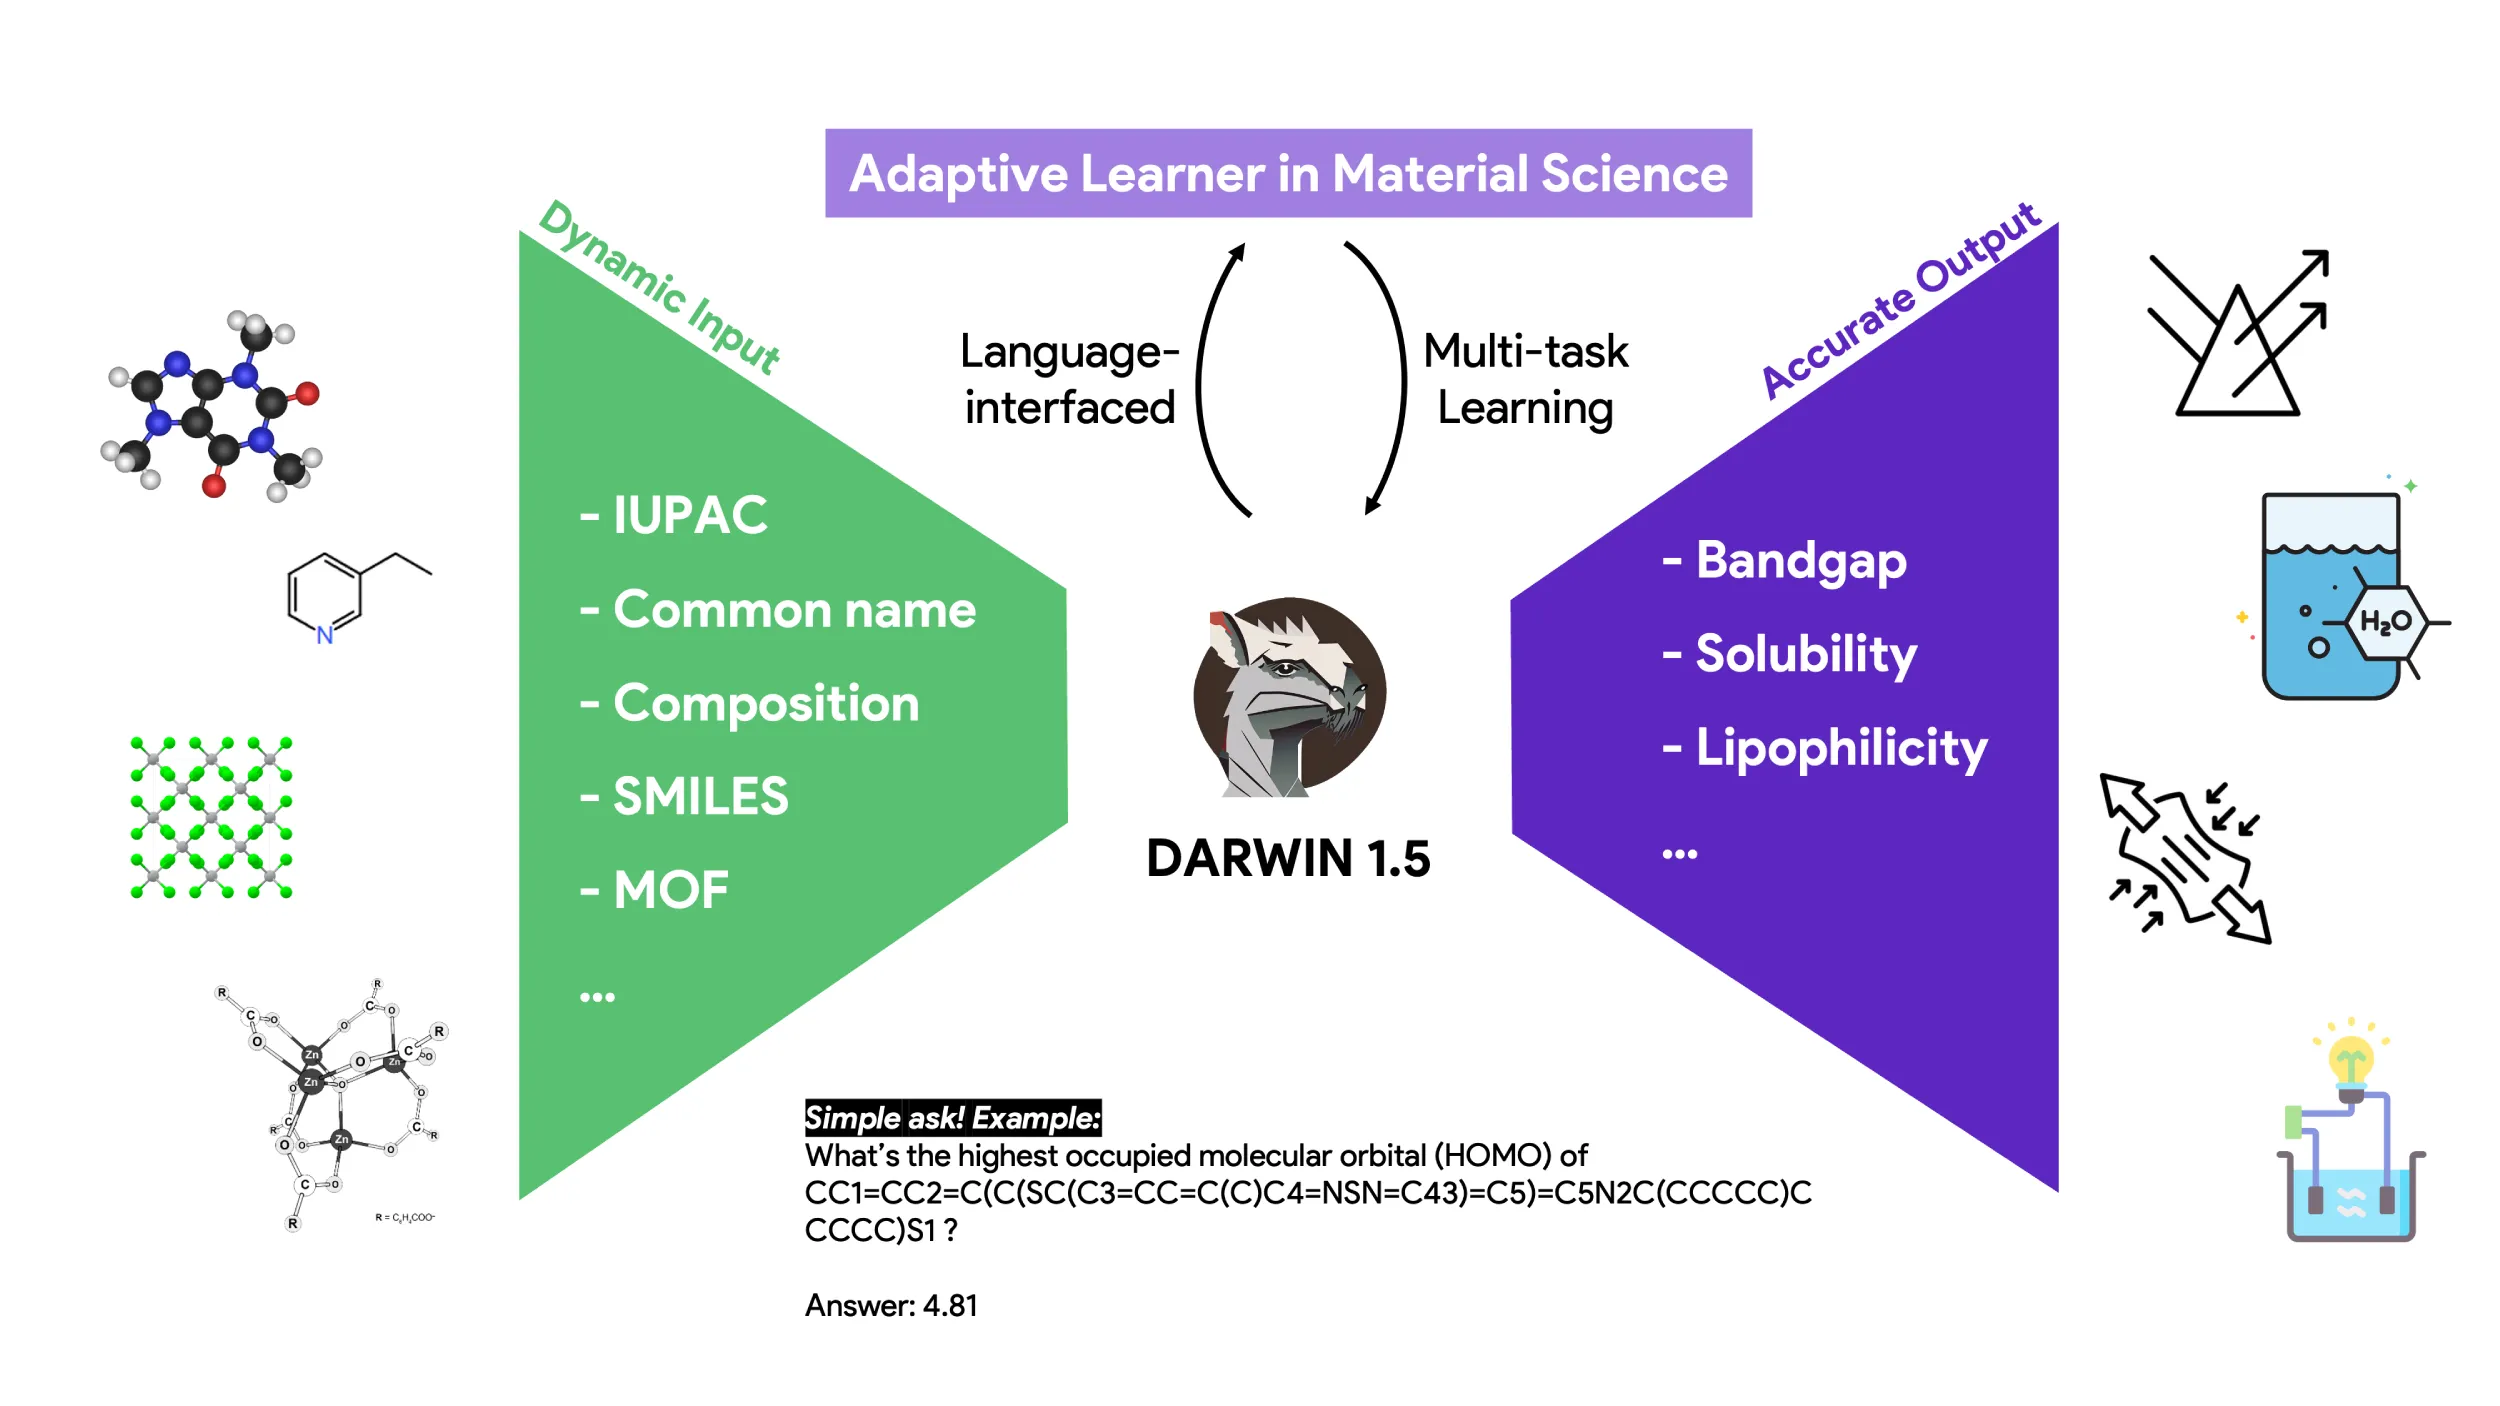
材料設計:Darwinモデルは新材料を自ら設計することができ、材料の特性や性能を分析し、異なる条件下でのその挙動を予測することで、材料の発見と開発を加速します。
科学的Q&A:このモデルは大規模な科学的Q&Aデータセットを統合しており、科学研究において正確かつ迅速に情報提供や解答を行い、研究者が必要な知識を素早く取得できるよう支援します。
データ分析:Darwinモデルは複雑な科学データを処理・分析し、データ内のパターンや傾向を識別することで、科学研究における意思決定プロセスをサポートします。
学際研究:強力な言語処理能力により、Darwinモデルは異なる学問分野間の協力を促進し、学際的な研究の進展を後押しします。
技術的特徴:
複数分野の融合:Darwinは物理、化学、材料科学など複数の分野の知識を統合し、学際的な複雑なタスクを処理することができます。
科学インストラクションデータ生成(SIG):科学テキストのインストラクションデータを自動生成することで、人手によるアノテーションや領域知識グラフへの依存を大幅に削減し、モデルの効率と精度を著しく向上させます。
マルチタスク学習:Darwinはマルチタスク学習戦略を採用し、科学タスク間の本質的な関連性を明らかにすることで、モデルの汎化能力とパフォーマンスを向上させます。
オープンソースと拡張性:DarwinはオープンソースのLLaMAモデルをベースに構築されており、コミュニティによる貢献と拡張をサポートし、将来的に新しい知識モジュールを柔軟に組み込むことができます。
モデル性能:
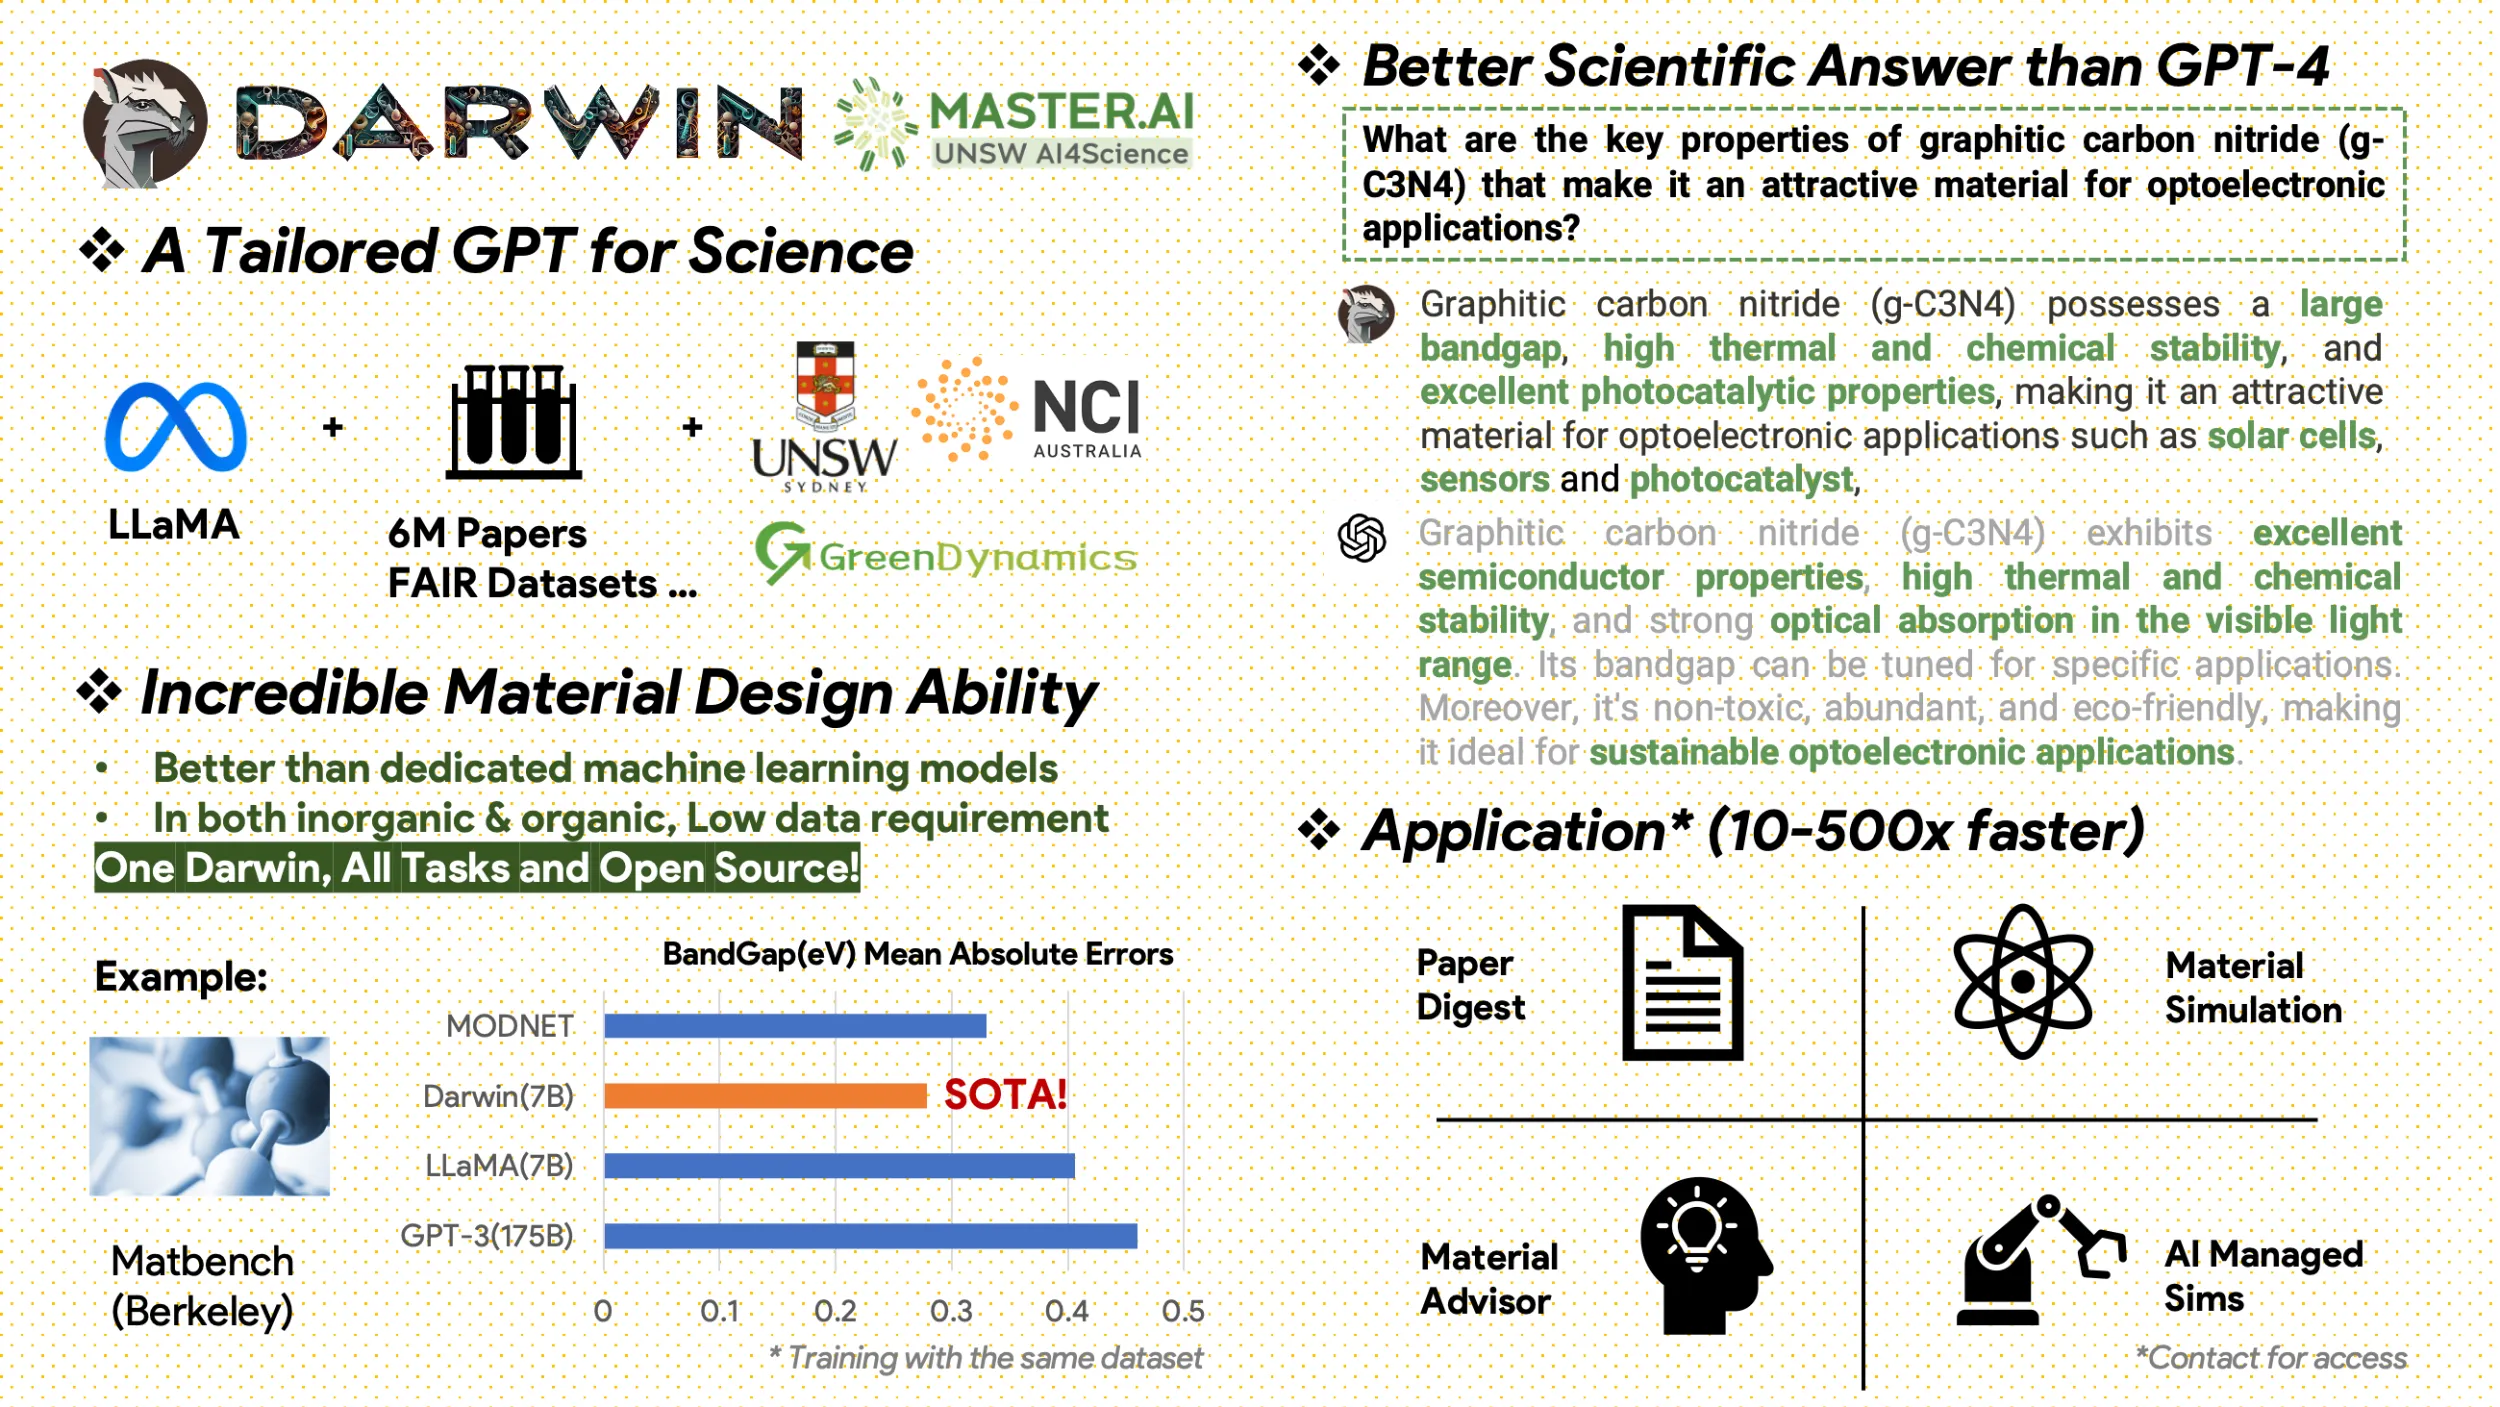
GPT-4を超える性能:科学的Q&Aおよび化学の問題解決タスクにおいて、Darwin 7BモデルはGPT-4やファインチューニングされたGPT-3.5を上回る性能を発揮します。
SOTA達成:MatBenchの材料科学タスクにおいて、Darwinはバンドギャップ予測や金属分類のタスクで最先端(SOTA)の成果を達成し、専門的な機械学習モデルをも上回りました。
二段階学習戦略:Darwin 1.5はQAファインチューニングとマルチタスク学習を通じて、材料特性予測タスクにおけるモデルの精度を大幅に向上させ、最大60%の改善を実現しました。
応用シナリオ:
文献レビューと分析:研究者が膨大な科学文献を素早く整理し、重要な情報を抽出するのを支援します。
実験設計の最適化:過去の実験データを分析し、実験パラメータの最適化に関する提案を提供します。
材料設計と予測:材料特性の予測、分類、逆設計をサポートし、新材料の発見を加速します。
教育支援:科学教育の知的アシスタントとして、パーソナライズされた学習指導や質疑応答を提供します。
Darwinモデルの最新バージョンであるDarwin 1.5は、材料科学分野における応用能力をさらに強化しました。このバージョンでは、より豊富な科学的Q&Aデータと材料科学タスクが統合され、材料特性の予測と発見におけるモデルの精度と効率が向上しています。さらに、Darwin 1.5は言語インターフェースファインチューニングフレームワーク(LIFT)を採用しており、複雑な科学問題を処理する際により効率的かつ柔軟に対応できます。
実際の応用において、Darwinモデルは材料設計にとどまらず、創薬や疾患診断などのバイオメディカル分野でも活用でき、その学際的な可能性を示しています。科学文献やデータセットとの深い統合を通じて、Darwinモデルは研究者により正確かつ精緻な科学的サポートを提供し、科学発見のプロセスを推進します。
Darwinモデルは、ニュー・サウス・ウェールズ大学(UNSW)のai4ScienceとGreenDynamics AIの共同開発によるオープンソースプロジェクトであり、科学分野における性能向上のためにLLaMAモデルの事前学習とファインチューニングに特化しています。その中核的な目標は、人工知能駆動の自動化手法によって科学発見のプロセスを加速し、クローズドソースAIモデルへの依存を減らすことです。
Darwinコードリポジトリ:https://github.com/masterai-eam/darwin















