脚本プランナー▸
 AIアプリ
 AIニュース
Firecrawl Extract:テキストプロンプトだけで任意のWebデータをスクレイピング
Firecrawl Extract:テキストプロンプトだけで任意のWebデータをスクレイピング紹介
Firecrawl Extractは、大規模言語モデル(LLM)の力を組み合わせ、ウェブページコンテンツからデータをインテリジェントに抽出し、Markdownや構造化JSONデータなど、さらなる処理に適した形式に変換します。これは、大量のウェブページデータをaiモデルの学習やデータ分析に必要とするシナリオに特に適しています。
Firecrawl Extractの主な特徴:
インテリジェント抽出:データ抽出のスキーマを定義するか、JSON Schemaを使用することで、ユーザーは必要なデータ構造を指定でき、Firecrawl Extractはこれらの指示に従って自動的にデータをクロールして解析します。
コーディング不要:ユーザーはシンプルなAPI呼び出しまたはグラフィカルインターフェースの設定により、複雑なクローラーコードを書くことなくデータ抽出を完了できます。
動的コンテンツ処理:ウェブサイトがJavaScriptで動的にコンテンツを読み込む場合でも、Firecrawlはこれらのデータをキャプチャし、データの完全性を保証します。
大規模クロール:複数のURLを同時にクロールすることをサポートし、大量のデータを必要とするプロジェクトに適しています。
APIとSDKの統合:Python SDK、Node SDKなどを提供し、開発者が自分のアプリケーションにFirecrawl Extract機能を容易に統合できるようにします。
LLM支援:LLMを活用してウェブページのコンテキストを理解し、非構造化データから重要な情報をより正確に識別して抽出します。
使いやすさ:例として示されたAPI呼び出しのように、シンプルなコマンドまたは呼び出しでデータ抽出プロセスを開始できます。
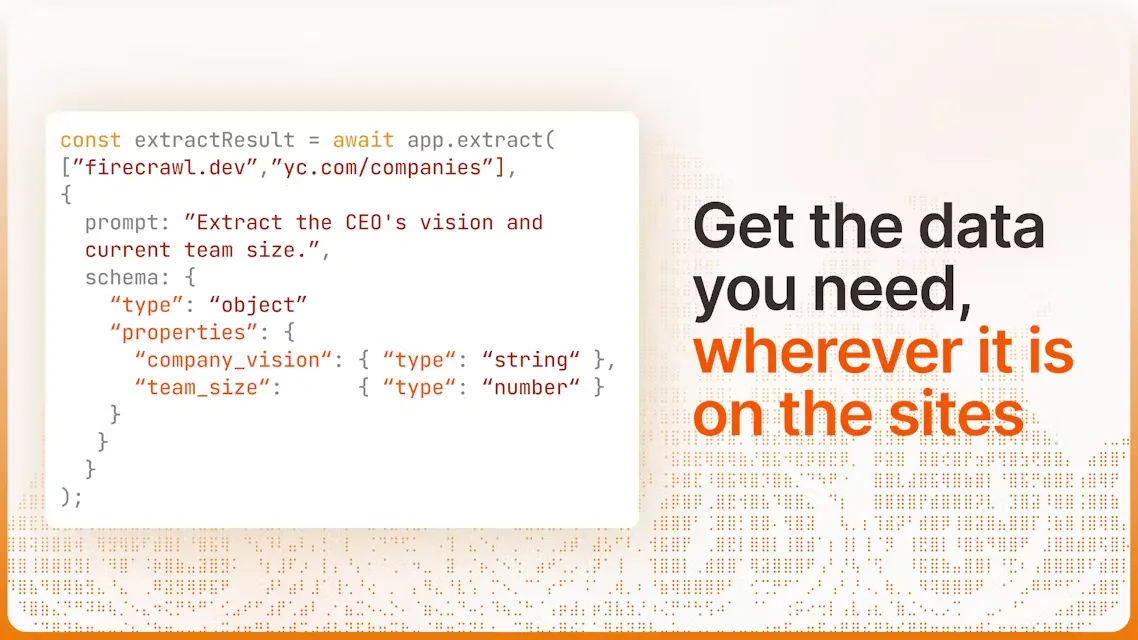
Firecrawl Extractの使用手順:
1. データ要件の定義:ウェブページから抽出するデータを明確にし、対応するデータスキーマを準備するか、定義済みのテンプレートを使用します。
2. API呼び出しまたはSDK統合:
APIを使用する際は、リクエストを構築し、対象URLとデータ抽出のスキーマを指定します。
Python SDKを使用する場合は、FirecrawlAppオブジェクトを初期化し、対応する抽出メソッドを呼び出して、URLと抽出指示を渡します。
サンプルコード(Python SDK):
from firecrawl.firecrawl import FirecrawlApp
app = FirecrawlApp(api_key="YOUR_API_KEY")
result = app.extract([ 'あなたのウェブサイトURL'], {
prompt: "特定のデータを抽出",
schema: { /* あなたのデータ構造を定義 */ }
})
3. 結果の取得:抽出が完了すると、Firecrawlは処理されたデータを返し、そのまま後続のデータ分析やモデル学習に使用できます。
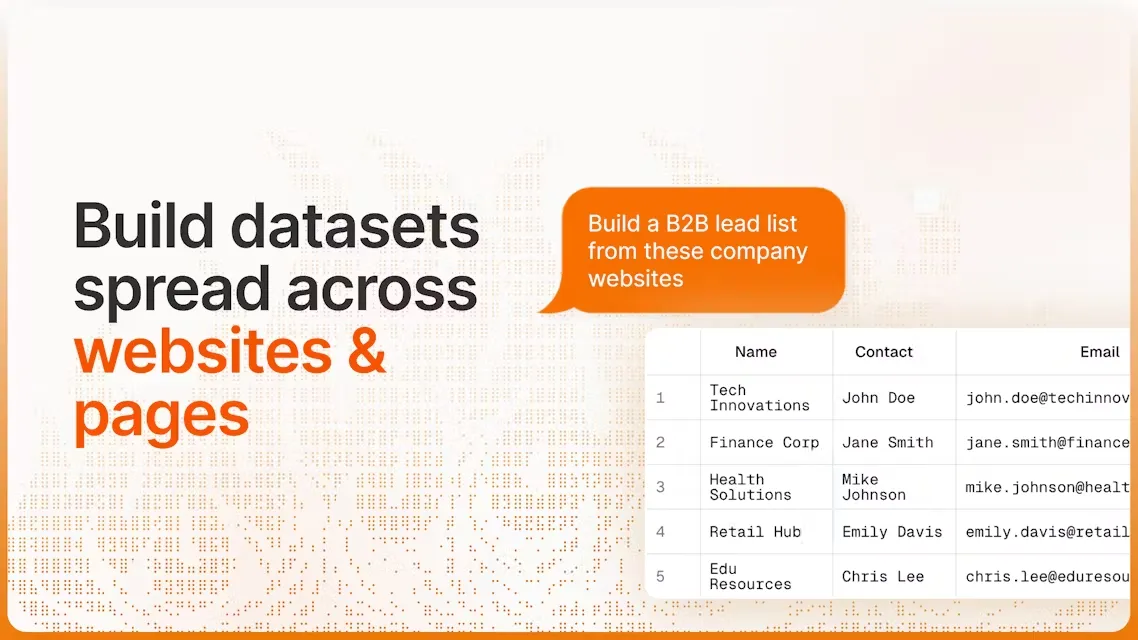
Firecrawl Extractの応用シナリオ:
Firecrawlは、リード情報のエンリッチメント、KYB自動化、ノーコードワークフローなど、さまざまな応用シナリオに適しています。Firecrawlが提供するサービスにより、ウェブサイトデータを大規模言語モデル(LLM)が使用するのに適した形式に変換することが簡単かつ効率的に行えます。
AIモデル学習:大規模言語モデルに豊富な学習データを提供します。
コンテンツ集約:コンテンツ要約やニュース集約サービスを迅速に構築します。
市場分析:競合他社のウェブサイトから価格や製品情報を抽出します。
データ研究:学術研究や商業研究のためにウェブ上の公開データを収集します。
Firecrawlの /extract エンドポイントは、あらゆるウェブサイトから構造化データを抽出できる強力なツールです。ユーザーはシンプルなAPI呼び出しだけで必要なデータを取得でき、手動でのクロールは不要です。FirecrawlのExtract機能により、隐蔽プロキシやレート制限などの一般的なウェブスクレイピングの課題にも容易に対処でき、データ抽出のスムーズな進行を保証します。