
 脚本プランナー▸
 AIアプリ
 AIニュース
TangoFlux:テキストtoオーディオ(TTA)効果音生成モデル
TangoFlux:テキストtoオーディオ(TTA)効果音生成モデル紹介
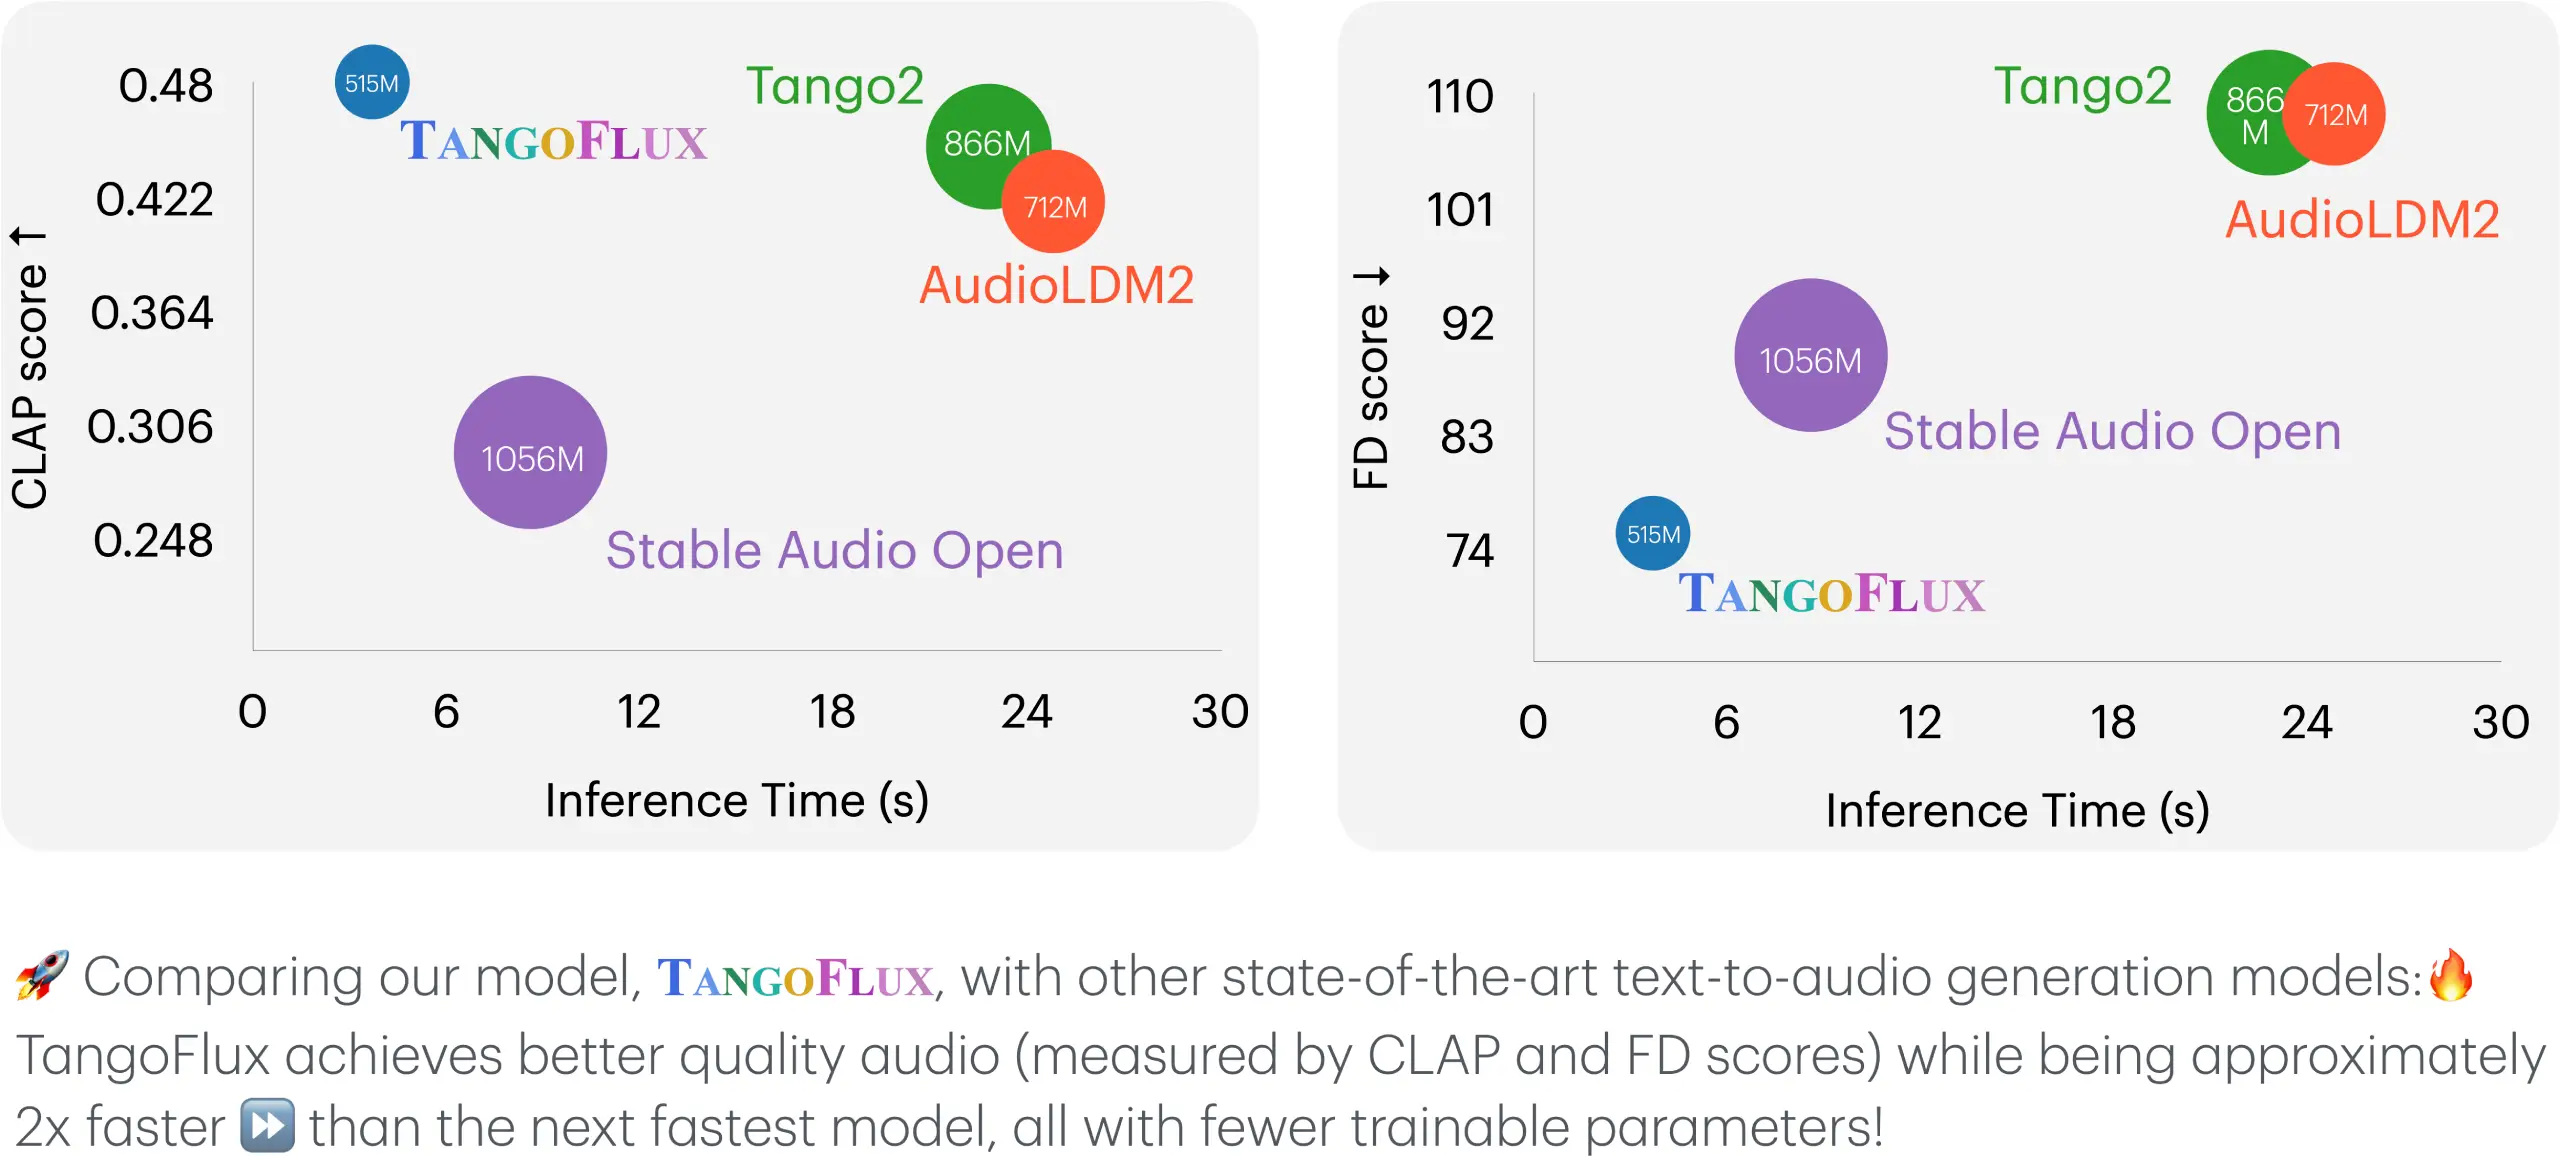
TangoFluxは、シンガポール科学技術デザイン大学(SUTD)とNVIDIAが共同で開発した高度なテキストtoオーディオ(TTA)生成モデルであり、約5.15億のパラメータを持ち、単一のA40 GPU上でわずか3.7秒で最大30秒の44.1kHzステレオオーディオを生成することができます。TangoFluxは、鳥の鳴き声や口笛、爆発音などの効果音だけでなく、音楽も生成することができます。
TangoFluxの技術原理
変分自己符号化器: VAEを使用して音声波形を潜在表現に符号化し、潜在表現から元の音声を再構築します。
テキストと時間長埋め込み: テキスト符号化と時間長符号化に基づき、生成される音声の内容と時間長を制御します。
FluxTransformerアーキテクチャ: Diffusion Transformer(DiT)とMultimodal Diffusion Transformer(MMDiT)を組み合わせて、テキストプロンプトの処理と音声生成を行います。
Flow Matching: 単純な事前分布から複雑な目標分布へのマッピングを学習し、サンプルを生成します。
CLAP-Ranked Preference Optimization: 反復的に生成された選好データペアに基づき、音声アラインメントを最適化します。
TangoFluxの主な機能
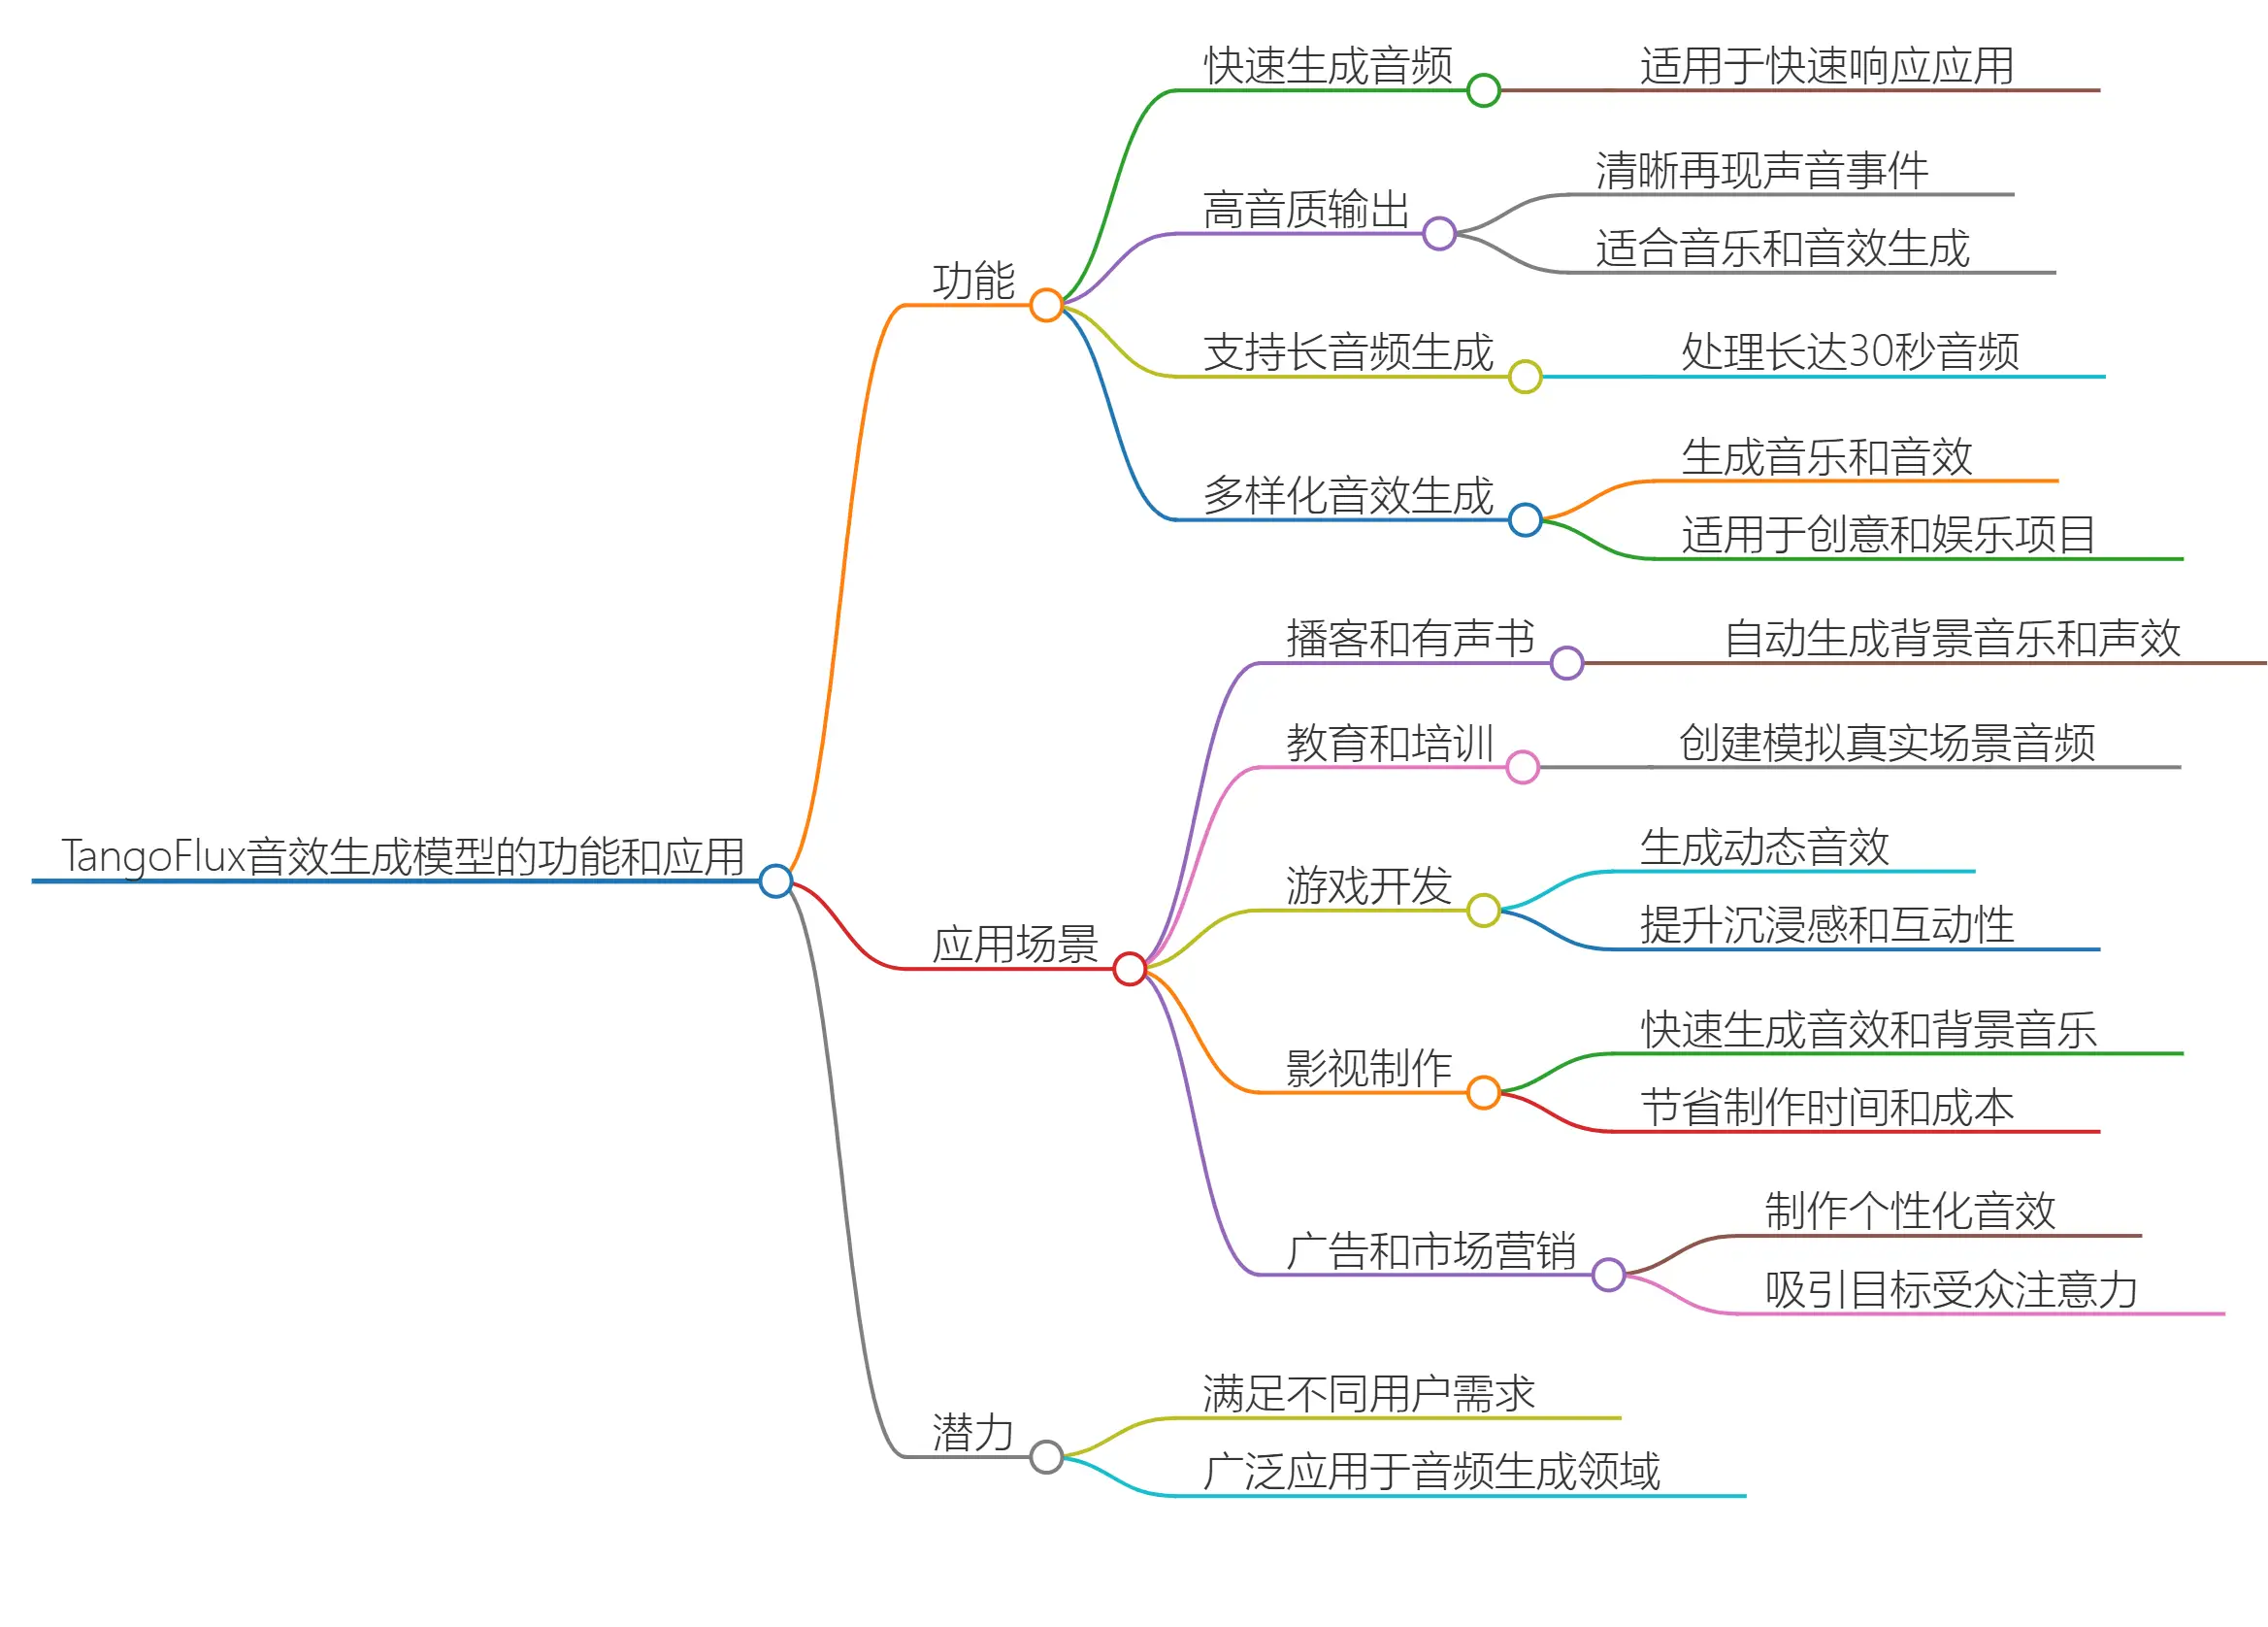
高速オーディオ生成:TangoFluxは極めて短い時間で高品質なオーディオコンテンツを生成でき、迅速な応答が必要なアプリケーションシナリオに適しています。
高音質出力:生成されるオーディオの品質が高く、様々な音事象を明瞭に再現できるため、音楽や効果音など多種多様なオーディオ生成に適しています。
長尺オーディオ生成のサポート:このモデルは最大30秒のオーディオ生成タスクを処理でき、長尺のオーディオコンテンツ制作に適しています。
多様な効果音生成:TangoFluxは音楽を生成できるだけでなく、鳥の鳴き声、口笛、爆発音などさまざまな効果音も生成でき、多くのクリエイティブやエンターテインメントプロジェクトに適しています。
TangoFluxの応用シナリオ
映画・ゲームオーディオ制作:TangoFluxは脚本やシーン記述に基づいてリアルな効果音、サウンドトラック、ナレーションを迅速に生成でき、制作サイクルの短縮やコスト削減、作品オーディオ品質の向上、ゲームのインタラクティブ性と没入感の強化を実現します。
音楽制作のインスピレーション源:クリエイターの設定に基づき多様な音楽フレーズを生成し、制作のボトルネック突破を支援、音楽の革新を推進し、より新颖な作品をもたらします。
VRとAR体験の強化:仮想環境とユーザーインタラクションに基づきリアルタイムでリアルなオーディオを生成し、VRゲームの没入感を高め、ARアプリケーションの仮想と現実の融合に対する認識を強化します。
広告・マーケティングオーディオの革新:広告のアイデアとブランドイメージに基づき独自のオーディオを生成し、消費者の関心を引き、共感を呼び起こし、ブランドの知名度と評価を高めます。
TangoFluxのプロジェクトリソース
プロジェクト公式サイト: tangoflux.github.io
arXiv技術論文: https://export.arxiv.org/pdf/2412.21037
TangoFluxはCLAP-Ranked Preference Optimization(CRPO)フレームワークも採用しており、選好データの反復生成と最適化によってモデルのオーディオアラインメント能力を向上させています。この手法により、生成されるオーディオは品質が保証されるだけでなく、ユーザーの好みや入力テキストの意図にもよりよく合致します。さらに、TangoFluxの学習は非 proprietary データセットに基づいており、モデルがよりオープンでアクセスしやすくなり、さらなる研究と応用を促進しています。
TangoFluxは主にマルチメディアコンテンツ制作、例えば映画、ゲーム、広告、ビデオ制作におけるBGM、音響効果、ナレーションの生成に応用され、制作効率の向上とコスト削減を実現します。その技術原理には変分自己符号化器(VAE)、テキストと時間長の埋め込み、FluxTransformerアーキテクチャなどが含まれ、これらの技術が相まって高効率なオーディオ生成能力を支えています。
関連情報:















