
 脚本プランナー▸
 AIアプリ
 AIニュース

ExtractPDF:PDFファイルから画像・テキスト・フォントを抽出
ExtractPDF:PDFファイルから画像・テキスト・フォントを抽出紹介
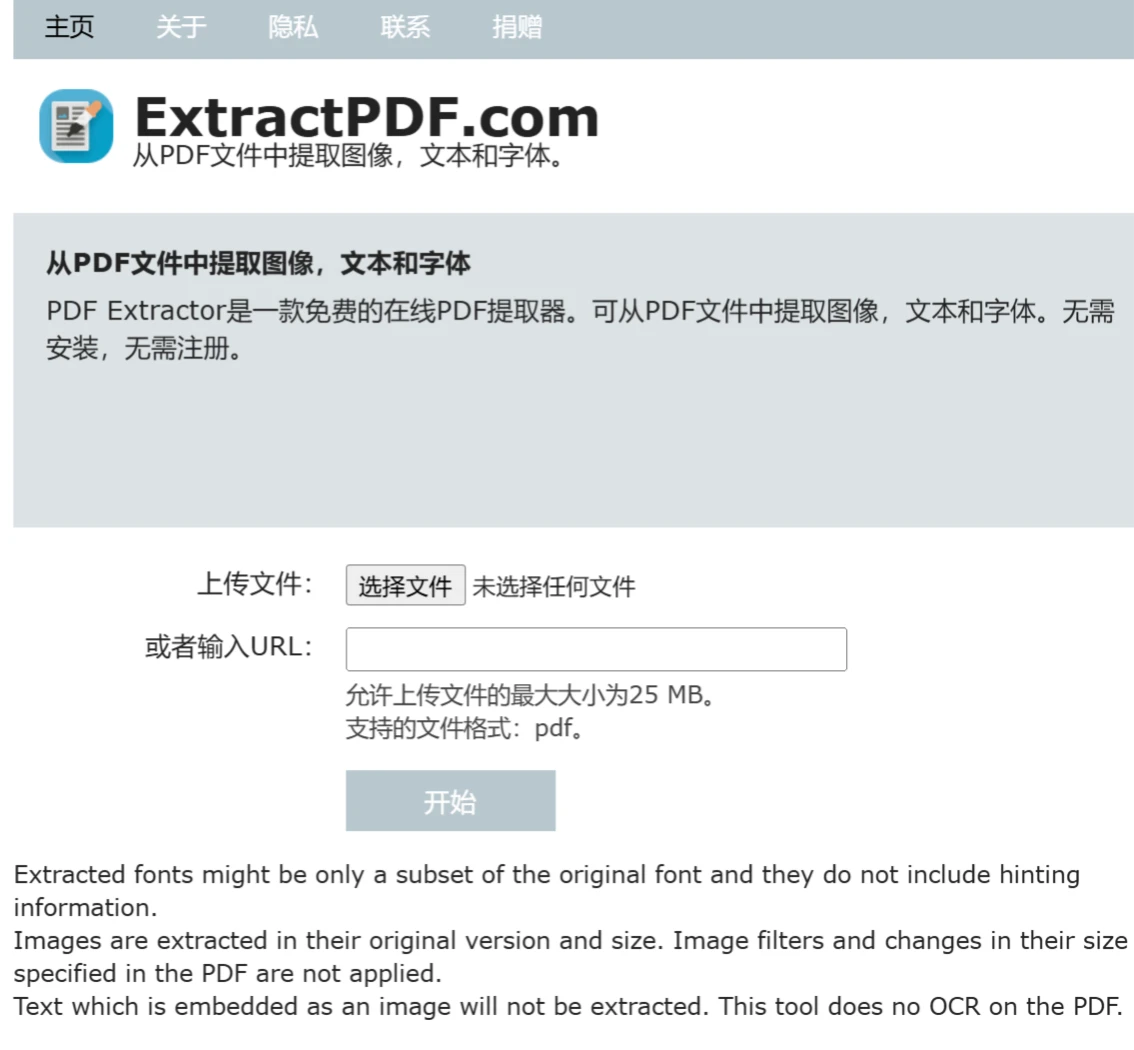
ExtractPDFは、PDFファイルからテキストや画像を抽出するために設計されたオンラインツールです。ソフトウェアやプラグインをダウンロードする必要はなく、ブラウザで直接機能を利用できます。このサイトはシンプルで使いやすいインターフェースを提供しており、ユーザーは必要な情報を迅速かつ効率的に抽出できます。
ExtractPDFの機能:
テキスト抽出:PDFファイルからプレーンテキストの内容を抽出します。
画像抽出:PDFファイルから画像を抽出し、ユーザーは単一または複数の画像を保存できます。
対応言語:ExtractPDFは英語、中国語、日本語など複数言語のテキスト認識をサポートしています。
ExtractPDFの使い方:
使い方は非常に簡単で、PDFファイルをアップロードするか、PDFのURLを入力して送信するだけです。
サイトにアクセス:ブラウザを開き、ExtractPDFの公式サイトにアクセスします。
PDFファイルをアップロード:PDFファイルをアップロードするか、PDFのURLを入力します(ExtractPDFでアップロード可能な最大ファイルサイズは25MBで、対応しているファイル形式はPDFです)。
抽出を開始:「開始」ボタンをクリックすると、ExtractPDFがファイルの処理を開始し、必要な内容を抽出します。
結果をダウンロード:抽出完了後、ユーザーは抽出したテキストや画像を直接ダウンロードできます。
ExtractPDFの利点:
インストール不要:ソフトウェアをダウンロードする必要はなく、ブラウザだけで使用できます。
多言語サポート:ExtractPDFは中国語を含む複数言語に対応しています。
注意点:
抽出されるフォントは元フォントのサブセットである場合があり、ヒンティング情報は含まれていません。
画像は元のバージョンとサイズで抽出されます。PDF内で指定された画像フィルターやそのサイズ変更は適用されません。
画像として埋め込まれたテキストは抽出されません。このツールはPDFに対してOCRを実行しません。
ExtractPDFのよくある質問:
1、抽出された画像がPDFファイル内の見た目と異なるのはなぜですか?
このツールはPDFファイルから元の画像を抽出します。PDF内で行われた切り取り、回転、色反転などの画像処理はすべて無視されます。
2、PDFファイルから抽出したフォントにグリフが欠落しているのはなぜですか?
フォントがPDFファイルに埋め込まれる際、PDFファイルには出現するすべての文字のグリフのみが含まれます。PDFファイルに文字「P」が含まれていない場合、抽出されたフォントファイルにも文字「P」は含まれません。
3、PDFから抽出したフォントファイルを使用するとレイアウトが奇妙に見えるのはなぜですか?
PDFファイルには通常、フォント仕様ファイル(.pfmファイルや.afmファイル)がありません。これはPDFリーダーがこれらの情報を必要としないためです。フォント仕様ファイルが欠落しているため、抽出したフォントファイルを正常に使用できません。
4、PDFからフォントファイルを抽出することは合法ですか?
PDFからフォントファイルを抽出することは合法です。ただし、抽出したフォントファイルを使用する場合は、フォントの作成者から許可を得る必要があります。
しかし、フォントメトリクスデータが欠落しているため、抽出したフォントファイルは通常そのまま使用することはできません。これは主にPDFファイルで使用されているフォントを識別するために役立ちます。
PDFファイルから抽出したフォントの使用を希望する場合、それに伴う法的なリスクを理解しておく必要があります。













