
 脚本プランナー▸
 AIアプリ
 AIニュース
VIMI:制御可能な人物動画生成モデル
VIMI:制御可能な人物動画生成モデル紹介
VIMI大モデルは、商湯科技が発表した世界初の制御可能な人物動画生成aiGC製品です。VIMI大モデルは商湯のSenseNova大規模モデル技術に基づいており、動作動画、アニメーション、音声、テキストなど多様な駆動要素によって人物画像駆動し、画面の品質が時間の経過とともに低下したり歪んだりすることがなく、ターゲットの動作と一致する人物動画を生成することができます。可制御性に加え、Vimiは人物生成の安定性、動画生成時間の長さにおいても、他の大規模モデルによるAI動画生成の限界を突破し、分単位の単一ショット人物動画を安定的に生成することを可能にしました。
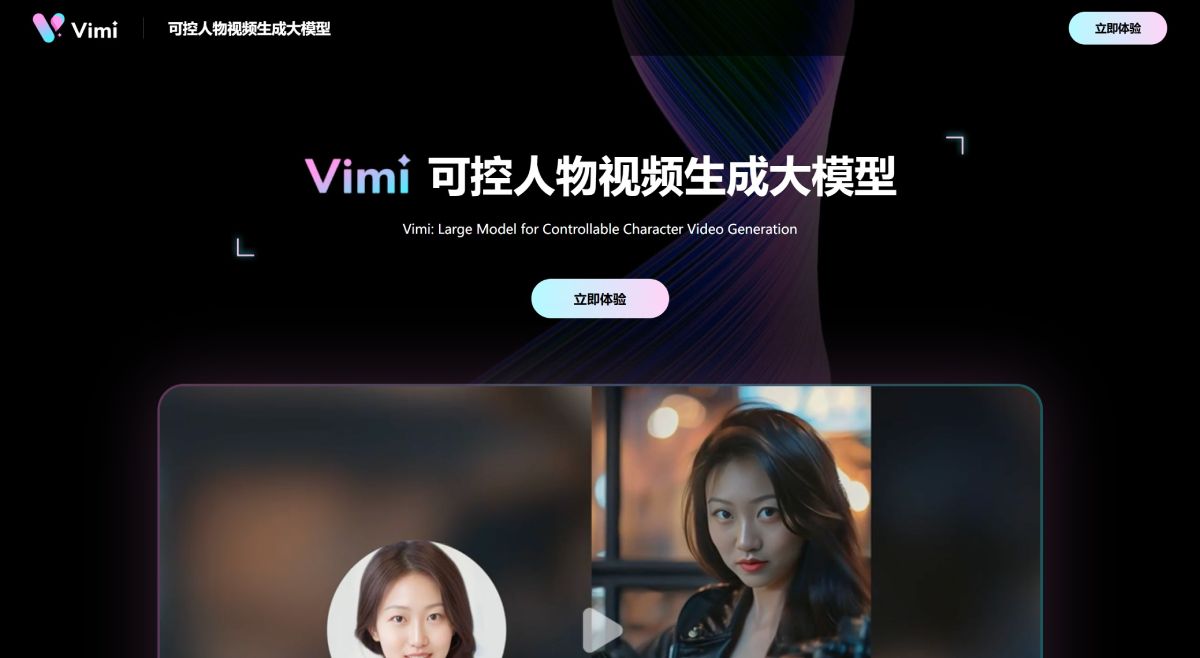
VIMI大モデルは精准な人物表情制御を実現できるだけでなく、写真の中の人物の上半身の自然な肢体動作を制御し、人物に合った髪型、衣装、背景変化を自動生成することもできます。同時に光と影の変化も合理的に生成でき、人物動作と視覚效果を流暢かつ自然にし、画面が調和のとれた美しいものになります。安定した制御可能な人物動画生成製品です。
VIMI大モデルの機能特徴:
制御可能な人物:VIMIは動画の中の人物の表情と肢体動作を精确に制御し、ターゲットの動作と高度に一致した動画コンテンツを生成することができます。微妙な表情変化から複雑な全身動作まで、VIMIはすべて正確に捉えて再現することができます。
多様な制御方式:VIMIは人物動画、アニメーションパラメータ、音声テキストなど、多様な制御入力方式を提供しています。これにより、ユーザーは異なる入力方法で動画生成を駆動し、より豊かで多様な動画を創造することができます。
分単位の単一ショット:分単位の単一ショット人物動画生成をサポート
合理的な動画シーン生成:VIMIは人物自体の表現だけでなく、人物の髪型、衣装、背景などの要素の補完、および光と影の変化のサポートを含む、合理的な動画シーンを生成することもできます。これにより、VIMIが生成する動画は人物表現が自然なだけでなく、シーン全体も調和のとれた統一感のあるものになります。
長尺動画の安定生成:VIMIは最大1分間の単一ショット人物動画を生成することができ、画面の効果は安定しており、時間の経過とともに劣化したり歪んだりしません。これは顕著なブレークスルーです。
VIMI大モデルの応用シーン:
VIMIは主にCエンドユーザー向けで、チャット、歌、ダンスなど多様なエンターテイメントインタラクションシーンに適用されます。
エンターテインメント創作:デジタル分身やポートレート動画、さまざまな面白い人物スタンプの生成など、広範なユーザーのエンターテインメント創作ニーズに応えます。
映像制作:映像作品に高品質な人物動画素材を提供し、制作コストと時間を削減します。
アニメーション制作:アニメーターがスケルトンを使用して動作を生成することをサポートし、アニメーション制作効率を向上させます。
Vimi大モデルは2024年の世界人工知能会議(WAIC)で発表され、会議展示の最高栄誉である「鎮館之宝」に選ばれました。Vimi大モデルは1分以上の単一ショット人物動画を生成することができ、画面の効果は時間とともに品質が低下したり歪んだりせず、人物の動きに応じて環境シーンを調整し、レンズの角度変化や髪の揺れをシミュレートし、リアルな視覚効果を提供します。
Vimiは完全に一般ユーザーに開放されます。ユーザーは異なる角度のハイビジョン人物写真をアップロードするだけで、デジタル分身と異なるスタイルのポートレート短編動画を自動生成することができます。自撮り好きのユーザー向けに、Vimiはチャット、歌、ダンスなど多様なエンターテイメントインタラクションシーンをサポートしています。















