
 脚本プランナー▸
 AIアプリ
 AIニュース
Emote Portrait Alive:静止画から歌う動画を生成
Emote Portrait Alive:静止画から歌う動画を生成紹介
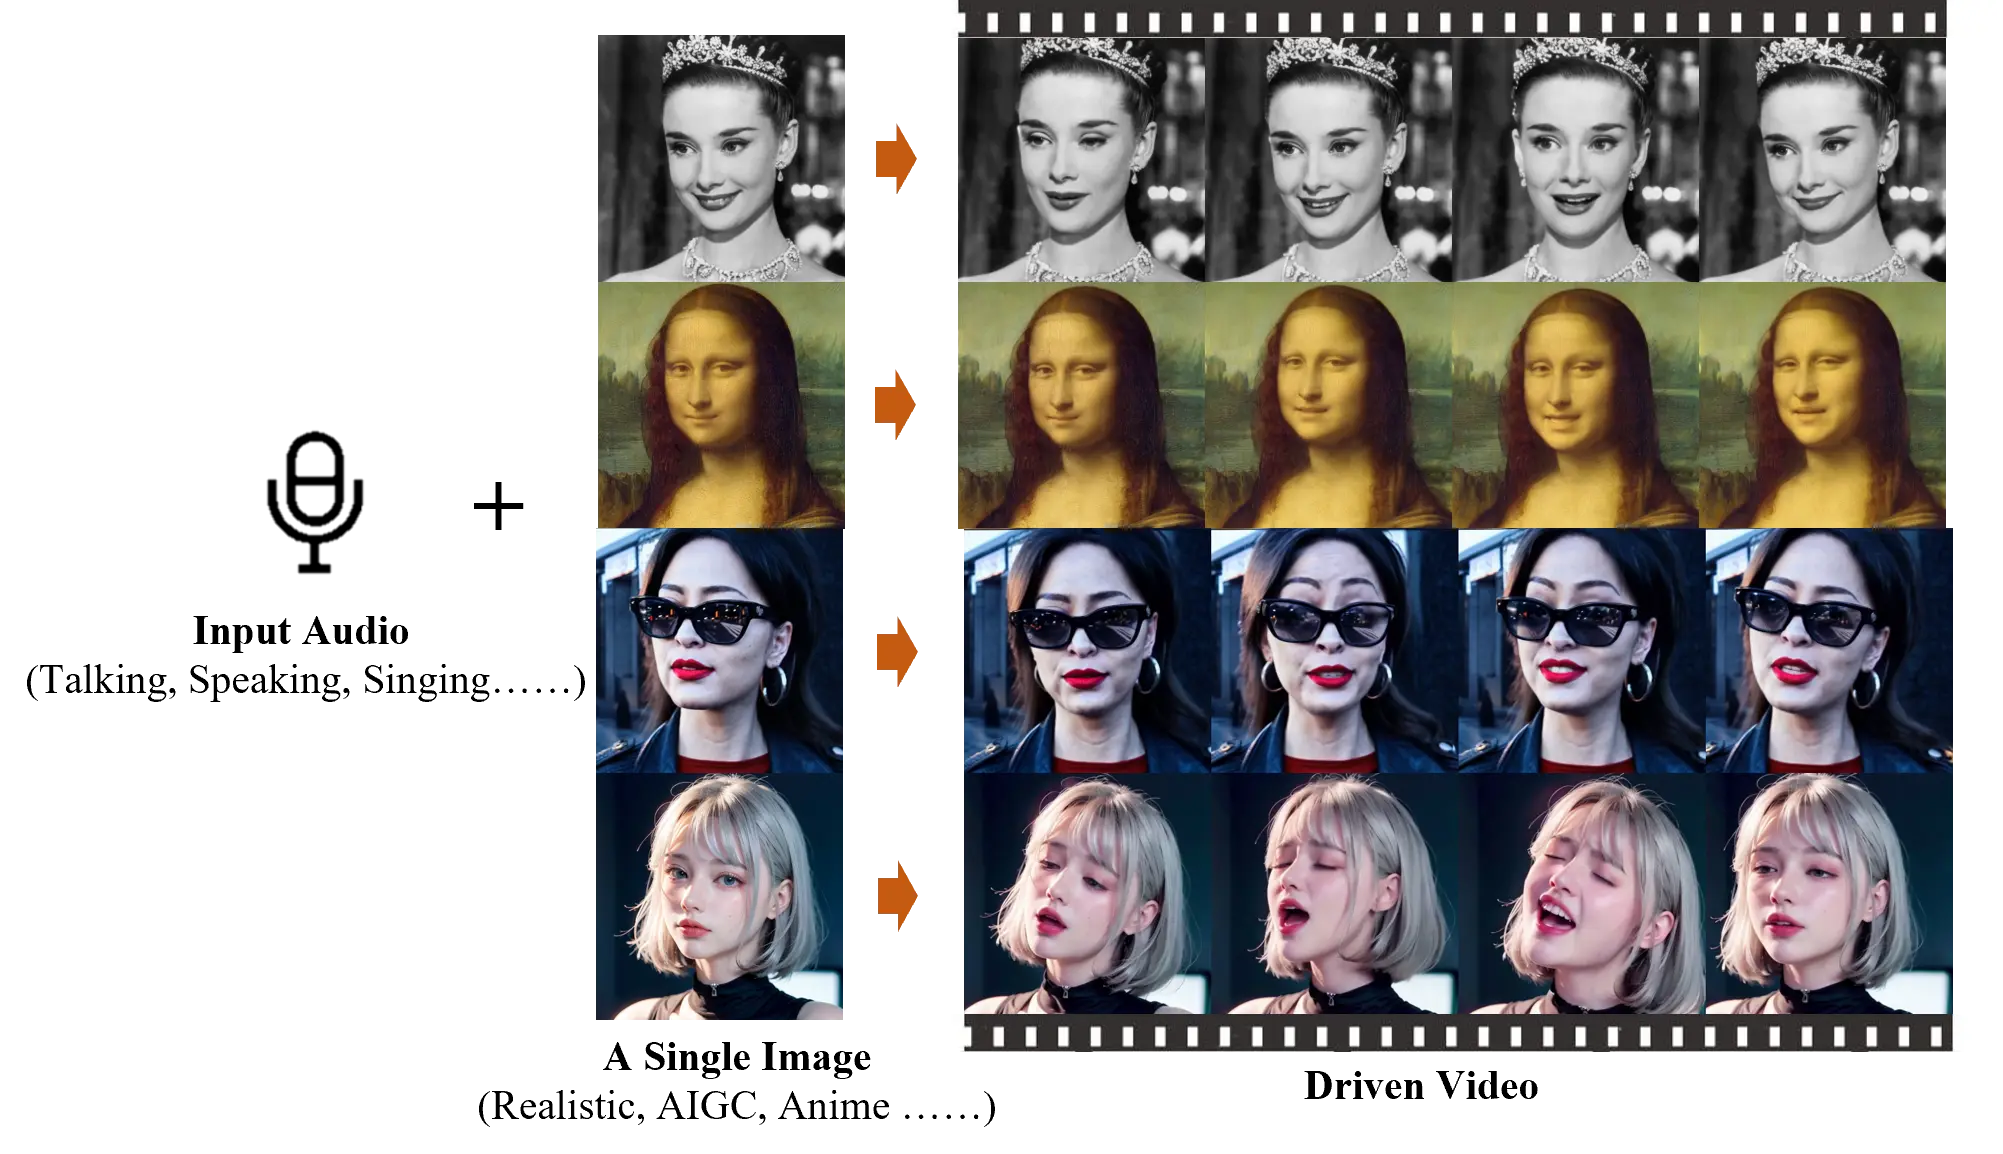
Emote Portrait Aliveは、Alibabaが発表したEMOで、音声駆動型のAIポートレート動画生成フレームワークです。1枚のリファレンス画像と音声オーディオ(話す声や歌など)を入力するだけで、Emote Portrait Aliveは表情豊かな顔の動きと多様な頭部のポーズを持つ音声ポートレート動画を生成します。写真の中の人物が音声コンテンツに合わせて自然に口を動かして話したり歌ったりし、表情や頭部のポーズも非常にリアルです。また、入力された音声の長さに応じて任意の長さの動画を生成することができます。
Emote Portrait Aliveの機能と特徴:
音声駆動型の動画生成:EMOは入力された音声(話す声や歌など)に基づいて直接動画を生成でき、事前に録画された動画クリップや3D顔モデルに依存しません。
高い表現力とリアルさ:生成された動画は高い表現力を持ち、微妙な微表情を含む人間の表情の細部や、音声リズムに合わせた頭部の動きを捉え再現します。
シームレスなフレーム遷移:動画フレーム間の遷移を自然かつスムーズにし、顔の歪みやフレーム間の揺れを防止することで、動画全体の品質を向上させます。
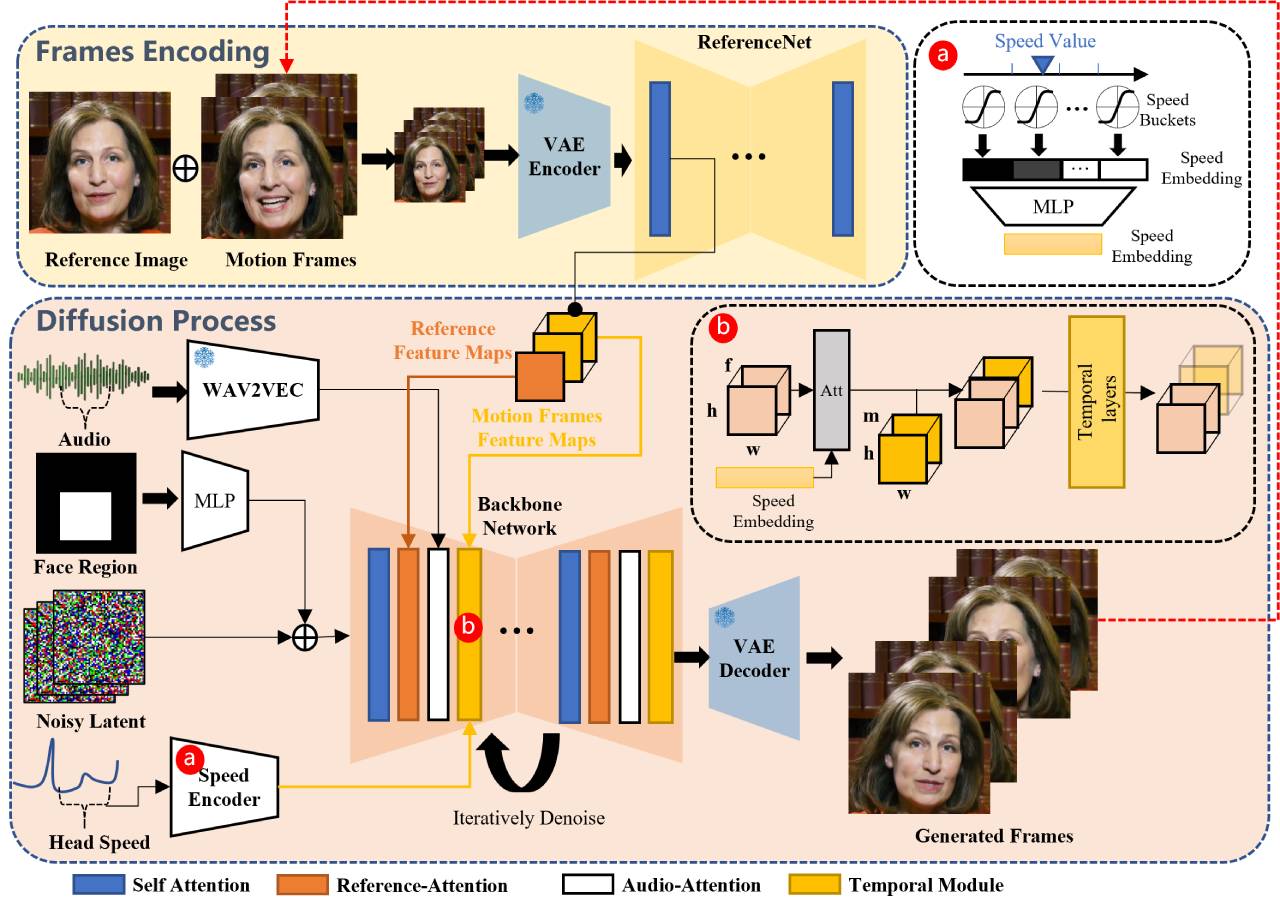
アイデンティティの保持:FrameEncodingモジュールを通じて、EMOは動画生成プロセス中にキャラクターのアイデンティティの一貫性を維持し、キャラクターの外観が入力リファレンス画像と一致することを保証します。
安定した制御メカニズム:速度コントローラーや顔領域コントローラーなどの安定した制御メカニズムを採用し、動画生成プロセス中の安定性を高め、動画の崩壊などの問題を防ぎます。
柔軟な動画時間:入力音声の長さに基づいて任意の長さの動画を生成でき、ユーザーに柔軟な創作スペースを提供します。
言語やスタイルを横断:学習データセットには中国語や英語、リアル、アニメ、3Dスタイルなど多様な言語とスタイルが含まれており、EMOは異なる文化や芸術スタイルに対応できます。
Emote Portrait Aliveの応用シナリオ:
歌唱動画の生成:人物のポートレート写真と歌唱オーディオを入力すると、EMOは音声と同期し表現力豊かな歌唱動画を生成します。
話し声動画の生成:歌に限らず、話し声のオーディオも処理し、音声と同期した話し声動画を生成できます。
多言語サポート:複数の言語の音声入力に対応し、異なる言語の人物ポートレート動画を生成できます。
スタイルを横断した応用:アニメや3Dモデルなど異なるスタイルのポートレート画像と音声を組み合わせて、特定のスタイルを持つ動画コンテンツを生成できます。
Emote Portrait Aliveは歌の音声入力だけでなく、さまざまな言語の話し声オーディオにも対応しています。さらに、Emote Portrait Aliveは古い写真や絵画、3Dモデル、AI生成コンテンツなどをリアルな動きと生命感を吹き込んだ動画に変換することもできます。














