
 脚本プランナー▸
 AIアプリ
 AIニュース
ToucanTTS:7,000以上の言語をカバーする大規模多言語モデル
ToucanTTS:7,000以上の言語をカバーする大規模多言語モデル紹介
ToucanTTSは、最先端の音声合成のためのツールキットであり、シュトゥットガルト大学自然言語処理研究所(IMS)によって開発された、超包括的なテキスト読み上げ(Text-to-Speech, TTS)モデルです。ToucanTTSは、7,000以上の言語をカバーする大規模な多言語モデルです。
ToucanTTSは多言語対応だけでなく、マルチスピーカー音声合成機能も備えており、異なる話者のリズム、アクセント、イントネーションを模倣することができます。
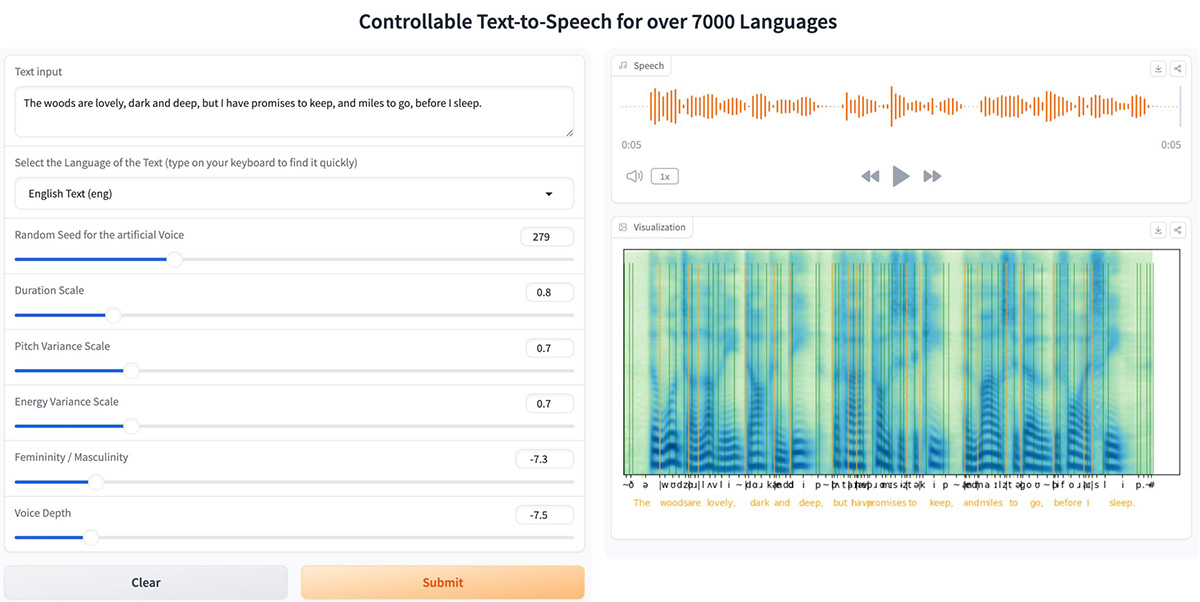
また、音声デザイン、スタイルクローニング、多言語音声合成、人手編集による詩朗読など、さまざまなアプリケーションのインタラクティブなデモを提供し、その汎用性と強力な性能を示しています。
ToucanTTSの機能:
多言語サポート:ToucanTTSは7,000以上の言語の音声を合成でき、利用可能な最多言語対応のTTSモデルとなっています。この広範な言語サポートは、幅広い国際的なユーザーに応えます。
マルチスピーカー音声合成:ToucanTTSはマルチスピーカー音声合成が可能で、ユーザーは異なる話者のリズム、アクセント、イントネーションを模倣できます。スタイルの多様性や音声のカスタマイズを必要とするアプリケーションにとって、特に有用です。
人間と機械の協調編集:ToucanTTSは、ユーザーが特定の要件に合わせて合成音声をカスタマイズでき、文学研究や詩朗読の課題に特に有用です。
アーキテクチャ:ToucanTTSはFastSpeech 2アーキテクチャをベースに構築され、PortaSpeechに触発された改良が加えられています。正規化フローに基づくPostNetと、接続主義的時間分類(CTC)とスペクトログラム再構成で学習された独立したアライナーを含み、高品質で自然な音声合成を実現します。
調音表現:ToucanTTSのユニークな機能は、入力として音素の調音表現を使用することです。多言語データを活用することで、低リソース言語の音声合成の品質と可用性を向上させています。
インタラクティブなデモ:ToucanTTSは、音声デザイン、スタイルクローニング、多言語音声合成、人手編集による詩朗読など、さまざまなアプリケーションのインタラクティブなデモを提供します。これらのデモは、このツールキットの汎用性と堅牢性を示しています。
学習と推論:このツールキットは、依存関係のインストール、ストレージの設定、事前学習済みモデルのダウンロード、学習パイプラインの実行に関する包括的な手順を提供します。事前学習済みモデルからの微調整とゼロからの学習の両方をサポートしています。
ToucanTTSの特徴:
多言語およびマルチスピーカーサポート:大規模な多言語事前学習モデルを通じて、7,000以上の言語をカバーする多言語音声合成をサポートします。マルチスピーカー音声合成を実現し、話者間でリズム、アクセント、イントネーションなどの韻律をクローン化します。
人間と機械の協調編集:詩朗読や文学研究など、合成音声に対する人間と機械の協調編集を可能にします。
インタラクティブなデモ:大規模多言語音声合成、話者を横断するスタイルクローニング、音声デザイン、人手編集による詩朗読のインタラクティブなデモを提供します。
アーキテクチャとコンポーネント:主にFastSpeech 2アーキテクチャに基づき、PortaSpeechに触発された正規化フローに基づくPostNetなどの修正が加えられています。CTCで学習された自己完結型アライナーと、さまざまなアプリケーション向けのスペクトログラム再構成を含みます。多言語モデル、アライナー、埋め込み関数、ボコーダ、埋め込みGANの事前学習済みモデルを提供します。
使いやすさ:完全にPythonとPyTorchで構築されており、シンプルで初心者に適していると同時に、強力であります。
調音表現:IMS Toucanシステムは音素の調音表現を入力として受け取り、多言語データが低リソース言語にも恩恵をもたらすようにします。
ToucanTTSの応用:
多言語アプリケーションの音声合成:ToucanTTSは7,000以上の言語をサポートしており、世界的なカスタマーサービスプラットフォーム、教育ツール、母語話者以外向けのアクセシビリティ機能など、多言語アプリケーションの作成に非常に有益です。
音声デザインとカスタマイズ:マルチスピーカー音声合成機能により、バーチャルアシスタント、オーディオブック、パーソナライズドマーケティングメッセージなど、さまざまな用途向けのカスタマイズされた音声を作成できます。
人間と機械の協調編集:この機能は、文学研究や詩朗読の課題で、特定の文体要件を満たすために音声出力を正確に制御する必要がある場合に特に有用です。
ToucanTTSの使用方法:
簡単な手順でToucanTTSを使い始めることができます。
1、GitHubからダウンロード
GitHubからコードをダウンロードします。git clone https://github.com/2noise/ToucanTTSでToucanTTSをダウンロードします。
2、依存関係のインストール
始める前に、必要なパッケージがインストールされていることを確認してください。torchとToucanTTSが必要です。まだインストールされていない場合は、pipコマンドでインストールできます。
3、必要なライブラリのインポート
スクリプトに必要なライブラリをインポートします。torch、ToucanTTS、およびIPython.displayのAudioが必要です。
4、ToucanTTSの初期化。ToucanTTSクラスのインスタンスを作成し、事前学習済みモデルを読み込みます。
5、テキストの準備。音声に変換するテキストを定義します。<YOUR TEXT HERE>を任意のテキストに置き換えます。
6、音声の生成。inferメソッドを使用してテキストから音声を生成します。use_decoder=Trueを設定してデコーダーを有効にします。
7、オーディオの再生
IPython.displayのAudioクラスを使用して、生成されたオーディオを再生します。サンプリングレートを24,000 Hzに設定し、自動再生を有効にします。
8、スクリプトの完了
ToucanTTSのGitHubリンク:https://github.com/DigitalPhonetics/IMS-Toucan
オンラインデモリンク:https://huggingface.co/spaces/Flux9665/MassivelyMultilingualTTS
データセットリンク:https://huggingface.co/datasets/Flux9665/BibleMMS














