
 脚本プランナー▸
 AIアプリ
 AIニュース
Hedra:人物写真を歌わせ、話させる
Hedra:人物写真を歌わせ、話させる紹介
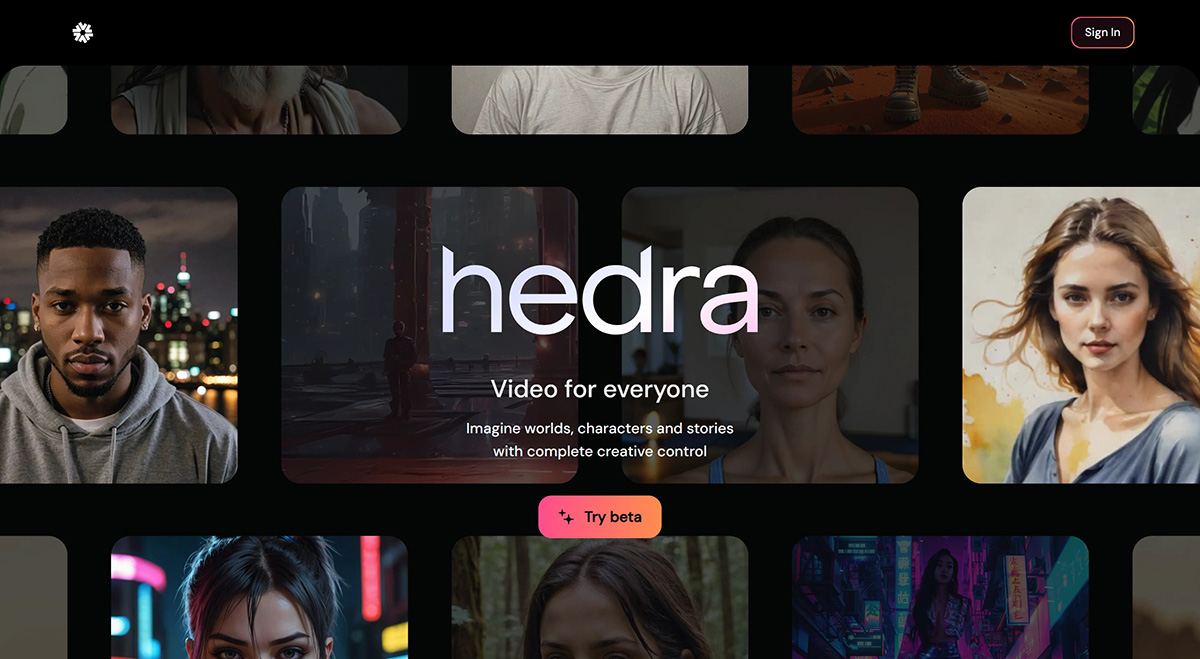
Hedra Labs は Character-1 の研究プレビュー版を公開しました。任意の人物写真と音声をアップロードするだけで、個人の話す・歌う映像を生成できる動画を作成できます。つまり、テキストと画像から話す・歌う動画を生成する便利なツールであり、口の動き・表情・姿勢と音声内容を一致させることができます。
Hedra はデスクトップとモバイルデバイスで利用でき、無制限の長さ(プレビュー中は30秒までオープン)で利用可能です。表現力豊かな会話、歌唱、ラップキャラクターに対応し、姿勢や表情も非常に自然です。
Hedra の主な機能:
テキストと画像からの生成:Character-1 は、テキストと画像から話す・歌う動画を生成することができます。
無制限の長さ:オープンプレビュー期間中、Character-1 は無制限の長さの動画生成をサポートし、最長30秒まで対応します。
高効率:60秒の入力から90秒の動画を生成できます。
表情の同期:生成された動画内の人物の表情と口の動きが音声内容と一致します。
多様なキャラクター:Character-1 は表現力と制御性を備えたキャラクター動画の生成をサポートします。
仮想世界の構築:Hedra は Worlds 機能のリリースも計画しており、ユーザーが自分の仮想世界を構築できるようにします。
創作コントロール:Hedra は完全なクリエイティブコントロールを提供し、ユーザーが世界・キャラクター・物語を思い描くことを可能にします。
Hedra の使い方:
1、音声またはテキストプロンプトをアップロード:テキスト読み上げが直接利用でき、現在6種類の音声が用意されています。人物に話させたいテキストを入力または貼り付け、プリセットの音声を選択するか、音声ファイルを直接アップロードすることもできます。
2、アバター画像をアップロード:アバター画像は自分の画像をアップロードできるほか、プロンプトを入力して自動生成することもできます。現時点では英語のみ対応し、中国語はサポートされていません。
3、生成。
関連情報:












