
 脚本プランナー▸
 AIアプリ
 AIニュース

VASA-1:写真を動画に変換する
VASA-1:写真を動画に変換する紹介
一枚のポートレート写真+音声オーディオ=リアルタイム生成による超リアルな話す顔動画。正確なリップシンク、リアルな顔の動き、自然な頭部の動作を実現します。VASA-1はMicrosoft Research Asiaが開発した最先端の人工知能技術であり、1枚の静止画像と1つの音声オーディオをリアルな会話顔アニメーションに変換することができます。この技術は、音声と唇の動きの精密な同期に加え、数多くの顔の微細な表情や自然な頭部の動きを捉えることで、豊かな表情とダイナミックな顔表情を持つ映像の生成を実現しています。
VASA-1は、1枚の静止画像と音声ファイルを組み合わせることで、ダイナミックな顔表情と頭部の動作を持つ映像を生成し、画像の中の人物がまるで「生きている」かのように見せかけます。この技術は、AIで生成された人物画像だけでなく、アメリカ大統領などの実際の写真にも使用可能で、それらを目を動かし、話させることができます。
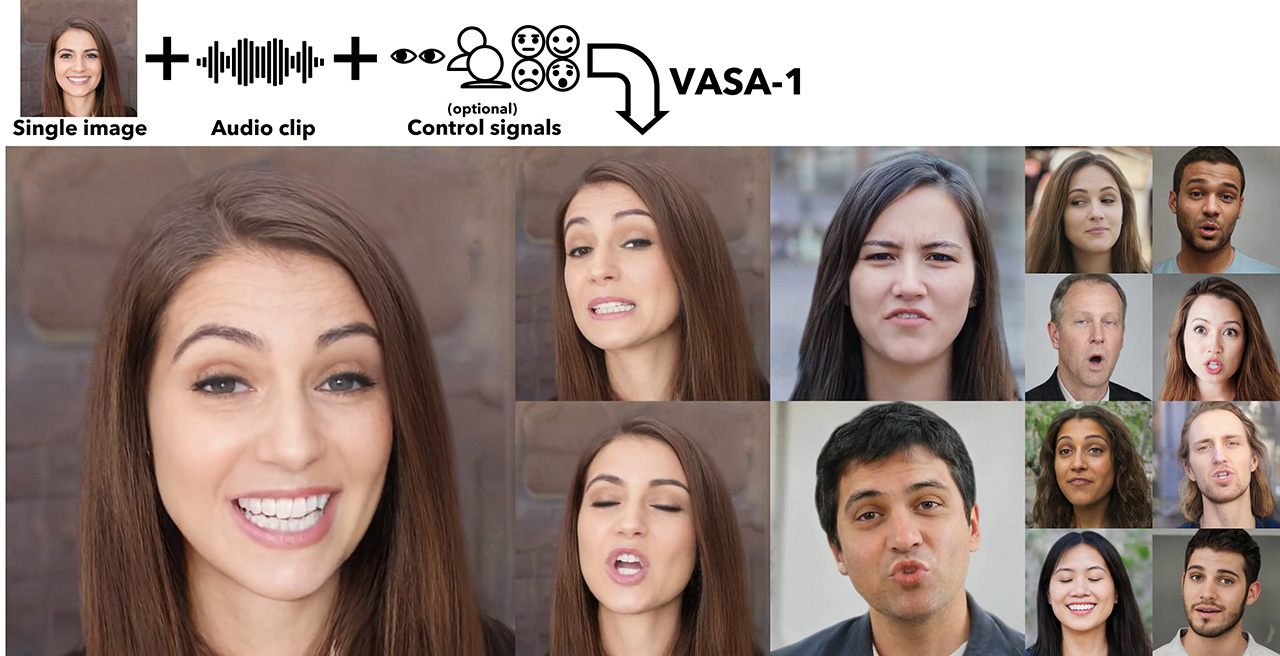
VASA-1の主な機能と特徴:
リアルなリップシンク:VASA-1は、入力された音声オーディオと精密に同期した唇の動きを生成し、高度にリアルな話す効果を提供します。
分離能力:VASA-1は、唇の動き、表情、目の視線方向などの顔の動きの特徴を独立して制御する能力を持っています。
セキュリティと監視:VASA-1技術は、セキュリティや監視の分野にも応用可能です。
顔の潜在空間の構築:顔の潜在空間を構築することで、ダイナミックな顔表情と頭部の動作を生成します。
高い画像生成品質と高速な処理速度:VASA-1は、高品質な画像生成と高速な処理速度を兼ね備えた、リアルなリアルタイムの話す顔を生成します。
3D技術による顔特徴点の補助:Microsoftはさらに3D技術を活用して顔の特徴点を補助的にマーキングし、追加の損失関数を設計しました。これにより、VASA-1は高品質な顔映像を生成できるだけでなく、顔の3D構造を効果的に捉え、再現することが可能となっています。
VASA-1技術は、高度なディープラーニングアーキテクチャと複数の最先端技術の応用により、リップシンク、豊富な顔表情、分離能力、セキュリティ・監視アプリケーション、高い画像生成品質と高速処理、そして顔の3D構造の効果的な捕捉と再現を含む、高度にリアルな音声駆動型の会話顔アニメーションを実現しています。
VASA-1は革新的なAIツールであり、静止画像や絵画と音声ファイルを組み合わせることで、最終的にリアルな映像を生成します。このプロセスにはほとんど人工的な痕跡がなく、生成された映像は非常に自然に見えます。研究者は、他のすべてのモデルと同様にVASA-1も現時点では髪などの非剛体要素を適切に処理することはできないと認めていますが、全体的な効果は他の同種のモデルよりも優れています。
VASA-1の強力な能力は潜在的なリスクももたらします。特に、ディープフェイク映像の作成に悪用される可能性があり、そのような映像は実在の人物をリアルに模倣し、真偽の区別を困難にする恐れがあります。Microsoft Research AsiaはVASA-1を公開する前に慎重な姿勢を取っており、オンラインのデモ、API、製品、または関連する実装の詳細を一切公開していません。これは技術の悪用を防ぐためであり、悪意のある者がVASA-1を不正目的に利用することを防ぐ方法を積極的に研究しています。












