
 脚本プランナー▸
 AIアプリ
 AIニュース
CogVideo:テキスト記述から動画を生成
CogVideo:テキスト記述から動画を生成紹介
CogVideoは、現在最大の汎用領域テキスト対動画生成事前学習モデルであり、94億のパラメータを含んでいます。CogVideoは、事前学習済みのテキスト対画像生成モデル(CogView2)をテキスト対動画生成モデルに効果的に活用し、マルチフレームレートの階層的学習戦略を採用しています。
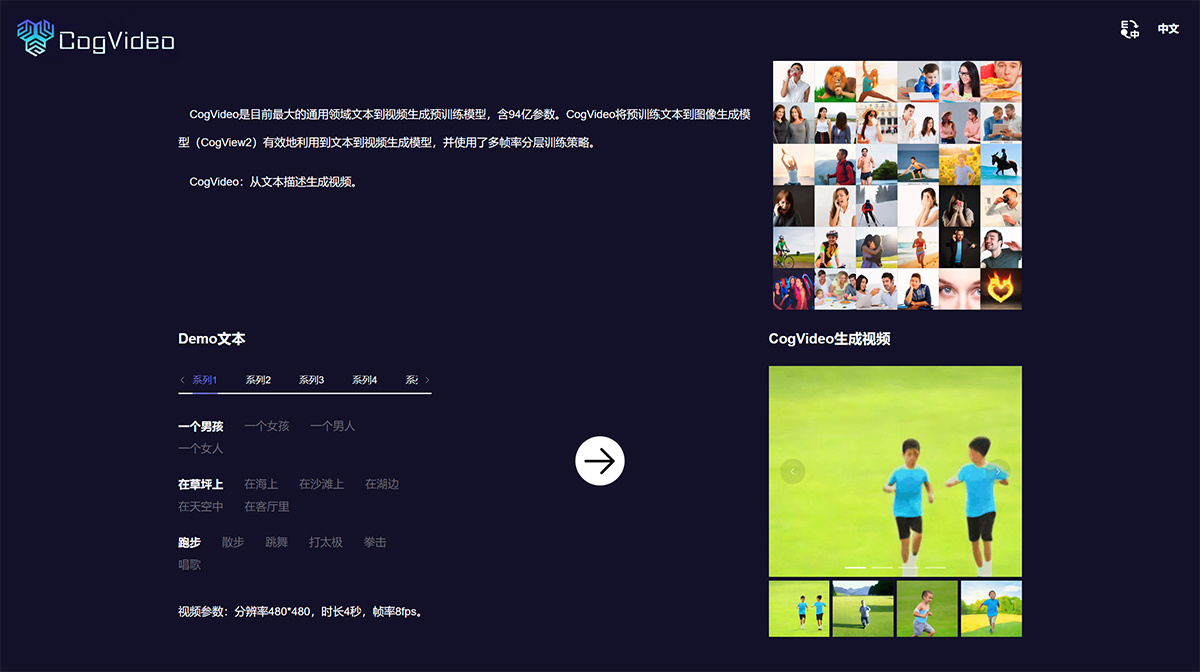
CogVideoは、清華大学とBAaiの唐杰チームによって提案されたオープンソースの事前学習済みテキスト対動画生成モデルであり、GitHub上で大きな注目を集めています。このモデルのコア技術は、ディープラーニングアルゴリズムとモデルアーキテクチャに基づいており、テキスト記述を生き生きとしたリアルな動画コンテンツに変換することができます。
CogVideoはマルチフレームレートの階層的学習戦略を採用し、事前学習済みのテキスト-画像生成モデルCogViewを継承することで、テキストから動画への効率的な変換を実現しています。さらに、CogVideoは高度な動的シーン構築機能も備えており、ユーザーが提供する詳細なテキスト記述に基づいて3D環境やアニメーションを生成することができます。同時に、CogVideoはテキスト生成画像の事前学習をテキスト生成動画に効率的に微調整し、高価な完全な事前学習を最初から行うことを回避しています。
CogVideoの学習は主にマルチフレーム階層的生成フレームワークに基づいており、まずCogView2を通じて入力テキストから数フレームの画像を生成し、その後、フレーム補間によってフレームレートを向上させて全体的な動画シーケンスの生成を完了します。この学習戦略により、CogVideoは生成過程における変化の強度を制御する能力を獲得し、テキストと動画のセマンティクスの整合性を向上させています。このモデルは94億のパラメータを使用し、現在最大の汎用領域テキスト対動画生成事前学習モデルの一つです。
CogVideoは中国語入力に対応するだけでなく、研究者や開発者が使用・カスタマイズしやすい詳細なドキュメントやチュートリアルも提供しています。そのオープンソース性と使いやすさにより、マルチモーダル動画理解の分野において重要な応用価値を持っています。さらに、CogVideoの出現は、動画生成分野におけるAI技術の大きな進歩を示しており、将来の創作に颠覆的な想像の余地を提供しています。
総じて、CogVideoは強力なテキスト生成動画モデルとして、事前学習モデルを効果的に活用し、高品質な動画を生成することができます。ただし、動画生成の過程においてはいくつかの課題にも直面しています。例えば、テキスト-動画データセットの稀少性や弱い相関性は、モデルが複雑な動作のセマンティクスを理解する上での障害となっており、これらはさらなる研究と改善が必要です。















