
 脚本プランナー▸
 AIアプリ
 AIニュース
DiffusionGPT:LLM駆動のテキストto画像生成システム
DiffusionGPT:LLM駆動のテキストto画像生成システム紹介
DiffusionGPTは、バイトダンスが開発したLLM驱動のテキストから画像を生成するオールインワンシステムで、異なる入力プロンプトに対して高品質な画像を生成するために特別に設計されています。その主な目標は、入力プロンプトを解析し、最適な結果を生成するモデルを特定することであり、高い汎用性、効率的な利用、そして利便性を備えています。
DiffusionGPTの優れた点は、複数の分野の專門画像生成モデルを統合している点です。その後、LLMを使用してこれらの画像生成モデルと接続し、LLMがさまざまなテキストプロンプトを処理・理解できるようにします。最後に、理解した情報に基づいて最も適切な画像モデルを選択し、画像を生成します。これにより、GPT-4のようにチャットを通じて画像を描画することが可能になります...
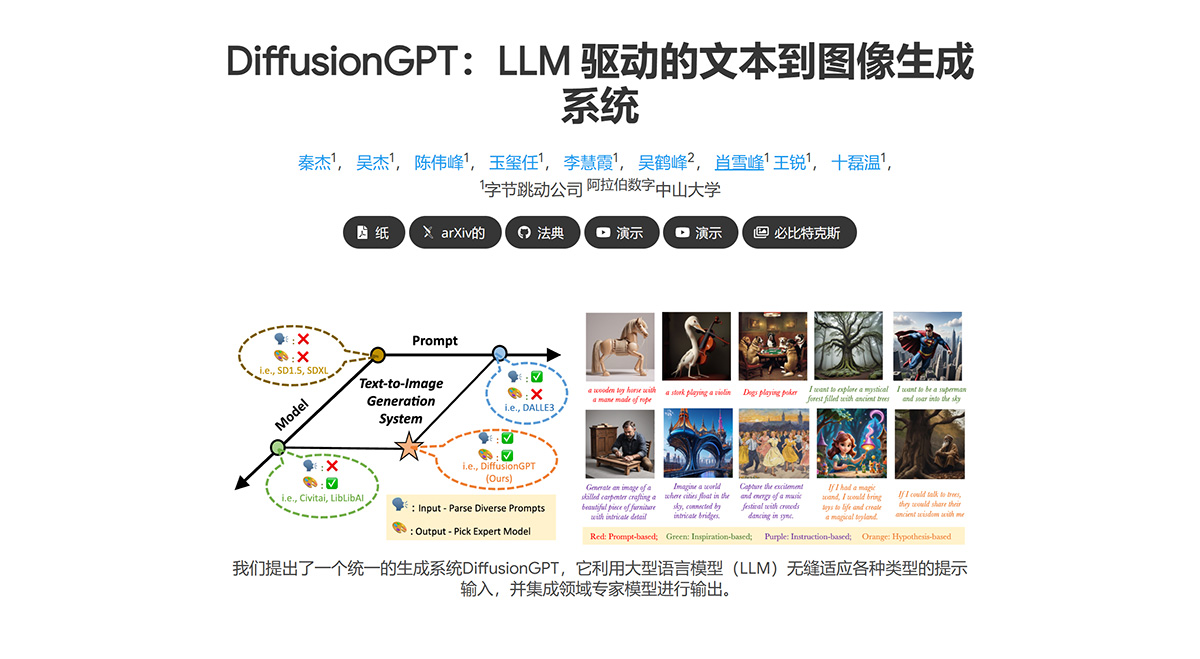
DiffusionGPTの主な特徴:
1、多様なテキストプロンプト処理:DiffusionGPTは、具体的な指示、抽象的なインスピレーション、複雑な仮説など、さまざまな種類のテキストプロンプトを理解し処理することができます。
2、複数の分野專門モデルの統合:システムは複数の分野の画像拡散モデルを統合しており、各モデルはその特定の分野で專門的な画像生成能力を持っています。这类模型は、特定の分野の画像生成、例えば自然風景、人物ポートレート、芸術作品などに焦点を当てています。
これは、システムが通常の画像を生成するだけでなく、特定のスタイルやタイプの画像、例えば特定のアーティストのスタイル、漫画スタイル、写真技術などを模倣するなど、より特定的で複雑な画像生成タスクも処理できることを意味します。
3、大規模言語モデル駆動:DiffusionGPTは、ユーザー入力のテキストプロンプトを解析・理解するために大規模言語モデル(LLM)を使用します。このプロセスは、他のLLMベースのシステム(GPT-4など)がテキストを処理する方法に似ていますが、特に画像生成のための指示や記述の理解に応用されます。
4、適切な画像モデルの智能選択:テキストプロンプトの理解に基づき、DiffusionGPTは最も適切な画像生成モデルを智能的に選択して画像を生成することができます。これには、正しいモデルの選択だけでなく、ユーザーのニーズを最よく満たすように生成パラメータを調整することも含まれます。
5、高品質な画像出力:テキストプロンプトと最適な生成モデルを正確にマッチングさせることで、DiffusionGPTはユーザーのニーズに高度に合致する高品質な画像を生成することができます。
6、ユーザーフィードバックと優位性データベース:ユーザーフィードバックと優位性データベースを組み合わせることで、システムはユーザーの好みに基づいてモデル選択を調整し、画像生成の関連性と品質を向上させることができます。
例:システムの初期使用段階では、ユーザーは生成された画像に対するフィードバックを提供するかもしれません。例えば「この画像の色が暗すぎる」などです。DiffusionGPTはこれらのフィードバックを活用してモデル選択を調整し、将来の画像生成がユーザーの好みにさらに合致するようにします。
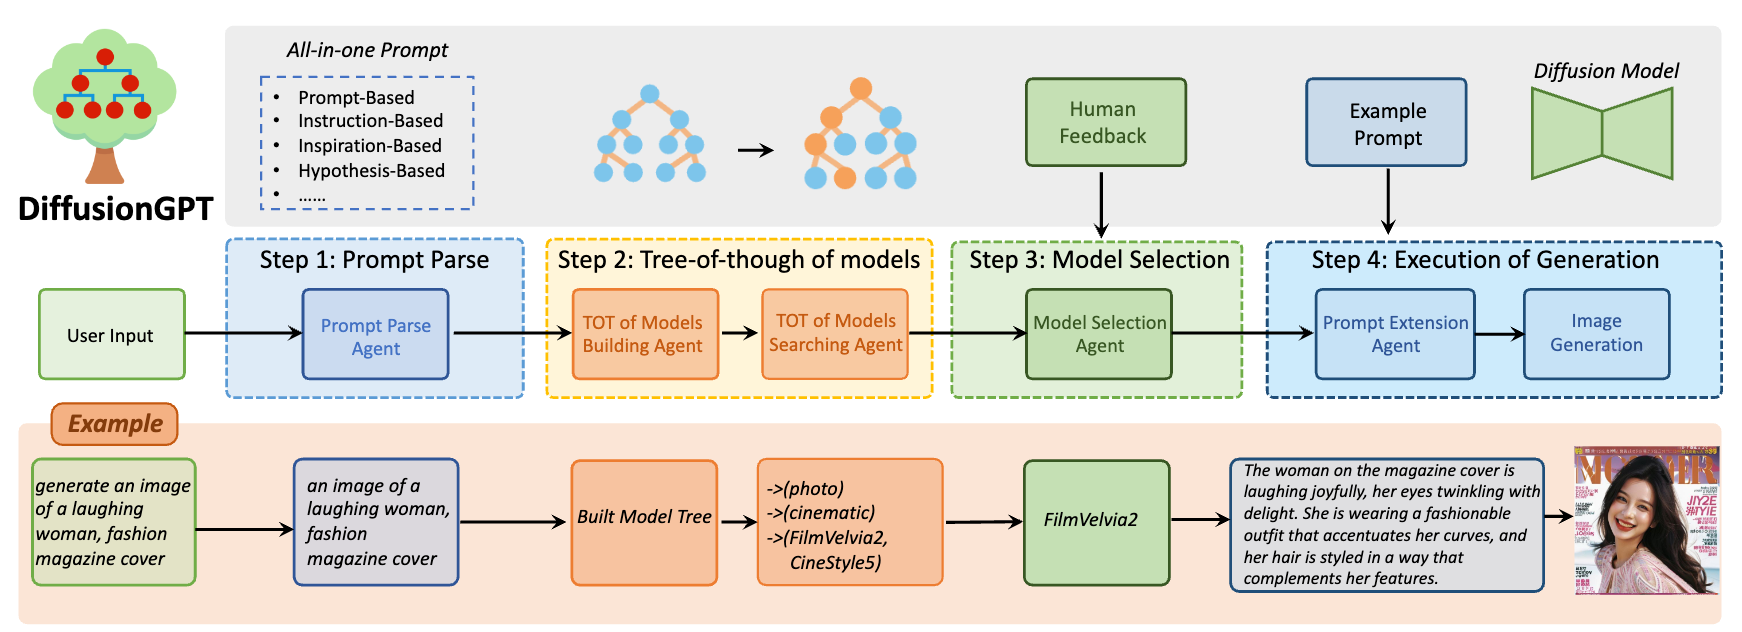
DiffusionGPTの主な動作原理:
1、入力解析:ユーザーが説明、指示、インスピレーションなどのテキストプロンプトを提供します。
大規模言語モデル(LLM)がこれらのテキストプロンプトを解析し、その意味とニーズを理解する役割を担います。
2、思考ツリー(Tree-of-Thought)の構築:異なる画像生成タスクに応じて、システムは「思考ツリー」を構築します。これは、異なる画像生成モデルを組織化するための構造です。
思考ツリーは事前知識と人間のフィードバックに基づいており、複数の分野の專門レベルのモデルを網羅しています。
3、モデル選択:LLMの解析結果に基づき、システムは思考ツリーを通じて現在のテキストプロンプトに最適な画像生成モデルを特定します。選択プロセスでは、ユーザーの好みや履歴フィードバックも考慮される場合があり、これらの情報は優位性データベースに格納されています。
4、画像生成:適切なモデルが選択されると、そのモデルを使用して画像が生成されます。生成された画像は入力されたテキストプロンプトと密接に関連し、ユーザーの意図と好みを反映します。
5、結果出力:最終的に生成された画像がユーザーに提示されます。
これらの画像は多様であり、具体的な説明シーン、コンセプトアート作品、特定のスタイルに合った画像などが含まれますが、これらに限定されません。
6、ユーザーフィードバック最適化プロセス:
ユーザーが生成された画像に対して行ったフィードバックは、優位性データベースを充実させるために使用され、それによってシステムがユーザーの好みをより深く理解し、その後のモデル選択と画像生成を最適化するのに役立ちます。
DiffusionGPTは、人間やシーンなどのカテゴリーの画像を生成する際に、高いリアル主义とディテールを示しています。ベースラインモデル(SD1.5など)と比較して、DiffusionGPTが生成した画像は、視覚的な忠実度やディテールの捕捉において顕著な向上を示しています。DiffusionGPTは、画像報酬と美学スコアリングの面で、従来の安定拡散モデルよりも優れたパフォーマンスを発揮します。画像生成品質の定量的な評価において、DiffusionGPTは高いスコアを示しており、生成された画像が品質と美学の面でより好まれていることを示しています。














