
 脚本プランナー▸
 AIアプリ
 AIニュース
DreamTalk:人物写真を喋らせるオープンソースフレームワーク
DreamTalk:人物写真を喋らせるオープンソースフレームワーク紹介
DreamTalkは、清華大学、阿里巴巴(アリババ)、華中科技大学が共同で開発した拡散モデルベースのフレームワークで、人物写真を音声に合わせて話すようにさせることができます。歌、複数言語の音声、ノイズの多い音声など、さまざまな音声マッチングによる人物アバターのセリフ生成をサポートします。
DreamTalkデモアドレス:https://dreamtalk-project.github.io
DreamTalkプロジェクトアドレス:https://dreamtalk-project.github.io/
DreamTalk論文アドレス:https://arxiv.org/abs/2312.09767
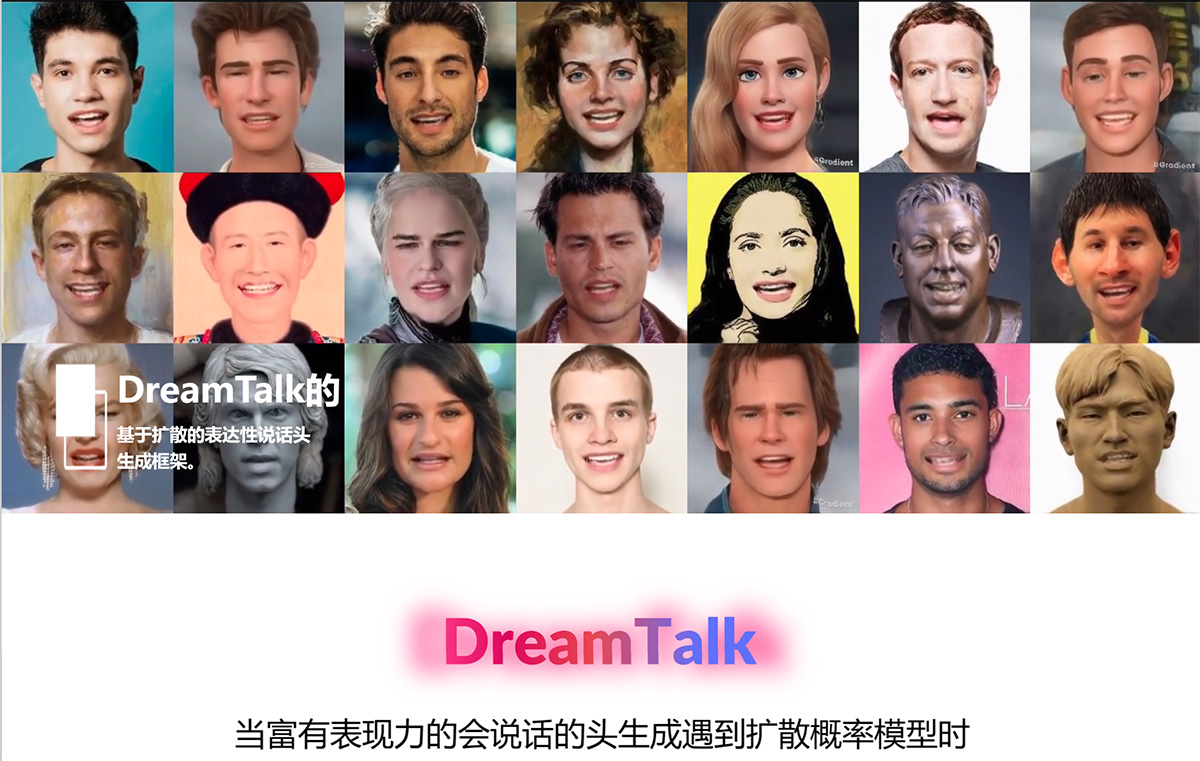
DreamTalkの使用シーン:
DreamTalkを使用して、多様な言語と表情スタイルの話す顔画像を生成する
映画やテレビ制作でリアルな仮想キャラクターの表情や動きを実現するためにDreamTalkを適用する
ヒューマンコンピュータインタラクションのシナリオで、自然な表情と唇の動きを実現するためにDreamTalkを使用する
DreamTalkの機能:
具体的には、DreamTalkは3つの重要なコンポーネントで構成されています:ノイズ除去ネットワーク、スタイル認識リップエキスパート、およびスタイル予測器です。拡散ベースのパス除去ネットワークは、さまざまな表情で高品質なオーディオ駆動の顔動作を一貫して合成できます。唇の動きの表現力と正確性を向上させるため、話すスタイルに注意を払いつつリップシンクをガイドするスタイル認識リップエキスパートを導入しました。表情参照動画やテキストの必要性を排除するため、追加の拡散ベースのスタイル予測器を使用してオーディオから直接ターゲットの表情を予測します。
1、パス除去ネットワーク:これはコアコンポーネントの一つであり、オーディオ駆動の顔動作を生成する役割を担います。ノイズ除去ネットワークは拡散モデルを使用して段階的にノイズを除去し、鮮明で高品質な表情を生成します。このプロセスには、ノイズを含むデータから鮮明な顔動作を段階的に復元することが含まれます。
2、スタイル認識リップエキスパート:このコンポーネントは、唇の動きの表現力と正確性の向上に焦点を当てています。話すスタイルを分析することでリップシンクを導き、生成されたアニメーションが自然であり、かつ話者のスタイルに沿ったものになるようにします。
3、スタイル予測器:表情参照動画やテキストへの依存を排除するため、DreamTalkは拡散ベースのスタイル予測器を導入しています。この予測器は、追加の表情参照動画やテキストを必要とせずに、オーディオから直接ターゲットの表情を予測することができます。
4、オーディオと動画処理:オーディオ入力を処理して重要なオーディオ特徴を抽出し、これらの特徴を顔アニメーションの駆動に使用します。また、特定の表情やスタイルを抽出・模倣するために動画入力を処理することもできます。
5、データとモデルトレーニング:これらの機能を実現するため、DreamTalkはモデルをトレーニングするために大量のデータが必要です。これには、さまざまな表情や話すスタイルの顔アニメーションデータが含まれます。これらのデータを通じて、モデルは入力オーディオと一致する顔動作を正確に生成する方法を学習します。
DreamTalkは強力な拡散モデルを活用して、表現力豊かな顔を効果的に生成し、高価なスタイル参照への依存を減らすことができます。実験結果は、DreamTalkが異なる話すスタイルでリアルな話す顔画像を生成し、正確な唇の動きを実現し、既存の最先端の同種製品を超えることができることを示しています。
DreamTalkは、トレーニング中に見られた顔のタイプや表情を処理・生成できるだけでなく、異なるデータセットからのこれまで見たことのない顔のタイプや表情も効果的に処理・生成できます。
異なる人種、年齢、性別の人物肖像、およびさまざまな表情や感情を含みます。














