
 脚本プランナー▸
 AIアプリ
 AIニュース
DreaMoving:拡散モデルに基づく人体動画生成フレームワーク
DreaMoving:拡散モデルに基づく人体動画生成フレームワーク紹介
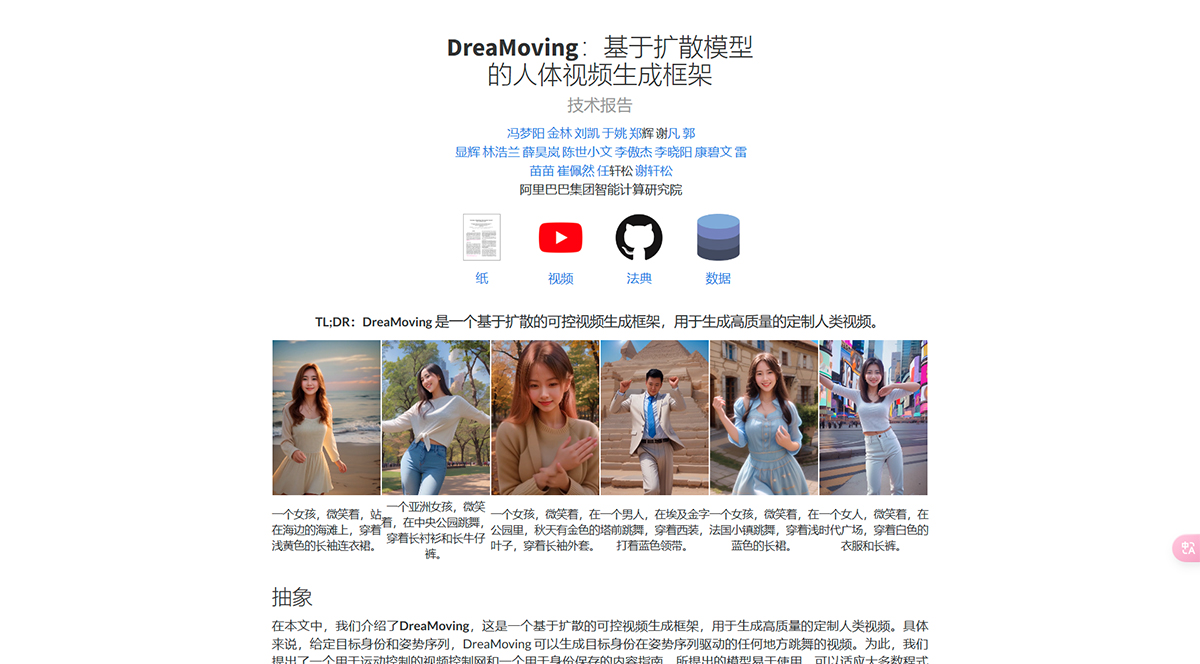
DreaMovingは、拡散ベースの高品質なカスタマイズ可能なヒューマンダンス動画生成のための制御可能な動画生成フレームワークです。具体的には、ターゲットの人物と姿勢シーケンスが与えられた場合、DreaMovingは姿勢シーケンスによって駆動される任意の場所で踊るターゲットの動画を生成できます。これを実現するために、我々は動作制御のためのVideo ControlNetと、人物の同一性保持のためのContent Guiderを提案します。提案モデルは使いやすく、ほとんどのスタイル化された拡散モデルに適応してさまざまな結果を生成できます。
DreaMovingプロジェクトアドレス:https://dreamoving.github.io/dreamoving
DreaMoving概要:
Video ControlNetは、各U-Netブロックの後に動作ブロックを挿入する画像ControlNetです。Video ControlNetは、制御シーケンス(姿勢または深度)を追加の時間的残差として処理します。Denoising U-Netは、動画生成用の動作ブロックを備えた派生型Stable-Diffusion U-Netです。Content Guiderは、入力テキストプロンプトと外観表現(顔(服装はオプション))をクロスアテンション用のコンテンツ埋め込みに伝達します。
結果:
DreaMovingは、ガイドシーケンスと単純なコンテンツ記述(テキストや参照画像など)を入力として、高品質で忠実度の高い動画を生成できます。具体的には、参照顔画像による人物の同一性制御、姿勢シーケンスによる正確な動作操作、指定されたテキストプロンプトによる包括的な動画外観制御を実現します。














