脚本プランナー▸
 AIアプリ
 AIニュース

AnimateDiff_云技派,专注ai人工智能!
AnimateDiff_云技派,专注ai人工智能!紹介
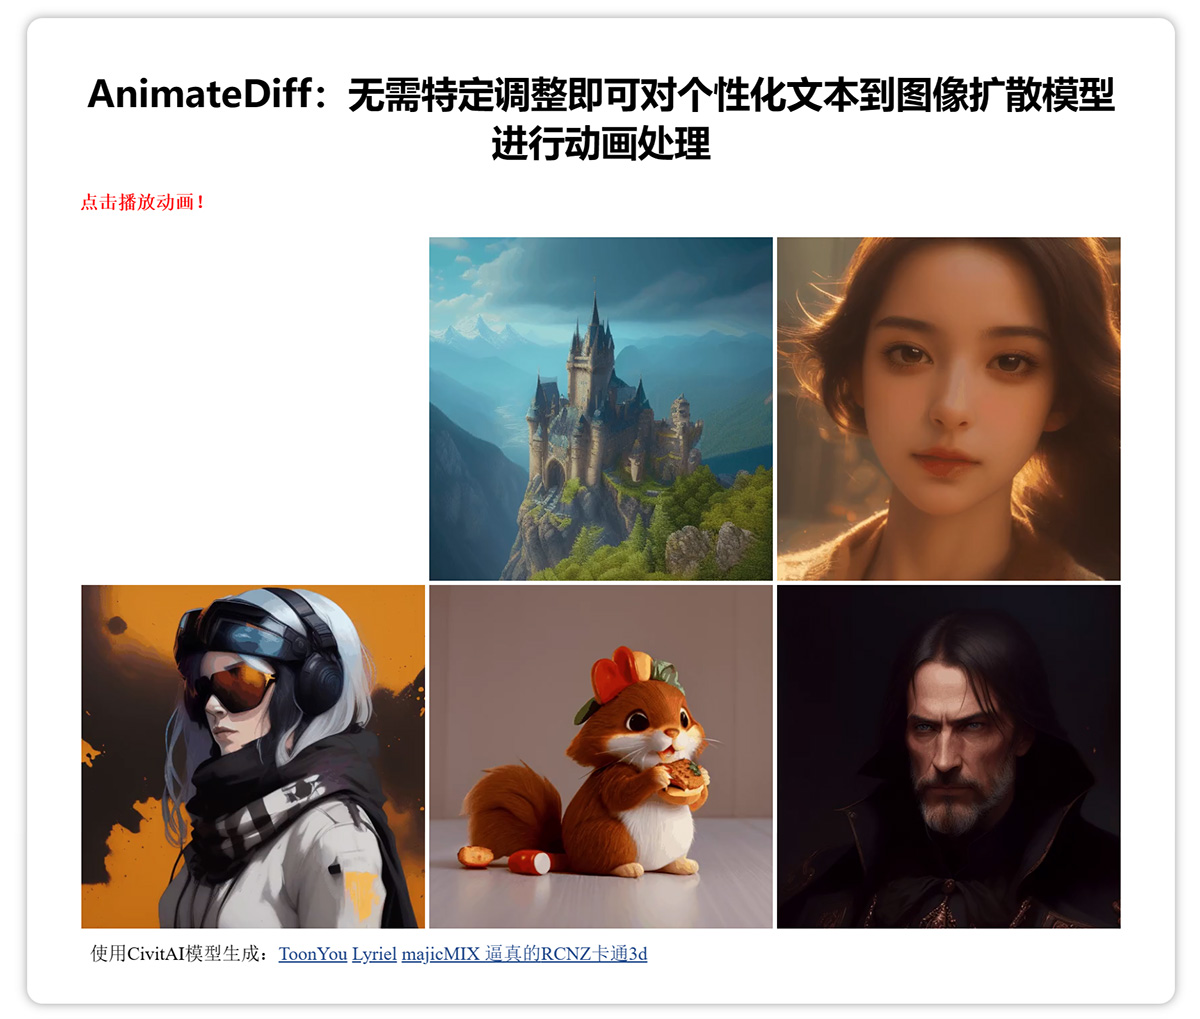
AnimateDiff は、パーソナライズされたテキストを画像に変換できる拡張モデルであり、stable diffusion 内で安定した GIF アニメーションを作成できるプラグインで、特定の調整を行うことなくアニメーション効果を実現できます。このプロジェクトを通じて、ユーザーはテキストから画像を生成する形式で直接 GIF アニメーションを生成でき、想像力を高品質な画像として表現するとともに、妥当なコストでこれを実現できます。テキストから画像へのモデル(例えば Stable Diffusion)および対応するパーソナライズ技術(例えば LoRA や DreamBooth)の進歩により、誰もが想像力を高品質な画像に変換できるようになりました。その後、生成された静止画像と動きを組み合わせるために、画像アニメーション技術への需要も高まっています。
そして最終的な出力画像の品質から見ると、AnimateDiff が生成したアニメーションは非常に安定した性能を示し、アニメーションの映像自体も非常にスムーズです。
AnimateDiff の特徴:
1、AnimateDiff フレームワークは既存の T2I モデルと直接統合でき、ユーザーは特定のタスクやシーンごとにモデルを再調整したり再トレーニングしたりする必要がありません。複雑な変更を行う必要はありません。
2、AnimateDiff は十分に柔軟に設計されており、ユーザーが自分でトレーニングした T2I モデルや、他のプラットフォーム(例えば Civitai や Huggingface)からダウンロードしたモデルとも統合できます。これによりユーザーに大きな利便性が提供され、AnimateDiff を使用して既存の T2I モデルを手軽に強化できます。
プロジェクト紹介:https://animatediff.github.io/
コード:https://github.com/guoyww/animatediff/
論文:https://arxiv.org/abs/2307.04725