
 脚本プランナー▸
 AIアプリ
 AIニュース
BuboGPT|バイトダンス大規模モデル
BuboGPT|バイトダンス大規模モデル紹介
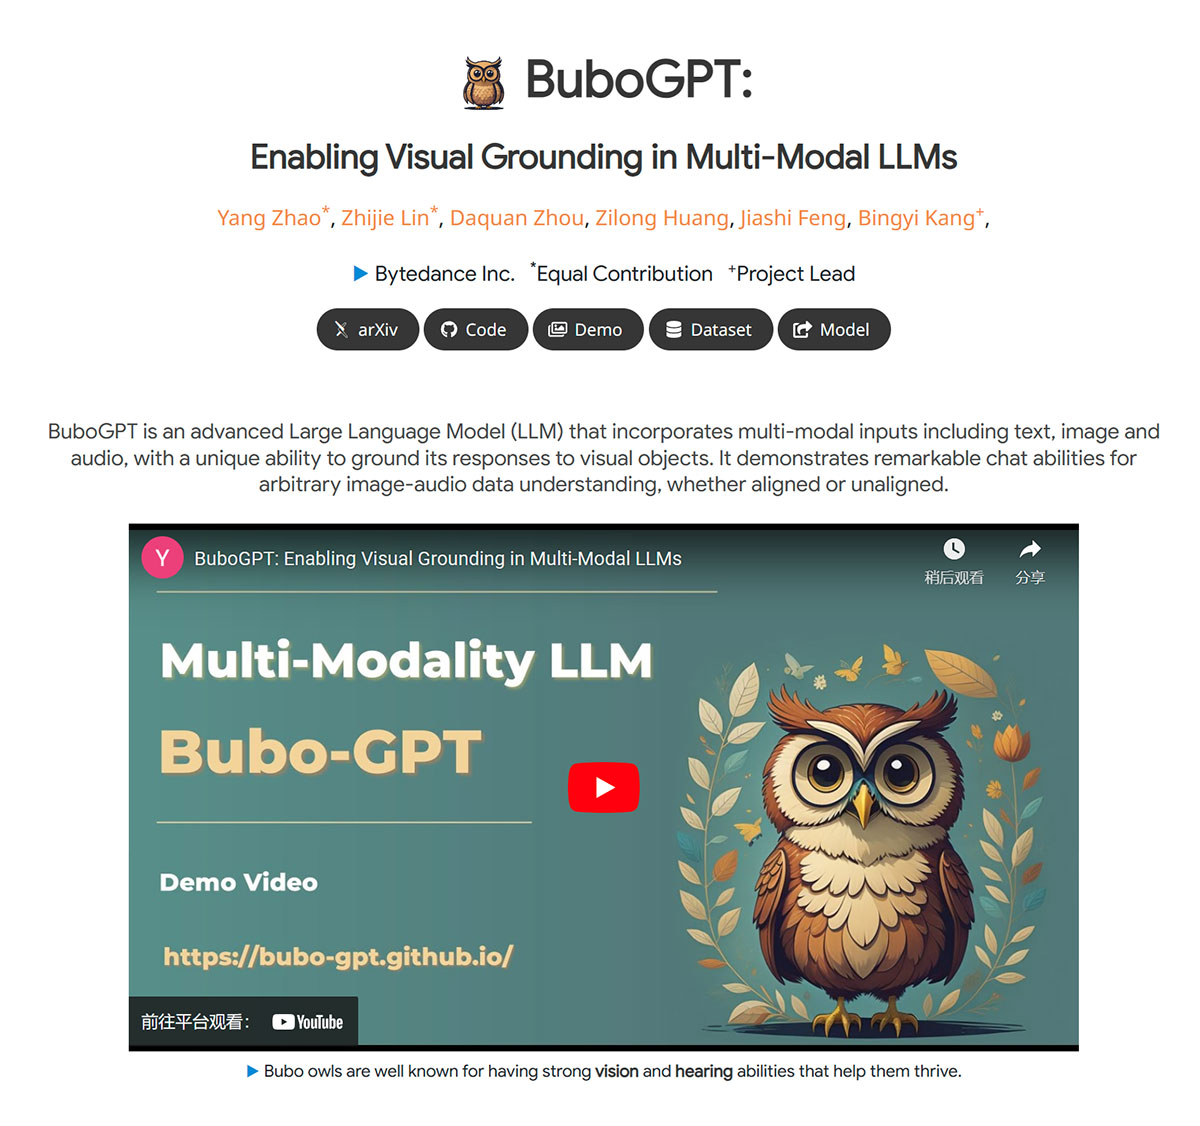
バイトダンスが新しい大規模モデル「BuboGPT」を発表しました。BuboGPTは先進的な大規模言語モデル(LLM)であり、テキスト、画像、オーディオなどのマルチモーダル入力を統合することができ、返信を視覚的オブジェクトと結びつける独自の能力を備えています。アライメントされているか否かに関わらず、任意の画像・オーディオデータの理解において優れた対話能力を発揮します。
テキスト記述、画像の位置特定、音源の位置特定を通じて、BuboGPTは音源を正確に判断することができ、オーディオと画像との間に直接的な関係がない場合でも、両者の間の考えられる関係を適切に記述することができます。
他のマルチモーダル大規模モデルと比較して、BuboGPTはテキストと他のモーダル間の豊富な情報と明確な対応関係を活用し、視覚オブジェクトおよび与えられたモーダルに対するきめ細やかな理解を提供します。
マルチモーダル理解を実現するために、BuboGPTは共有セマンティックスペースを使用し、マーキングモジュール、ローカライゼーションモジュール、エンティティマッチングモジュールを含むビジュアルグラウンディングパイプラインを構築しています。
言語を橋渡しとして、BuboGPTは視覚オブジェクトを他のモーダルと結びつけることができます。研究チームはまた、画像記述、音源識別などにおけるBuboGPTの能力を実演し、コードとデータセットをオープンソース化し、試せるデモを公開しました。
BuboGPTの主要機能:
1、マルチモーダル理解: BuboGPTはテキスト、視覚、オーディオの統合的なマルチモーダル理解と対話機能を実現します。
2、ビジュアルグラウンディング: BuboGPTはテキストを画像内の特定部分と正確に関連付けることができ、きめ細やかなビジュアルグラウンディングを実現します。
3、オーディオ理解: BuboGPTはオーディオクリップ内の各音声部分を正確に記述することができ、人間にとって短すぎて知覚しにくい一部のオーディオクリップについても対応可能です。
4、アライメントおよび非アライメント理解: BuboGPTは一致するオーディオ-画像ペアを処理して完全なアライメント理解を実現でき、任意のオーディオ-画像ペアに対して高品質な応答を行うことができます。















