
 脚本プランナー▸
 AIアプリ
 AIニュース
DeepSeek-V4、GPT-5.5、Opus 4.7:2026年4月の三大トップモデル対決!
小编 ·

DeepSeek-V4、GPT-5.5、Opus 4.7:2026年4月の三大トップモデル対決!
2026年4月、DeepSeek、Claude、GPTの3つのトップモデルが相次いで登場しました。DeepSeek-V4は長文と低コストを主打し、Claude Opus 4.7はプログラミングと論理的推論に特化し、GPT-5.5は総合能力が比較的バランスの取れた選択肢です。本記事では、コード、推論、価格という3つの観点からこれら3つのモデルを比較し、参考にしていただければと思います。
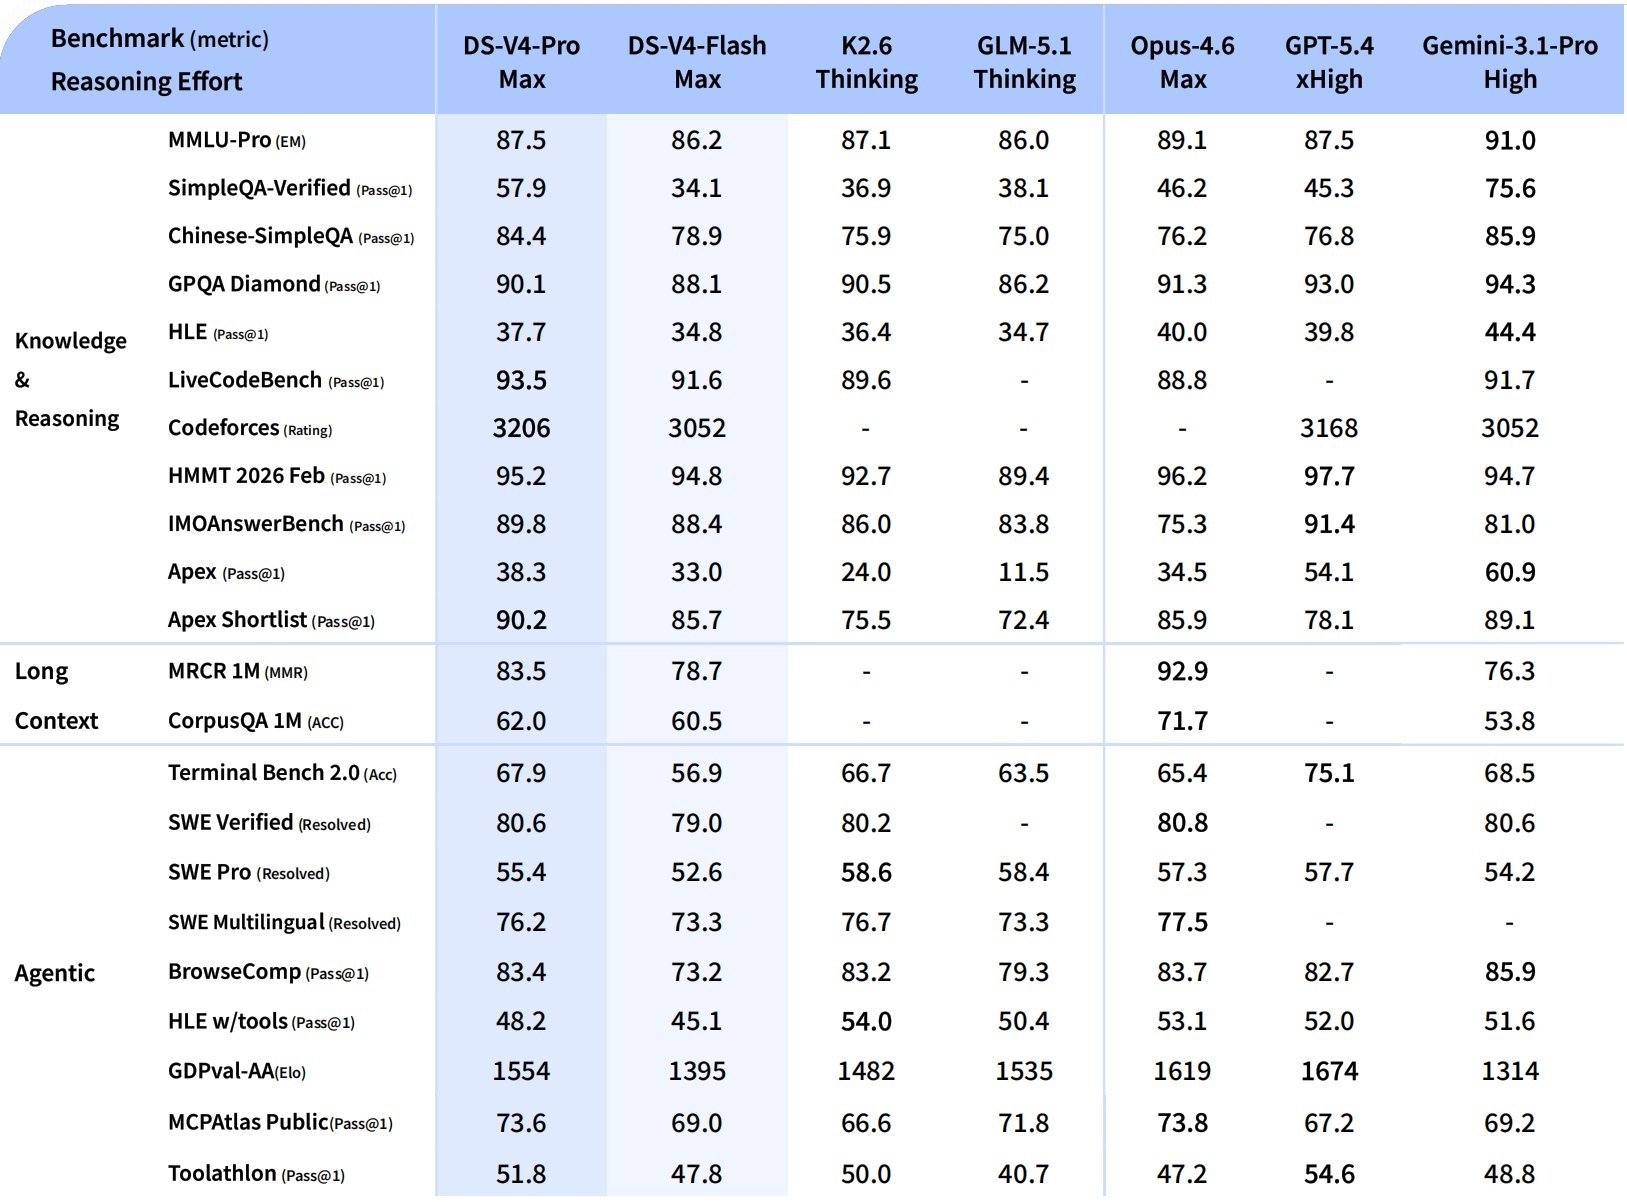
📊 コアパラメータと能力の比較
| 観点 | DeepSeek-V4 (Pro) | Claude Opus 4.7 | GPT-5.5 (xHigh) |
|---|---|---|---|
| コアポジショニング | 究極のコストパフォーマンス + 超長文コンテキスト | トップレベルのコードエンジニアリング + 厳密なロジック | 総合的な汎用能力 + マルチモーダル |
| コンテキストウィンドウ | 1,000,000 (1M) | ~200K (標準) | ~128K - 400K |
| コード能力 | SWE-Bench: ~80.6% | SWE-Bench: ~87.6% | SWE-Bench: ~75-80% |
| 数学/推論 | 極めて強い (トップクラスのクローズドソースに近い) | 最高峰 (自己修正機能) | 最高峰 (ベンチマークスコア最高) |
| マルチモーダル | テキスト+画像 | 高解像度ビジョン (3.75MP) | ネイティブフルモーダル (音声/動画) |
| デプロイ方式 | オープンソース + API (プライベート化可能) | クローズドソース API | クローズドソース API |
| 価格 | ¥4 / 1M tokens (入力) | ~$35 / 1M tokens (入力) | ~$70+ / 1M tokens (入力) |
🧐 各モデルの詳細解説
DeepSeek-V4:長文コンテキストとコストパフォーマンス
1Mのコンテキストウィンドウが中核的な差別化ポイントです。大量の財務報告、技術文書、会議の議事録を一度に処理する必要がある場合、V4は適切な選択肢です。コード能力(SWE-Bench 80.6%)と数学的推論能力も弱くはなく、一部のシナリオではGPT-5.5に近い性能を発揮します。入力価格はGPT-5.5の約1/20で、APIを高頻度で呼び出す企業にとってコスト面の優位性が顕著です。マルチモーダル(動画/音声理解)や複雑なクリエイティブライティングにおいては、ClaudeやGPTにやや劣るのが欠点です。
Claude Opus 4.7:プログラミングとエンジニアリング
SWE-Bench Verifiedで87.6%を達成し、他のモデルを大幅に上回ります。コードを書くだけでなく、自己修正やプランニング能力を備えており、金融グレードのコードなど高い要求のあるタスクを処理できます。ビジョン面では3.75メガピクセルの画像入力に対応し、複雑な化学分子構造や設計図の認識が可能です。技術的な議論ではユーザーの誤った見解に異議を唱えることもあり、ベテランの同僚のような存在です。欠点:価格が高く、オープンソース版がありません。
GPT-5.5:比較的バランスの取れた総合能力
MMLU-Proなどの総合ベンチマークで引き続き90点以上を維持しており、知識の幅と深さは安定しています。ツールチェーン(DALL-E、Voice Mode)やサードパーティプラグインのエコシステムは比較的成熟しています。ただし価格が高すぎるため、多くの一般的なアプリケーションにとっては性能に対する価格プレミアムが見合わない可能性があります。
💡 選び方
DeepSeek-V4を選ぶ場合:
法律文書、小説全体、大量のログなど、超長文ドキュメントを一度に処理する必要がある
開発者やスタートアップ企業であり、APIコストに敏感、またはプライベートデプロイが必要
中国語能力が高く、応答が速いモデルが必要
Claude Opus 4.7を選ぶ場合:
主な用途がコード作成、ソフトウェア開発、または複雑な論理的推論である
高い指示遵守度やビジョン解析能力(設計図の分析など)が求められる
予算に余裕があり、現在の最高水準のコード品質の出力を得たい
GPT-5.5を選ぶ場合:
複数分野にまたがる複雑な問題を処理する汎用アシスタントが必要
ワークフローがMicrosoft/Azureエコシステムに大きく依存している
音声、動画などのマルチモーダルコンテンツを処理する必要がある









