
 脚本プランナー▸
 AIアプリ
 AIニュース
Qwen-Image:Alibaba Tongyiがオープンソース化した画像・ポスター生成モデル
小编 ·

Qwen-Image:Alibaba Tongyiがオープンソース化した画像・ポスター生成モデル
Qwen-Imageは、アリババ通義千問(Qwen)チームが2025年8月5日にオープンソース化した画像生成基盤モデルで、パラメータ数は200億、MMDiTアーキテクチャを採用しています。複雑なテキストレンダリングと精密な画像編集に優れた性能を発揮し、特に大量で正確な中国語の生成が得意です。また、中国語のプロンプトもサポートしており、LongText-BenchやChineseWordなど中国語専用のテストで多くのモデルを大きくリードしています。
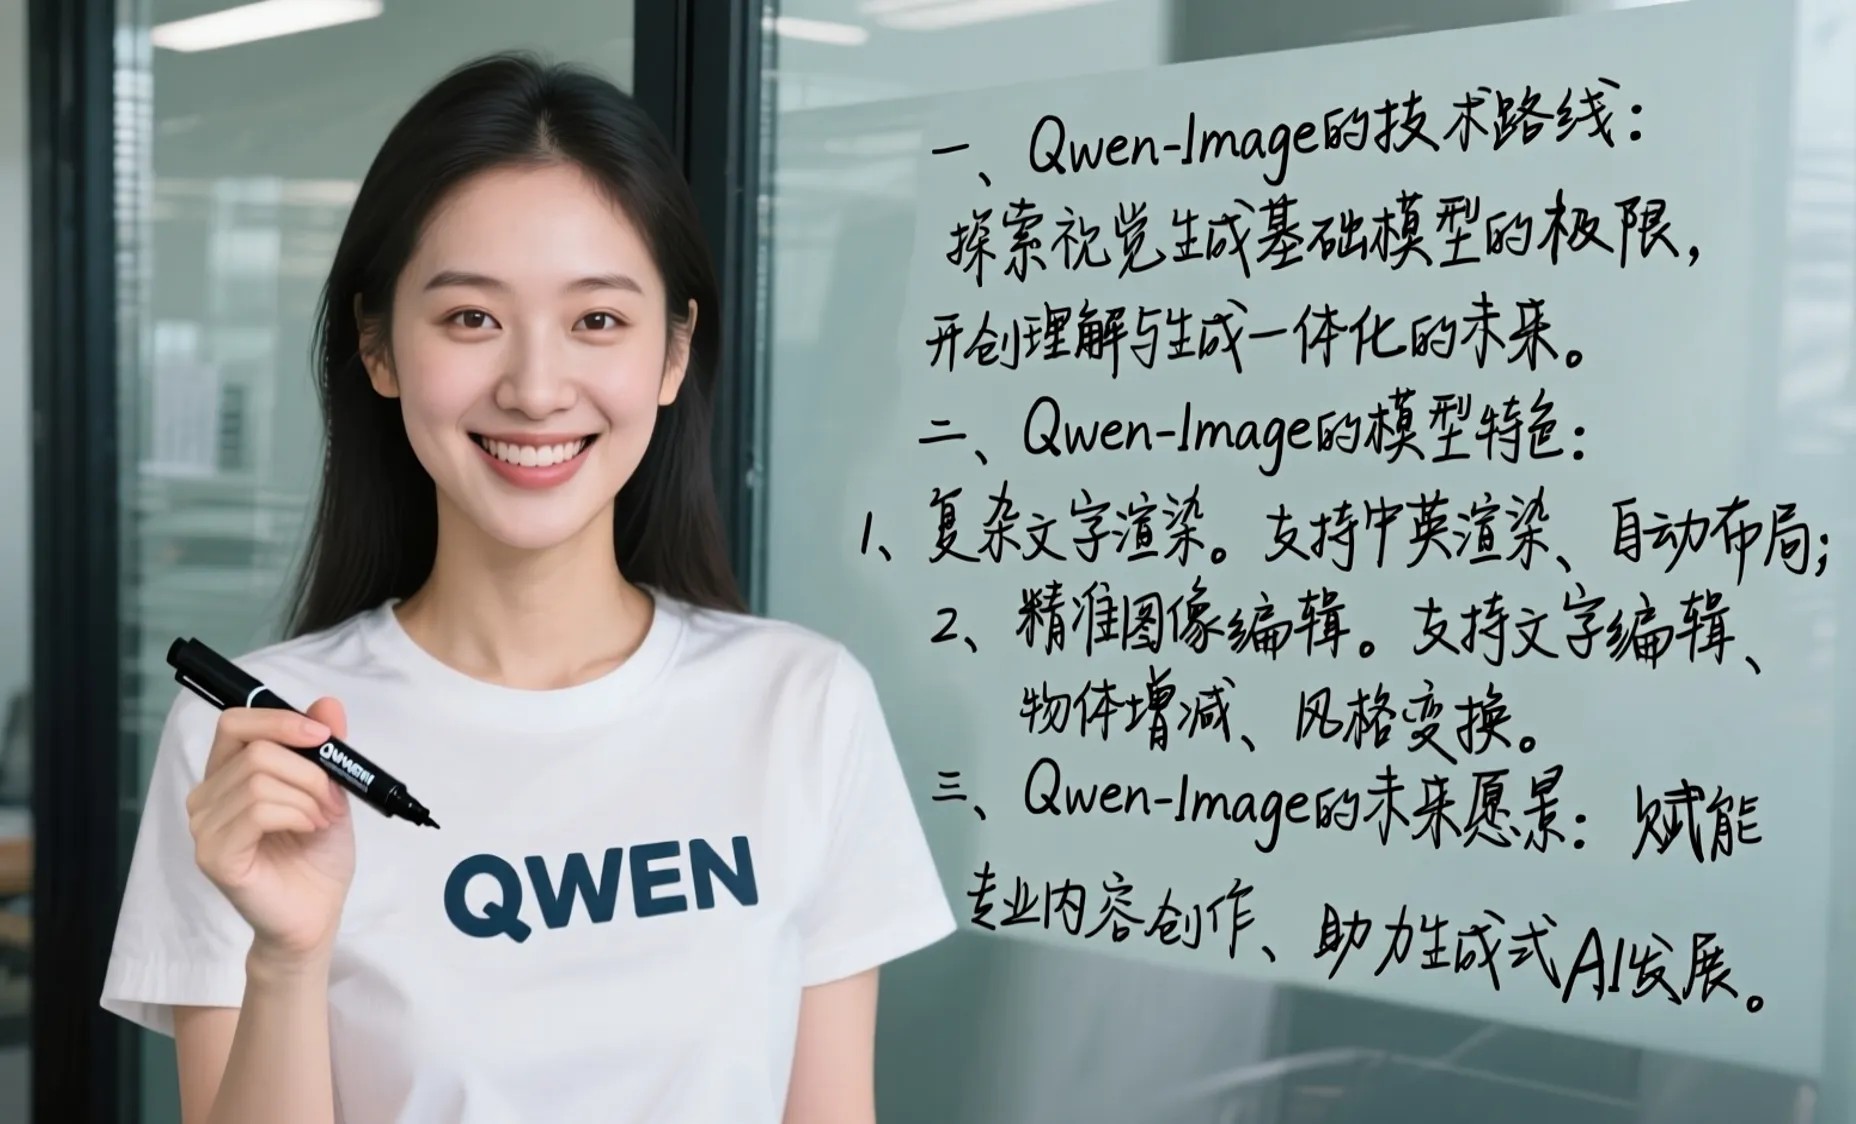
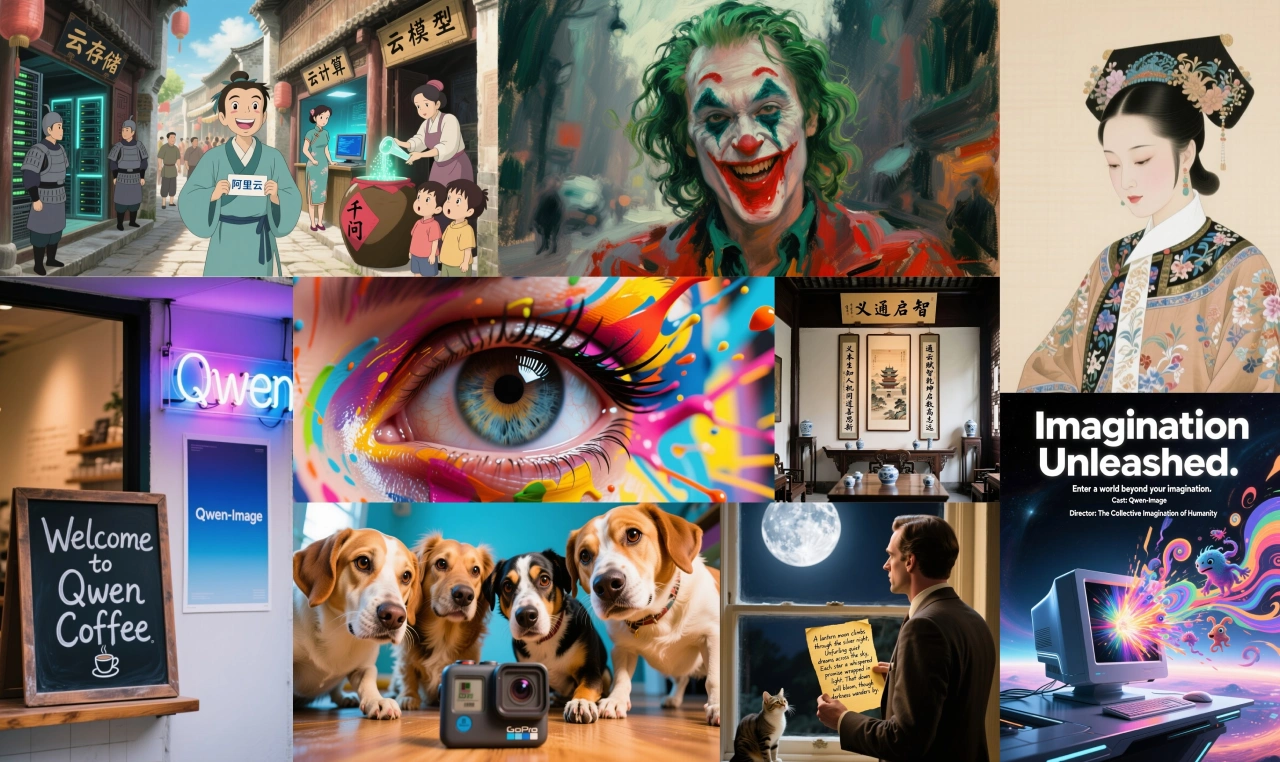
このモデルは中英バイリンガルに対応し、さまざまなフォント、超長文のパラグラフ、複雑な画像とテキストのレイアウトを処理できます。ポスター、pptなど多様なシーンの画像を生成できるほか、スタイル転送、物体の追加・削除、ポーズ調整などの画像編集も可能です。広告デザイン、映画・テレビ制作、ゲーム開発、教育・研修など、さまざまな業界で活用できます。ユーザーはQwenChat(chat.qwen.ai)で画像生成機能を選択して体験することができ、ポスター、PPTページ、商品プロモーション画像などの生成や、画像へのさまざまな編集が可能で、デザイナーに強力なツールを提供します。
主な特徴
テキストレンダリング能力が高い:複数行レイアウト、パラグラフレベルのテキスト生成、ディテール表現をサポートし、中国語と英語の両方で高忠実度の出力が可能です。LongText-Bench、ChineseWord、TextCraftなどのテストで優れたパフォーマンスを発揮し、中国語テキストレンダリングは既存の先進モデルを大きく上回ります。異なる言語やスタイルのテキストを生成できるほか、毛筆文字を書くこともでき、テキストと画像を含むPPTページを直接生成することも可能です。
画像編集の一貫性が優れている:強化されたマルチタスクトレーニングにより、編集時に視覚的・意味的な一貫性を維持でき、スタイル転送、追加・削除・変更、ディテール強化、テキスト編集、人物のポーズ調整などの操作をサポートします。
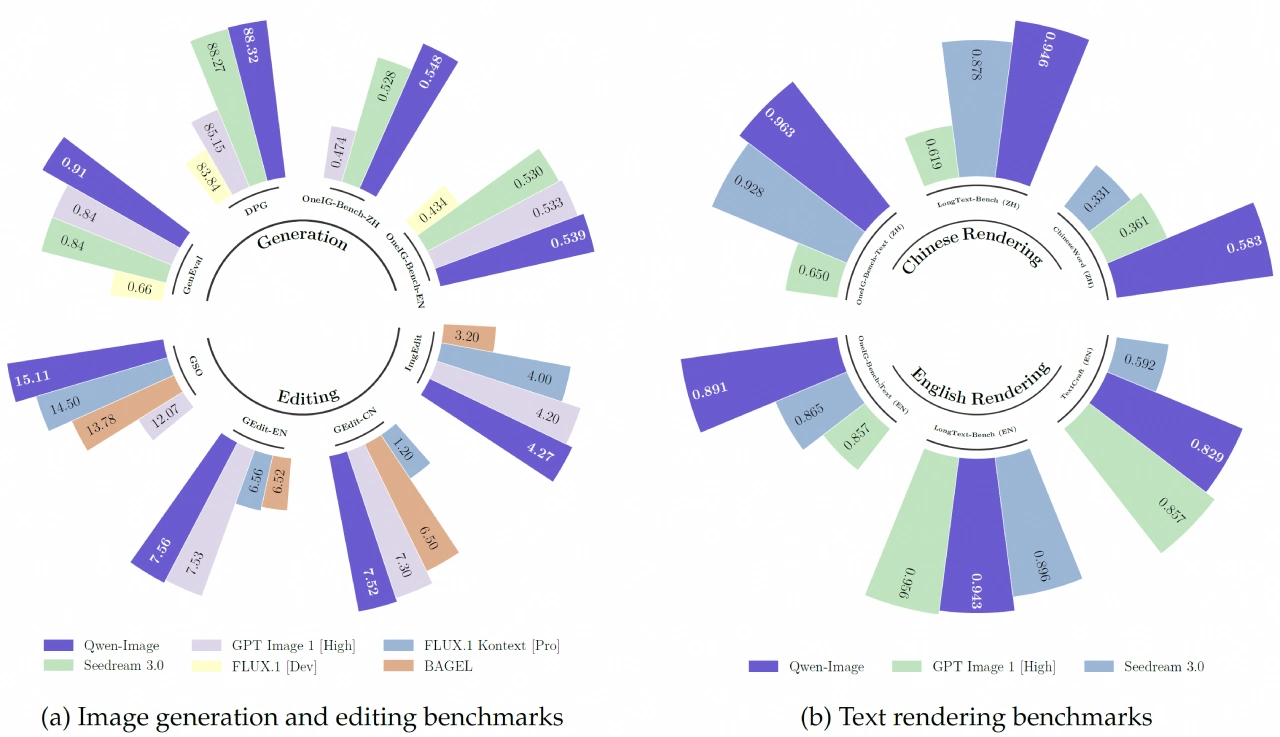
クロスベンチマーク性能が優れている:汎用画像生成のGenEval、DPG、OneIG-Bench、および画像編集のGEdit、ImgEdit、GSOなど、複数の公開テストでトップクラスの性能を達成しています。
コアコンポーネント
Qwen2.5-VL マルチモーダル大規模言語モデル:条件エンコーダーとして機能し、テキストから特徴を抽出し、システムプロンプトに基づいて物体や背景の色、数量、文字などを詳細に記述し、画像生成の根拠を提供することで、生成されるコンテンツをより精緻にします。
Wan-2.1動画生成モデルの変分オートエンコーダー(VAE):画像トークナイザーに相当し、入力画像をコンパクトな潜在表現に圧縮し、推論時にデコードして復元します。チームはエンコーダーを凍結し、デコーダーのみを微調整することで、画像のディテールをより際立たせています。
マルチモーダル拡散Transformer(MMDiT):バックボーン拡散モデルとして機能し、テキスト誘導の下でノイズと画像潜在表現の関係を処理します。マルチモーダル拡張可能RoPE手法を導入し、画像とテキスト情報の区別を助けることで、高解像度画像の生成と正確な文字生成の両方を実現します。
Qwen-Image技術アーキテクチャ
MMDiTアーキテクチャ:マルチモーダル拡散Transformerを用いて、テキストと画像の深い融合を実現します。
単一エンコーダー・二重デコーダーVAE:画像をコンパクトな潜在表現に圧縮し、生成後にピクセルにデコードする役割を担います。再建損失と知覚損失のバランスを調整することで、画像のディテールをリアルに再現できます。
マルチモーダル拡張可能回転位置エンコーディング(MSRoPE):テキスト情報を画像グリッドの「対角線」上にエンコードし、テキストの独立性を維持しつつ、画像解像度のスケーリングという利点を活用できます。
トレーニング戦略
多段階で漸進的な事前学習を採用:低解像度から高解像度へ、汎用コンテンツから専門コンテンツへ、 massiveなデータから精選されたデータへと段階的にトレーニングします。
トレーニング後期に教師あり微調整(SFT)と強化学習(RL)を活用:人手で厳選された高品質データで微調整を行い、DPOなどの技術を通じてモデルに人間の好みを学習させます。
応用シーン
広告デザイン:ブランドスタイルに基づいて高品質な画像を迅速に生成し、スタイル変換やディテール最適化をサポートします。デザイナーが複数の効果を迅速に試し、クライアントのニーズに応えるのに役立ちます。
映画・テレビ制作:初期段階のコンセプトアート、シーンプリビズ、キャラクターデザインに使用され、制作期間を短縮し、コストを削減します。
ECビジュアル:マーチャントが製品展示画像、バーチャル試着画像、マーケティングマテリアルを迅速に生成でき、ユーザー体験と購入率を向上させます。
ポスター制作:テキストとデザイン要件に基づいて、インパクトのある芸術的なポスター(映画やイベントのポスターなど)を生成し、さまざまなスタイルやテーマに対応します。
PPT制作:企業向けPPTページを生成し、スターブルーをメインカラーに、流動的なテクノロジー線と微光粒子エフェクトを組み合わせた、プロフェッショナルでモダンなビジュアルを提供します。複数のスタイルとレイアウトをサポートします。
性能
汎用画像生成:GenEval、DPG、OneIG-Benchなどのテストで優れたパフォーマンスを発揮します。
画像編集:GEdit、ImgEdit、GSOなどの専門テストでトップクラスの性能を達成します。
テキストレンダリング:LongText-Bench、ChineseWord、TextCraftなどのテストで能力が目立ち、特に中国語テキストレンダリングは既存のトップモデルをはるかに凌駕します。
Qwen-Imageの優位性
中国語サポートがより優れている:中国語専用に最適化されており、レンダリング効果はDALL-Eを大きく上回ります。
完全無料:有料サブスクリプションが不要で、ローカル環境へのデプロイも可能です。
オープンソースで透明性が高い:コードが公開されており、カスタマイズや修正が可能です。
編集機能がより強力:より多様な画像編集操作をサポートします。
使用制限なし:API呼び出し回数の制限を受けません。
Qwen-Image使用方法
環境準備:最新バージョンのdiffusersをインストールします。
基本コード:
from diffusers import DiffusionPipeline
import torch
model_name = "Qwen/Qwen-Image"
if torch.cuda.is_available():
    torch_dtype = torch.bfloat16
    device = "cuda"
else:
    torch_dtype = torch.float32
    device = "cpu"
pipe = DiffusionPipeline.from_pretrained(model_name, torch_dtype=torch_dtype)
pipe = pipe.to(device)
prompt = '''一个穿着"QWEN"标志T恤的中国美女正拿着黑色马克笔面向镜头微笑。她身后的玻璃板上手写体写着"欢迎使用Qwen-Image,一款强大的图像基础模型"'''
aspect_ratios = {
    "1:1": (1328, 1328),
    "16:9": (1664, 928),
    "9:16": (928, 1664),
    "4:3": (1472, 1140),
    "3:4": (1140, 1472)
}
width, height = aspect_ratios["16:9"]
image = pipe(
    prompt=prompt + "超清,4K,电影级构图",
    width=width,
    height=height,
    num_inference_steps=50,
    true_cfg_scale=4.0,
    generator=torch.Generator(device=device).manual_seed(42)
).images[0]
image.save("qwen_image_example.png")
GB 以上のビデオメモリ)、CPU モードでは生成速度が遅くなりますが、利用することは可能です。
✅Qwen-Image公式紹介:https://qwenlm.github.io/zh/blog/qwen-image/
✅Qwen-Imageモデル:https://huggingface.co/Qwen/Qwen-Image
✅オンラインで使用:https://chat.qwen.ai/(入力欄の下にある画像生成を選択)









