
 脚本プランナー▸
 AIアプリ
 AIニュース
MOSS-TTSD:オープンソースのバイリンガル対話音声合成モデル
小编 ·

MOSS-TTSD:オープンソースのバイリンガル対話音声合成モデル
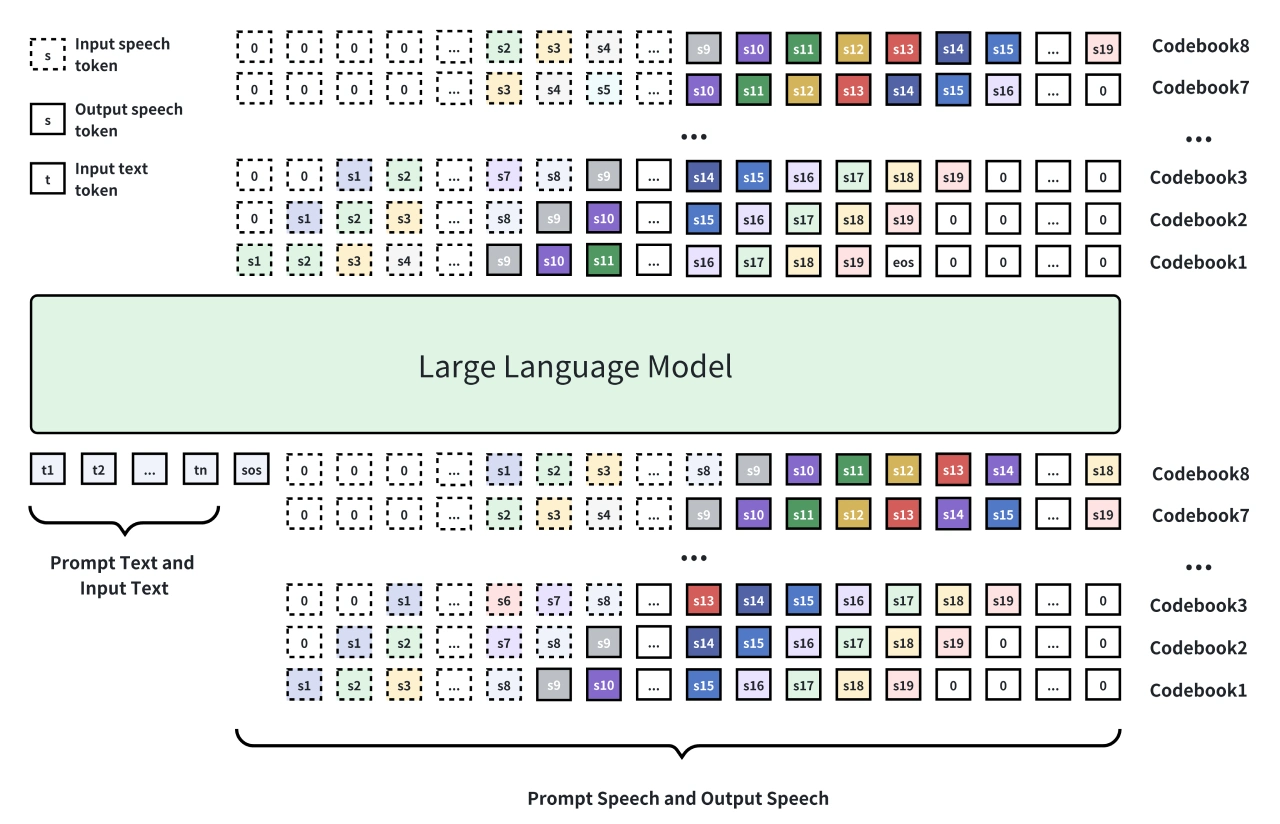
MOSS-TTSDは、清華大学音声・言語研究室がテンセント ai Labなどの機関と共同で開発したオープンソースのバイリンガル対話音声合成モデルです。中国語と英語に対応しており、2人の話者の対話スクリプトを自然で表現力豊かな対話音声に変換できます。このモデルは Qwen3-1.7B-base モデルに基づいて継続的に学習されており、離散化された音声シーケンスモデリングを採用し、XY-Tokenizer によって音声を 1kbps に圧縮しつつ、意味情報と音響情報の両方を保持しています。
MOSS-TTSDモデルは中国語と英語のバイリンガルに対応しており、ゼロショットで複数の話者の声色をクローンできます。最長 960 秒の音声生成が可能で、AI ポッドキャスト、映像配音、長編インタビューなどのシナリオに適しています。モデルの重み、推論コード、API インターフェースはすべてオープンソース化されており、無料で商用利用することも可能です。
主な特徴
✅高表現力の対話音声:統一された意味・音響ニューラルオーディオコーデック、事前学習済みの大規模言語モデル、数百万時間の TTS データ、および 40 万時間の合成と実際の対話音声によって構築されており、自然な対話リズムと表現力豊かな人間のような対話音声を生成できます。
✅デュアルスピーカー音声クローン:ゼロショットのデュアルスピーカー音声クローンに対応しており、対話スクリプトに基づいて話者を正確に切り替え、対話音声を生成できます。
✅中国語・英語のバイリンガルサポート:中国語と英語の両言語で表現力豊かな音声を生成できます。
✅長時間音声生成:低ビットレートコーデックと学習フレームワークの最適化により、長時間音声生成に特化した学習が行われています。
✅完全オープンソースかつ商用利用可:MOSS-TTSD およびその将来のアップデートは完全にオープンソース化され、無料で商用利用することが許可されています。
MOSS-TTSDの技術原理
✅モデルアーキテクチャ:Qwen3-1.7B-base モデルを基にファインチューニングされ、離散化された音声モデリングを採用しています。8 層の RVQ(残差ベクトル量子化)により音声信号を離散トークンシーケンスに変換し、自己回帰的方式に Delay Pattern を組み合わせて生成し、最後にデコーダで音声に復元します。
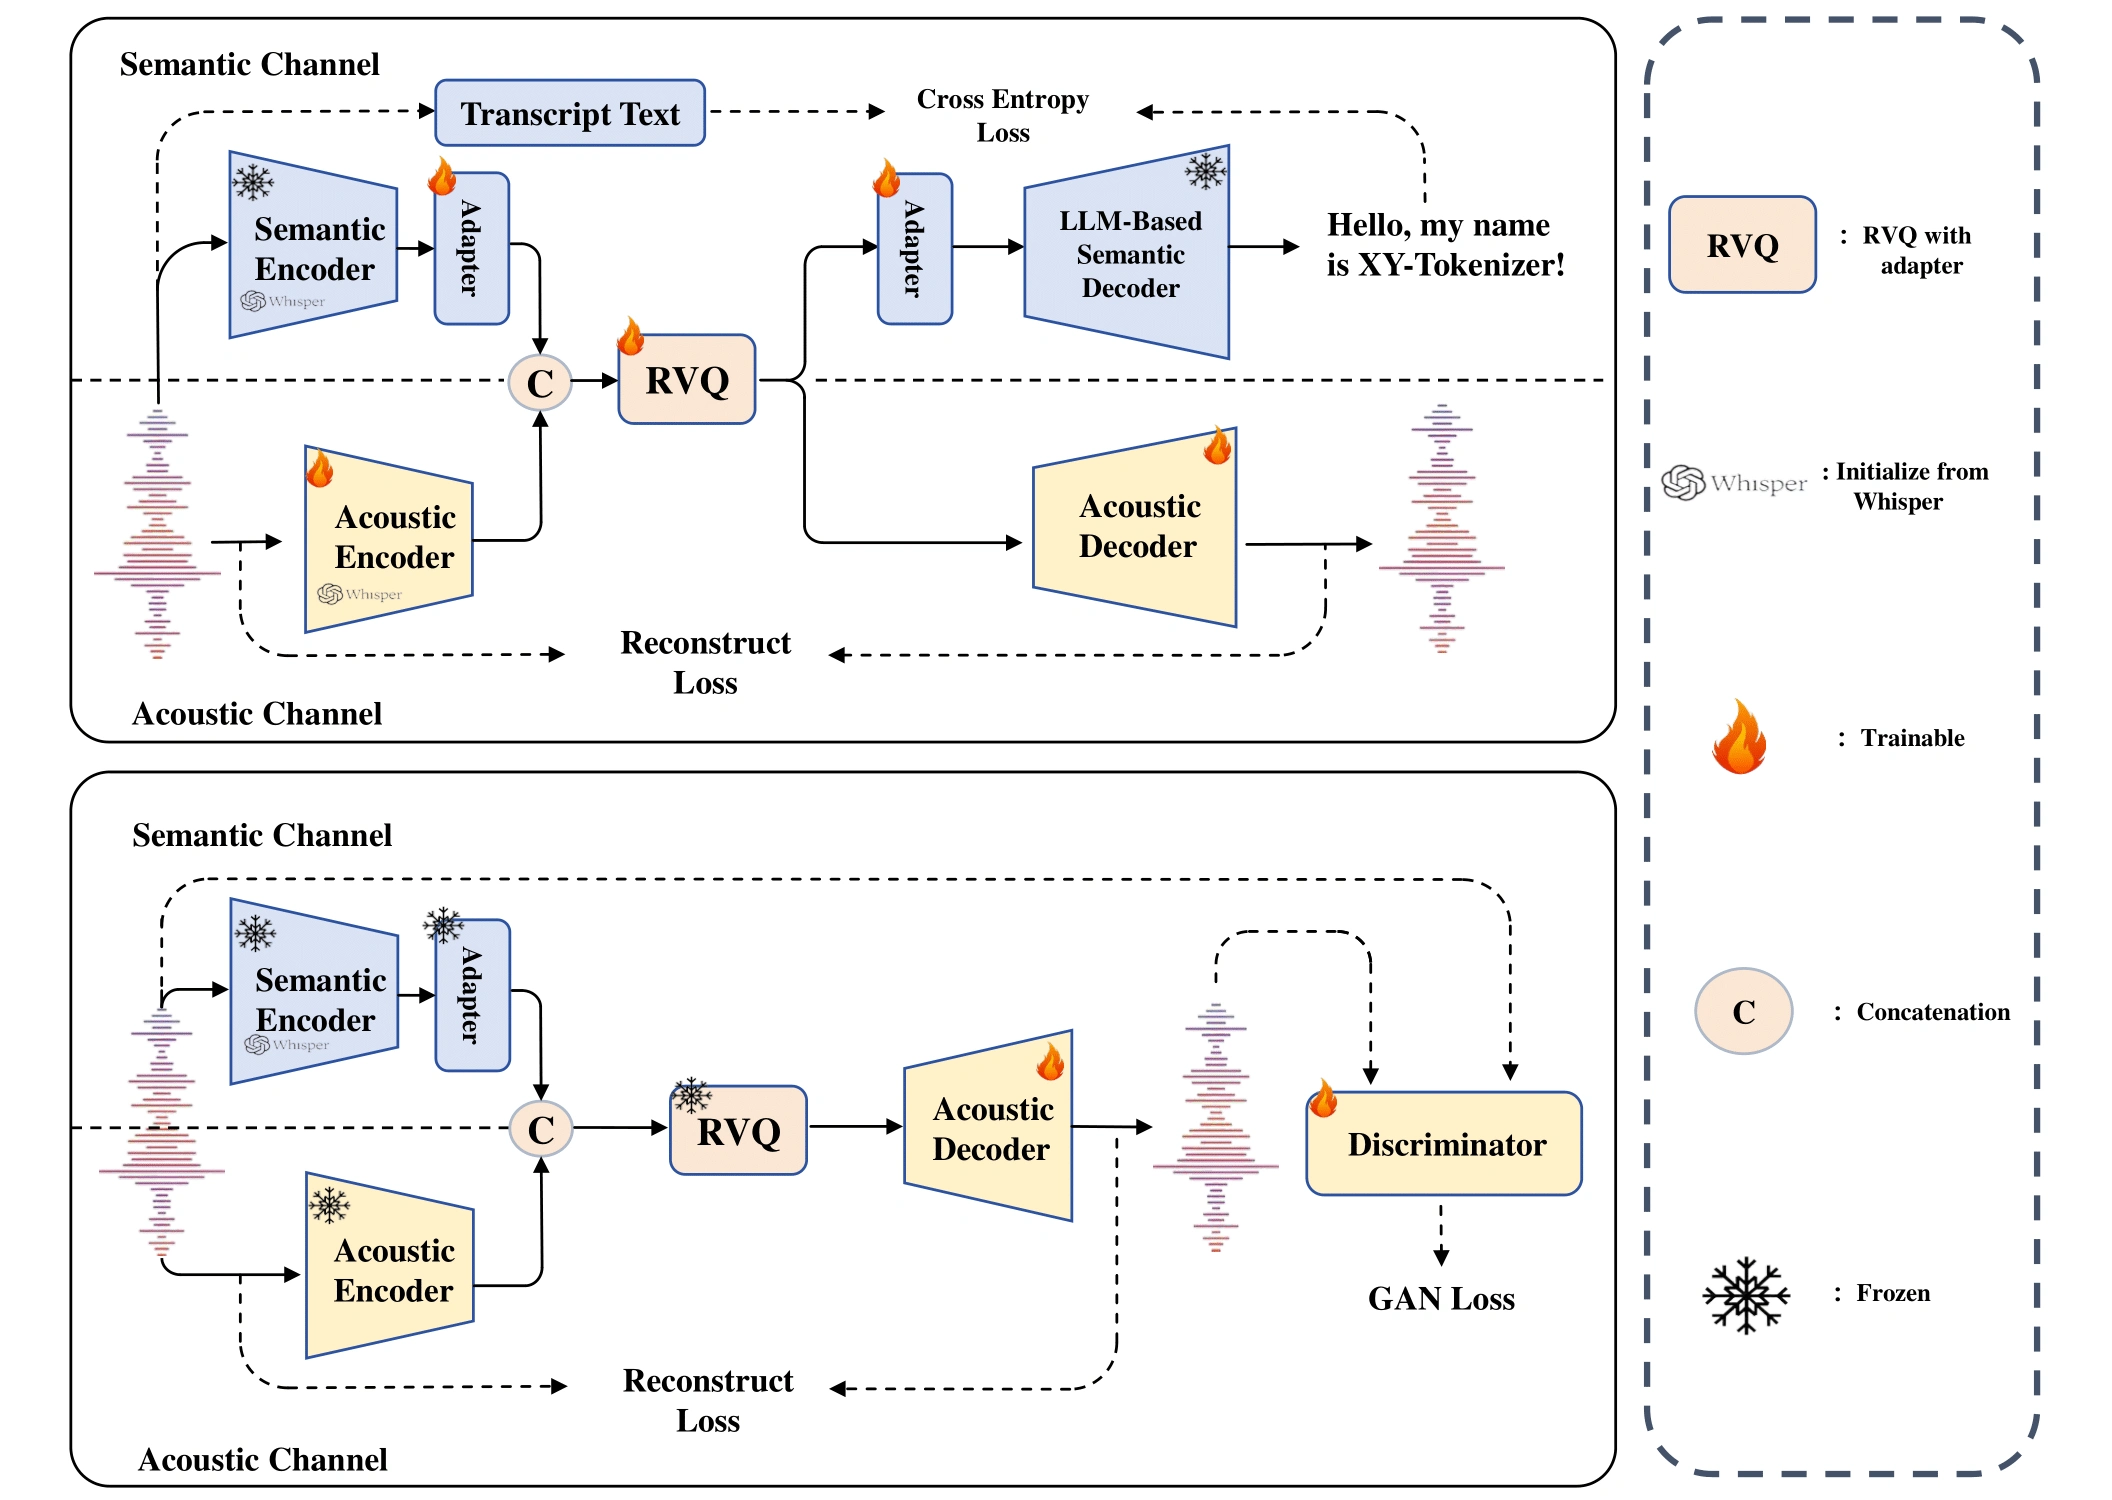
✅コアイノベーション:XY-Tokenizer は二段階マルチタスク学習フローを備えています。第一段階では自動音声認識(ASR)と音声再構築タスクを同時に学習し、意味情報と粗粒度の音響情報を融合します。第二段階ではエンコーダと量子化器を固定し、デコーダのみを学習させ、再構築損失と GAN 損失を加えて細部表現を強化します。
✅データ規模と事前学習:約 100 万時間の単一話者音声データと 40 万時間の対話音声データを使用して学習が行われ、厳格な選別とアノテーションを経たデータで、さらに中国語と英語による TTS の事前学習も実施されています。
応用シナリオ
✅AI ポッドキャスト制作:MOSS-TTSD はテキストを自動で複数人の対話形式ポッドキャスト音声に変換でき、ゼロショットの声クローンと長時間音声生成に対応しているため、制作コストを削減できます。
✅映像配音とアニメーション:映像作品やアニメーション向けに自然な対話音声を生成し、多言語切り替えにも対応しているため、配音効率を向上させます。
✅長編インタビューと会議記録:インタビューや会議のテキストを音声に変換し、対話のリズムと感情を保持するため、アーカイブや共有に便利です。
優位性と特徴
✅オープンソースかつ商用利用に優しい:MOSS-TTSD のモデル重み、推論コード、API インターフェースはすべてオープンソース化されており、ユーザーは無料で商用利用できます。
✅自然度と表現力:音声の自然度と表現力は業界トップクラスに達しています。
✅音声イベント制御をサポート:笑い声などの非言語音にも対応しており、音声の表現力をさらに高めます。
オープンソースアドレス:https://github.com/OpenMOSS/MOSS-TTSD
MOSS-TTSD公式サイト:https://www.open-moss.com/cn/









