
 脚本プランナー▸
 AIアプリ
 AIニュース
ThinkSound:Alibaba Tongyi Labが推出的したマルチモーダルAIオーディオツール
小编 ·

ThinkSound:Alibaba Tongyi Labが推出的したマルチモーダルAIオーディオツール
ThinkSoundは、アリババのTongyi(通義)ラボが発表したマルチモーダルaiオーディオツールで、動画、テキスト、または音声の入力から、高音質な効果音とシーンサウンドを生成することができます。
コア機能
✅ 動画からオーディオへ:あらゆる動画を知覚にフィットする豊かな効果音に変換します。フレームごとに画面要素、動きの軌道、環境背景を分析し、環境に同期した背景音や空間オーディオなどを生成します。
✅ スマート音声合成:動画内容に基づいて自然な会話とナレーションを生成します。AIは表情、口の動き、感情的な文脈を認識し、口の動きに正確に同期し、イントネーションが自然で感情表現がリアルな音声を出力します。
✅ マルチモーダル効果音デザイン:動画とテキスト指示、参照効果音、スタイルの好みを組み合わせることで、効果音の詳細を精密に制御し、映像と自然に融合させることができるため、映画、ゲームなどの専門制作に適しています。
✅ インタラクティブなオーディオ編集:ユーザーは動画内の対象オブジェクトをクリックしたり、自然言語の指示を直接入力したりすることで、特定の音を詳細に調整できます。
技術原理
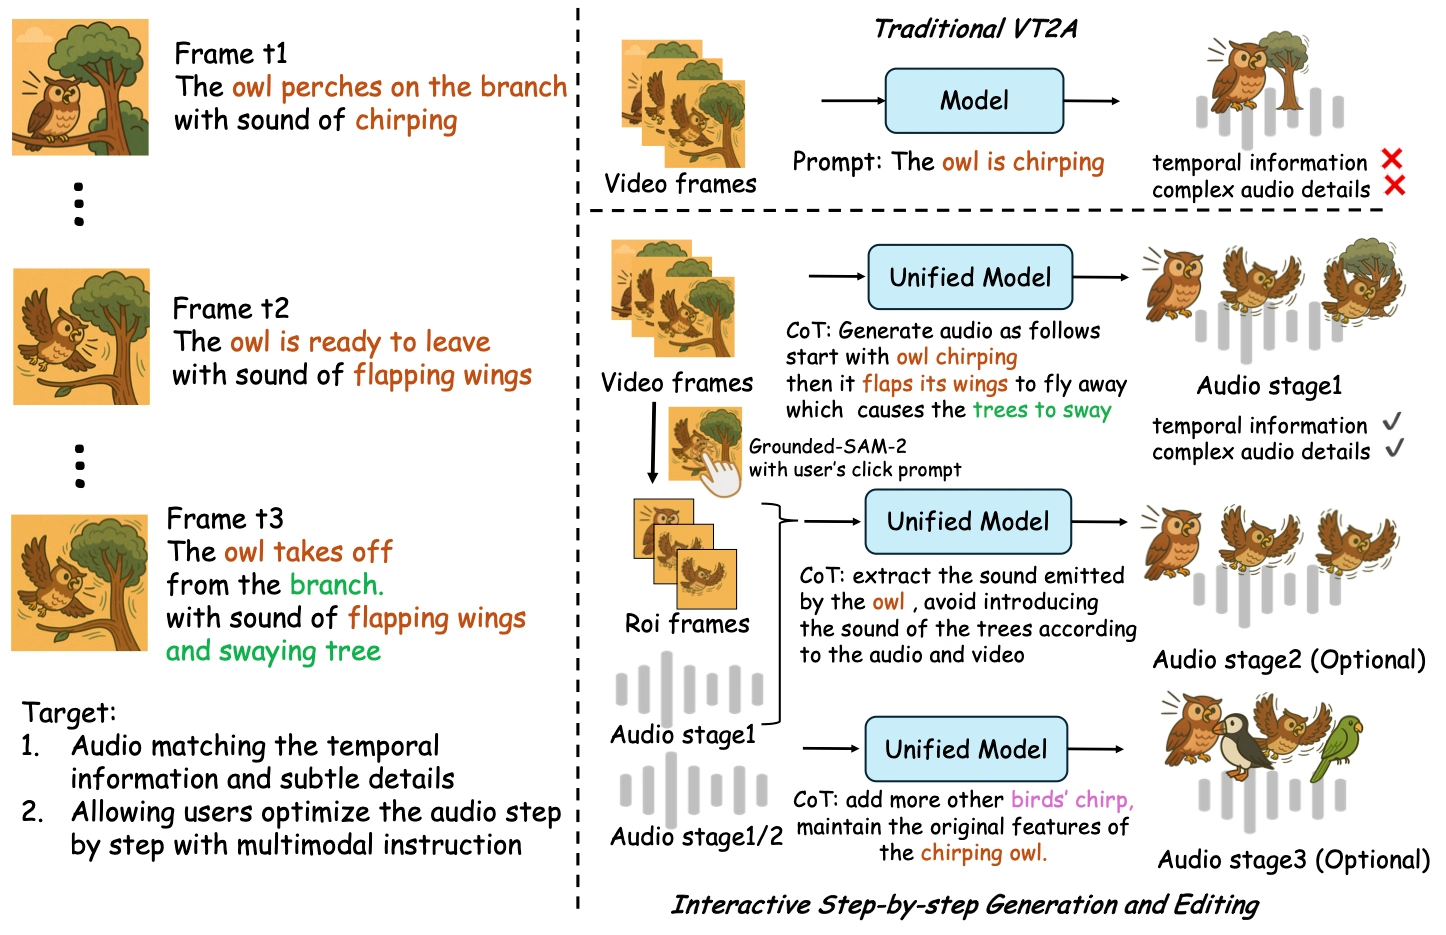
3段階インタラクションフレームワーク:
✅ 基本効果音生成:システムはまず動画を全体的に分析し、論理的推論によってサウンドイベント、環境要素、音響特性、時間的関連を識別し、初期の一貫した背景音シーンを生成します。
✅ オブジェクト最適化:ユーザーが対象オブジェクトをクリックすると、システムは位置特定技術によって領域を抽出し、オブジェクトの動きを追跡し、そのオブジェクトの効果音ロジックをピンポイントで生成し、全体的な音軌との調和を保ちながらオーディオの詳細を最適化します。
✅ 指示による編集:ユーザーが自然言語の指示(「鳥のさえずりを追加する」「車の音を消す」など)を入力すると、システムがそれを正確なオーディオ操作に変換し、映像と現在の効果音の状態と組み合わせて調整を行います。
✅ マルチモーダル大規模言語モデル(MLLM):中核となる能力は、動画映像、テキスト記述、音声コンテキストを同期的に理解し、情報を統合した後、自然でリアルな効果音を段階的に生成することです。
優位性と特徴
✅ 効果音の高いリアリティを備え、動画-オーディオ生成テストで優れたパフォーマンスを発揮し、シーンへの適応性に優れています。
✅ 詳細なプロンプトによるクリエイティブなエフェクトのカスタマイズをサポートしつつ、音と映像の自然な同期を保証します。
✅ 主流の動画フォーマット(MP4/MOV/AVI/MKV)と互換性があり、SDから4K解像度、さまざまなフレーム率に適応します。
✅ プロフェッショナルなシナリオ(映画、広告、ゲームなど)専用に設計されており、すべてのバージョンに商用利用ライセンスが含まれています。
応用シナリオ
✅ 映画・映像のポストプロダクション:無音素材から環境音、会話、BGMを迅速に生成し、制作効率を向上させます。
✅ ゲーム効果音:ダイナミックな環境音を制作し、バーチャルシーンの没入感を高めます。
✅ インタラクティブメディアと教育:音声合成により多言語対話を実現し、精密な口の動きの同期と感情表現を組み合わせることで、バーチャルキャラクターをより生き生きとさせます。
プロジェクトリンク
✅ Github:https://github.com/FunAudioLLM/ThinkSound
✅ 公式サイト:https://thinksound-demo.github.io/
✅ HuggingFace:https://huggingface.co/spaces/FunAudioLLM/ThinkSound









