
 脚本プランナー▸
 AIアプリ
 AIニュース
FantasyPortrait:1枚の静止画像から複数キャラクターの感情的な顔アニメーションを生成
小编 ·

FantasyPortrait:1枚の静止画像から複数キャラクターの感情的な顔アニメーションを生成
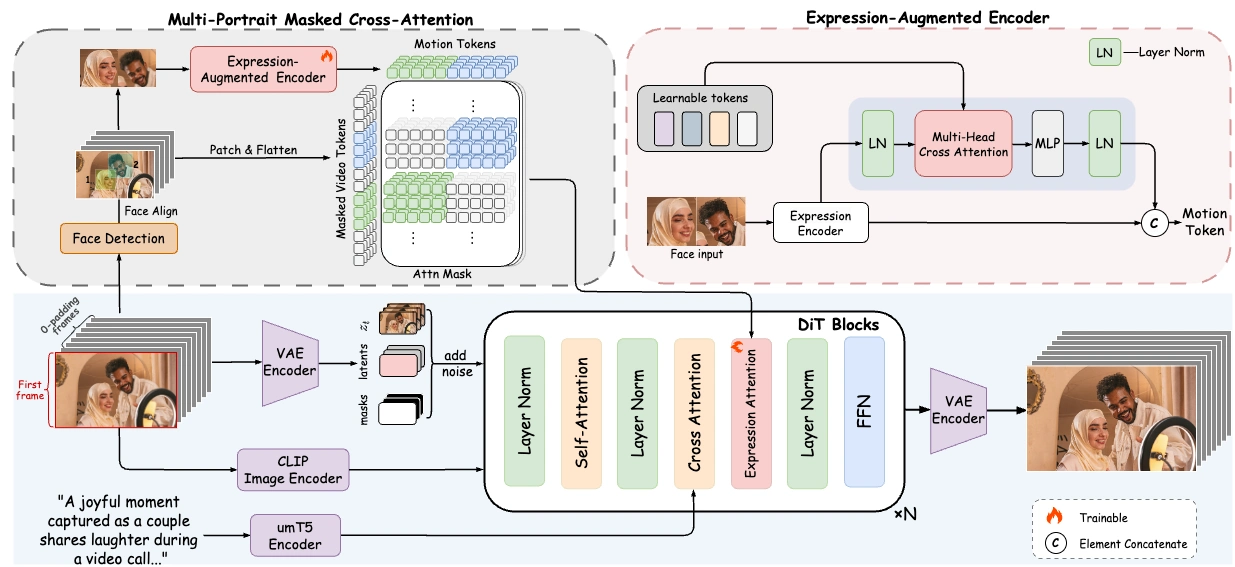
FantasyPortrait は、Alibaba の高徳地図チームと北京郵電大学が共同で開発したフレームワークで、1 枚の静止画像から複数キャラクターの感情豊かな顔アニメーションを生成することができます。複雑な表情を潜在特徴によって抽出し、従来の幾何学的事前情報に代わることで、異なるアイデンティティ間での転移能力を向上させます。また、マスク付きクロスアテンション機構を利用することで、複数キャラクター間の特徴の干渉を回避しています。さらに、複数スタイルのキャラクター適応、ゼロショットの動物アニメーション生成、低リソースの音声駆動などの機能もサポートしており、デジタルヒューマン、バーチャルアイドル、ゲーム NPC などの分野に適用でき、コードは GitHub でオープンソース化されています。
コア機能
✅ 潜在的な表情強化学習:唇の動きや感情表現などの複雑な表情を潜在特徴によって抽出し、従来の明示的な幾何学的事前情報に取って代わり、異なるアイデンティティ間での転移能力を向上させます。
✅ マスク付きクロスアテンション機構:複数キャラクターに対し独立した表情制御領域を生成し、特徴の干渉を回避することで、「1 キャラクター 1 チャンネル」の協調アニメーションを実現します。
✅ マルチモーダル拡張性:テキストや音声による駆動をサポートしており、例えば Whisper で音声をエンコードして口の動きのアニメーションを生成することができ、少量のデータでの微調整だけで多言語への適応が可能です。
✅ データセットと評価ベンチマーク:Multi-Expr データセット(高品質な複数キャラクター動画 3 万件以上)と ExprBench ベンチマークを構築し、業界標準化を推進しています。
方法設計について:
✅ 2 段階学習戦略:まず UNet で表情特徴をエンコードし、次に拡散 Transformer でアニメーションシーケンスをデコードします。
✅ 複数キャラクター制御モジュール:特徴マスクによって異なるキャラクターの駆動信号を分離し、時間次元の一貫性を維持します。
データセットと評価ベンチマーク:
✅ Multi-Expr データセット:50 万フレーム以上の多視点表情データを含み、初の複数キャラクター対応アニメーションデータセットです。
✅ ExprBench 評価ベンチマーク:複数キャラクターのポートレートアニメーションの学習と評価に使用されます。
実験結果:
✅ クロス駆動リキャップチャリングタスク:StyleHEAT、PIRender などの手法と比較して、FID 指標が 41.7% 向上しました。
✅ 複数キャラクターアニメーション生成シナリオ:ユーザー選好率は 83.5% に達し、目の微細な震えや非対称な口角の動きなど、細かい表情を正確に生成できます。
応用シナリオには以下が含まれます:
✅ 複数キャラクターアニメーション:複数の単一人物動画または 1 つの複数人物動画によって複数のキャラクターを駆動し、詳細な表情とリアルなポートレートアニメーションを生成することをサポートします。
✅ 多様なキャラクタースタイル:動的で表現力豊かで、自然かつリアルな多様なスタイルのアニメーションを生成できます。
✅ 動物アニメーション:動物のデータセットで明確に学習されていないにもかかわらず、動物アニメーションタスクにおいて高い汎化性能を発揮します。
✅ 音声駆動ポートレートアニメーション:音声エンコーディングと Transformer ベースのネットワークにより音声特徴を潜在駆動表現にマッピングし、音声で駆動されるポートレートアニメーションを実現します。少量の学習サンプルでも良好な音動画アライメントを達成できます。
主要な質問への回答:
技術的なブレークスルーは何ですか?
回答:1 つ目は、潜在的な表現強化制御により、潜在的な顔表現で細かい表情特徴を学習し、口の動きと感情表現のモデリング能力を向上させていること。2 つ目は、複数キャラクター対応のマスク付きクロスアテンション機構を独自に設計し、複数キャラクターの独立制御と協調生成を実現し、キャラクター間の特徴干渉問題を解決している点です。
機能的な特徴にはどのようなものがありますか?
回答:複数キャラクターの同期駆動をサポートし、単一または複数の単一人物動画、あるいは複数人物動画 1 本で複数キャラクターを同期駆動できることが含まれます。多スタイルのキャラクター適応では、異なる芸術スタイルのキャラクターに対して、動的で滑らか、生き生きとして自然、かつスタイルが統一された動画を生成できます。ゼロショットの動物アニメーションでは、専用の学習を行わなくても卓越した生成能力を持ちます。低リソースの音声駆動では、音声駆動フレームワークへ拡張可能で、Whisper で音声をエンコードし、軽量な Transformer ネットワークにより音声特徴を潜在駆動空間にマッピングします。
どのような応用価値がありますか?
回答:映像制作においては、独立系のアニメーターが群衆シーンの演技を簡単に生成できるようになります。ゲーム分野では、NPC がそれぞれ異なる微妙な表情を見せることが可能になります。バーチャル配信においては、複数キャラクターのインタラクションをより生き生きと自然なものにすることができます。
オープンソース情報:
GitHub リポジトリ:https://github.com/Fantasy-AMAP/fantasy-portrait
プロジェクト公式サイト:https://fantasy-amap.github.io/fantasy-portrait/









