
 脚本プランナー▸
 AIアプリ
 AIニュース
ColQwen-Omni:オープンソースのマルチモーダルRAGモデル
小编 ·

ColQwen-Omni:オープンソースのマルチモーダルRAGモデル
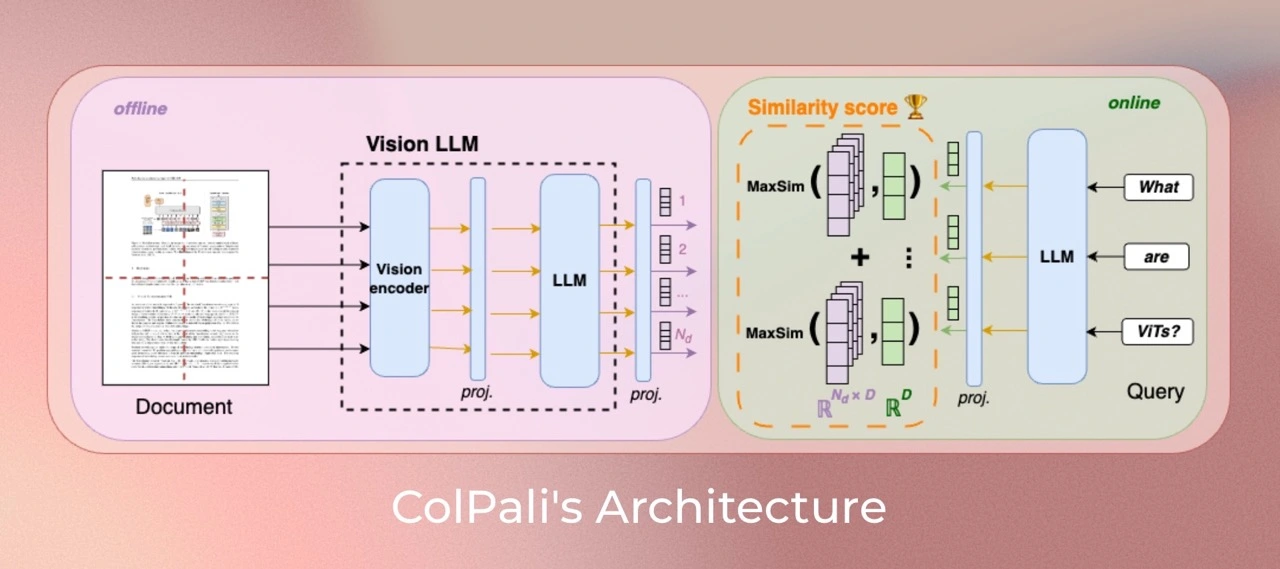
ColQwen-Omniは、ColQwen2とQwen2-VLをベースに構築されたオープンソースのマルチモーダルRAGモデルで、ColBERT検索パラダイムを音声モダリティに拡張した初のオープンソースモデルです。
クロスモーダル検索をサポートし、テキスト、音声、画像などさまざまなモダリティデータを処理できます。学習データセットには127,460件のクエリ-ページペアがあり、63%が公開学術データセットの学習セット、37%が合成データセットで、ゼロショット音声検索能力を備えています。
主なハイライト
クロスモーダル検索:テキストから音声、音声から画像などの検索をサポートし、すべてのモダリティデータが同一のベクトル空間で検索されます。
音動画直接処理:文字起こし不要で、音動画の生データを直接処理し、感情、トーン、視覚的詳細を保持します。
超高速検索:30分の音声を10秒で処理し、短動画の各セグメントは10秒以内、単一クエリは100ミリ秒以内で完了します。
TMRoPE同期:時間に整合したマルチモーダル埋め込みにより、動画/音声フレームを正確にアライメントします。
軽量で高効率:30億パラメータで、Colabの無料GPUで動作します。
ColQwen-Omniの技術詳細
学習戦略:colpali-engine==0.3.11で学習し、Qwen2.5-Omni-3B-Instructをベースに構築、ColBERTスタイルのマルチベクトル表現戦略を採用しています。
学習データ:127,460件のクエリ-ページペアを含み、公開学術データセットと合成データセットをカバーしています。
動的解像度処理:動的な画像解像度入力をサポートし、画像をリサイズまたはクロップせず、原本のアスペクト比を維持します。
ゼロショット音声検索能力:学習データには画像-テキストペアのみ含まれますが、モデルは音声コンテンツを検索可能です。
適用シーン
音動画検索:テキストでTED講演を検索、音声でYouTubeカバー画像を検索など。
ドキュメントQ&A:PDF/画像に対する質問応答、OCR不要でレイアウトやチャートを解析可能。
教育研究:講義動画/レジュメの検索、クロスモーダル分析の実施。
エンターテインメント分析:短動画/ポッドキャストコンテンツの検索、感情や環境音を保持。
プライバシー重視のシーン:Colab上でローカル実行可能で、データをアップロードする必要がありません。
重要な質問
ColQwen2.5-Omniの学習データセットにはどのような特徴がありますか?
このモデルの学習データセットには127,460件のクエリ-ページペアがあり、63%が公開学術データセットの学習セット、37%が合成データセット(ウェブクロールで取得したPDFページおよびVLMが生成した擬似問題を含む)です。データセットは英語のみで構成されており、非英語言語に対するゼロショット汎化性能の研究に適しています。そのうち2%のサンプルが検証用セットとして使用され、ハイパーパラメータのチューニングに用いられます。また、ViDoReと学習セットの両方に複数のPDFドキュメントが同時に使用されることはなく、評価の汚染を回避しています。言語モデルの事前学習コーパスやマルチモーダル学習には多言語データが含まれている可能性があります。
ColQwen2.5-Omniの画像処理はColPaliとどのように異なりますか?
ColQwen2.5-Omniは動的な画像解像度を受け取り、アスペクト比を変更するためにリサイズせず、最大解像度で最大1024個の画像パッチを作成します。一方、ColPaliは画像のアスペクト比を変更します。
ColQwen2.5-Omniを使って音声検索を行うにはどうすればよいですか?
まず0.3.11以上のバージョンのcolpali-engineをインストールします(pip install git+https://github.com/illuin-tech/colpaliでインストール可能)。次に必要なライブラリをインポートし、モデルとプロセッサをロードします。音声データセットを処理してデータローダーを作成し、音声埋め込みベクトルを生成します。最後に検索関数を定義し、クエリテキストを入力、モデルでクエリ埋め込みベクトルを生成して音声埋め込みベクトルとスコアリングし、_topk結果を取得することで、対応する音声を表示できます。
プロジェクトリンク
GitHubアドレス:https://github.com/illuin-tech/colpali。
モデルアドレス:https://huggingface.co/vidore/colqwen-omni-v0.1。









