
 脚本プランナー▸
 AIアプリ
 AIニュース
DreamActor-H1:商品を紹介する人物動画を生成、带货動画に最適
小编 ·

DreamActor-H1:商品を紹介する人物動画を生成、带货動画に最適
DreamActor-H1は字节跳动が2025年6月に発表した動画生成フレームワークで、拡散変換器(DiT)技術に基づき、主にEC・デジタルマーケティング分野向けに設計されており、商品紹介動画の生成に使用できます。
このフレームワークは、人体画像と商品画像をペアにして、高品質な人物と商品のデモ動画を生成することができます。大規模な混合データセットを用いて多カテゴリ拡張トレーニングを行っており、人物と商品のアイデンティティ情報を保持しながら、物理法則に沿った自然なデモ動作を生成する点で既存手法よりも優れており、パーソナライズされたEC広告やインタラクティブメディアに適しています。3Dボディメッシュテンプレートと商品バウンディングボックスを用いて正確な動作ガイダンスを提供し、VAEエンコードによる外観ガイダンス、構造化テキストエンコードによるカテゴリレベルのセマンティクス、参照アテンション、オブジェクトアテンションなどの仕組みを組み合わせることで、既存フレームワークが抱えていたアイデンティティ保持と空間関係理解の課題を解決しています。
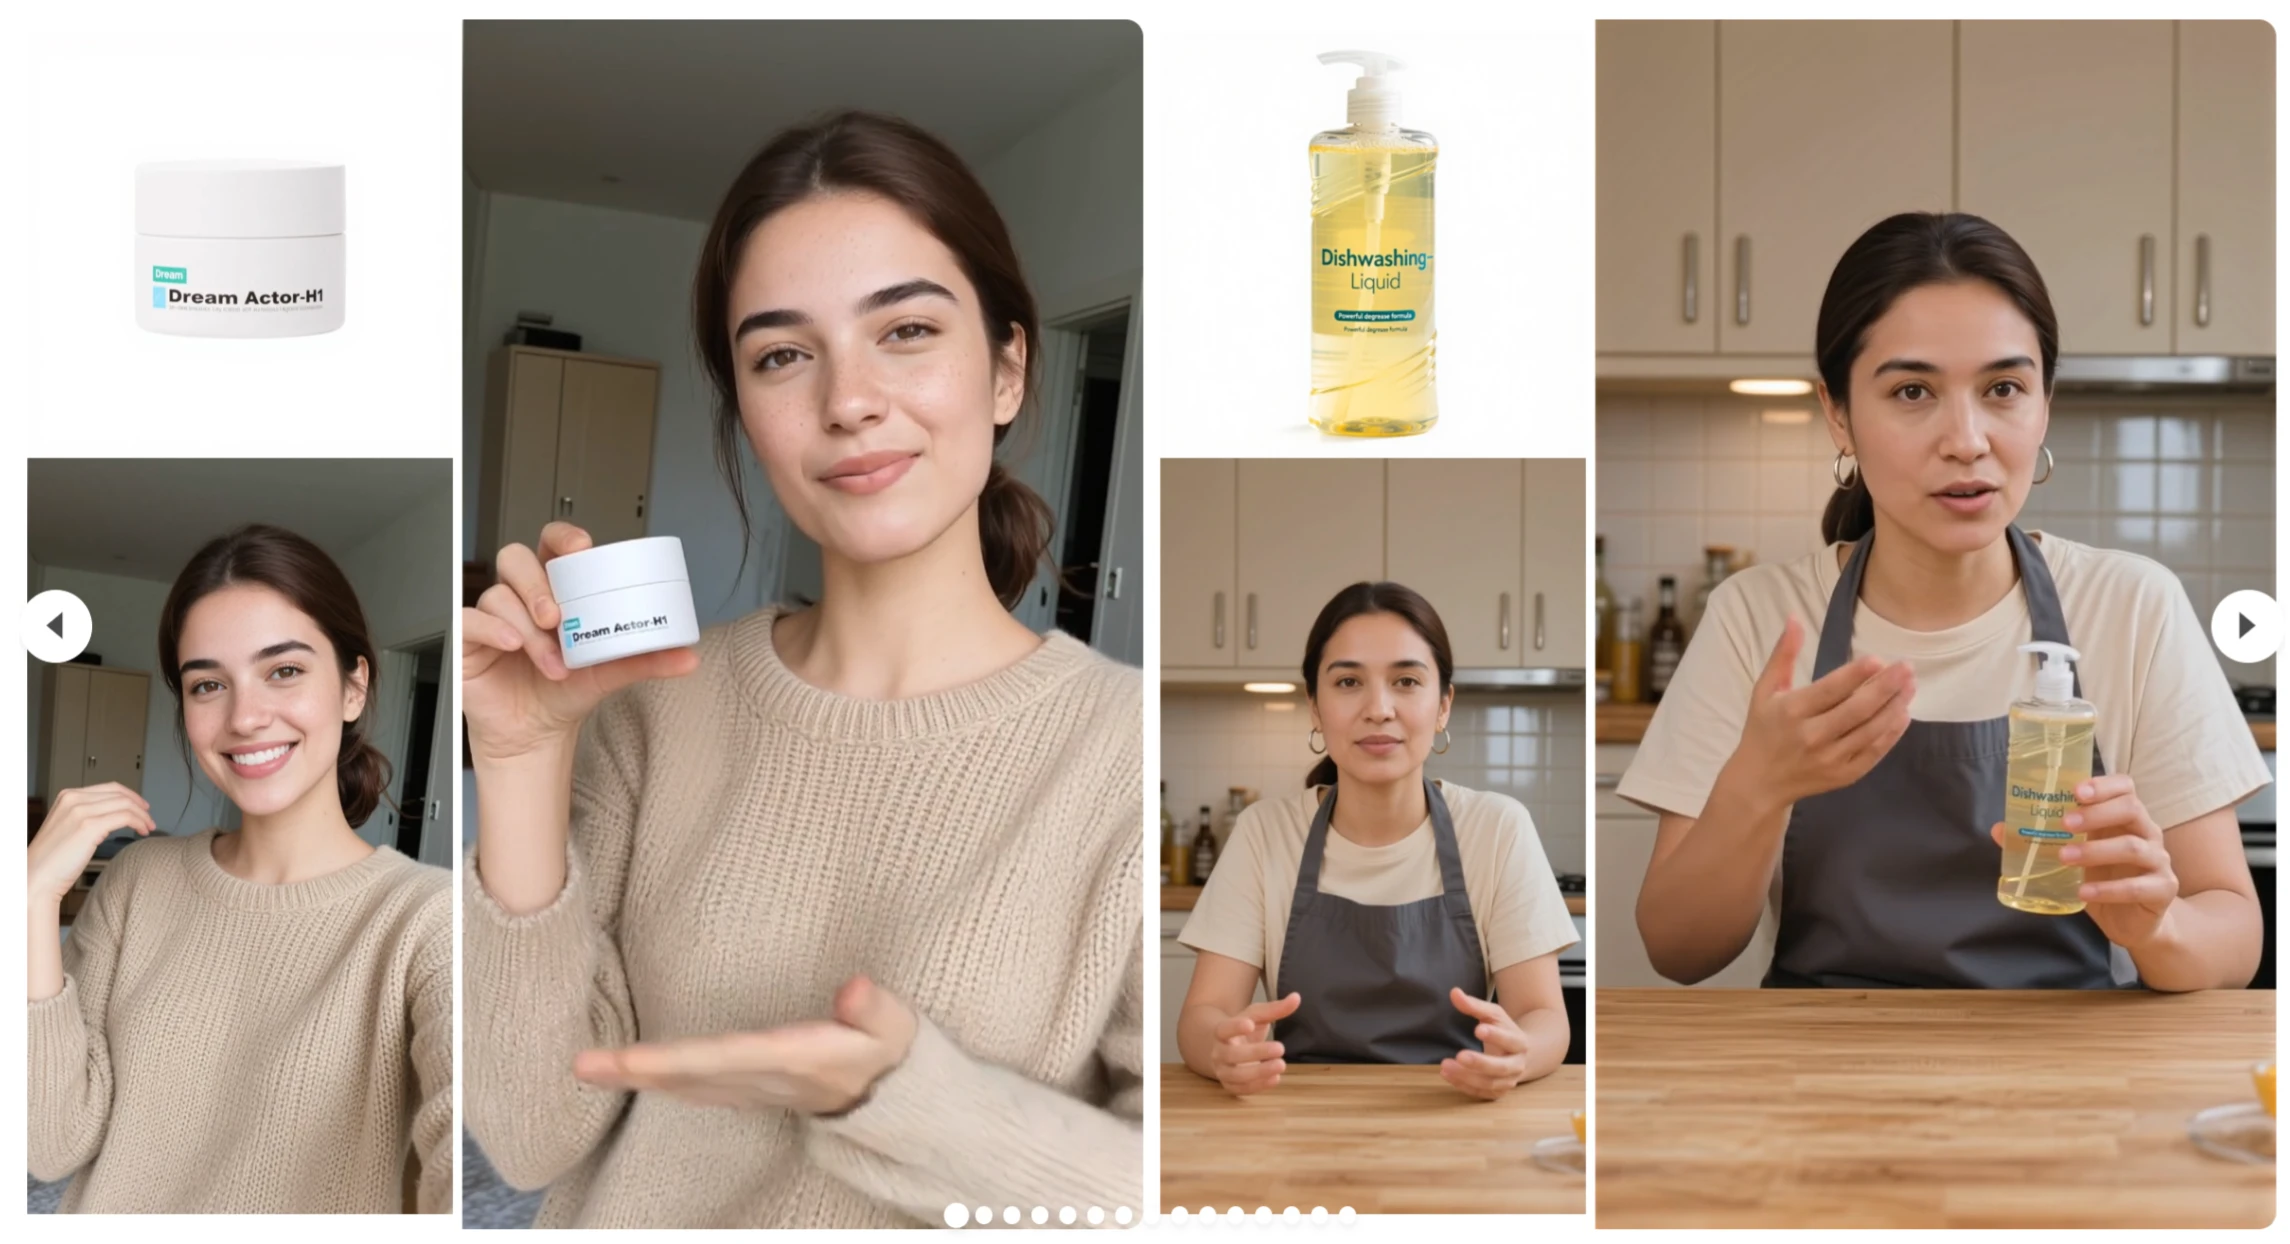
DreamActor-H1の主な優位性:
人-物の動的整合:ジェスチャーと商品の位置を自動的にマッチングします。例えば「化粧品を持ち上げる」動作では、指とボトルとの接触点が自然にフィットし、めり込みや位置ずれが発生しません。さらに3D人体メッシュテンプレートと商品バウンディングボックスによるガイダンスにも対応し、重力や握り角度などの物理法則に沿った動作を保証します。
多次元ディテール再現:人物のアイデンティティ一貫性の保持においては、髪型や肌の色などの特徴を維持します。商品については、マテリアルテクスチャ、ロゴなどのディテールを高い精度で忠実に再現できます。
セマンティクス強化による3D一貫性:「口红を回転させて見せる」のようなカテゴリレベルのテキスト記述を組み合わせることで、微小な回転時の映像がよりスムーズになり、商品のブレや変形を防ぎます。
技術原理:
データ処理段階:視覚言語モデリング(VLM)が「スマホを手に持って回転させる」などのテキスト指示を解析します。次に姿勢推定によって人体のスケルトンを生成し、商品バウンディングボックスと組み合わせて空間関係を構築し、動作特徴を抽出します。
モデルアーキテクチャ設計:グローバルアテンションが画面全体の時間的整合性を制御し、参照アテンションが人物や商品の参照画像の特徴を注入し、オブジェクトアテンションが商品の潜在表現を専門的に処理してディテールの損失を防ぎます。3つのアテンション機構を備えた拡散変換器(DiT)は、70億パラメータの基礎モデルSeaweed-7Bをベースに、マスク化クロスアテンションを通じて人物と商品の情報を融合します。
推論最適化:あらかじめ定義された動作テンプレートライブラリを動的に検索し、商品枠のスケールを調整します。例えば小型サイズの商品の枠は拡大することができます。
DreamActor-H1のユースケース:
ECライブ配信:バーチャル主播が商品を手に持ってデモンストレーションする動画を自動生成でき、ライブ配信コストを削減し、効率を向上させます。
広告マーケティング:多角度の商品使用アニメーションを低コストで制作できます。例えばシューズを回転させて見せることで、消費者の関心を引きつけます。
DreamActor-H1の限界:
商品の制約:現在、中小サイズの物品のみ対応可能で、大型家電などは処理できません。
動作テンプレートへの依存:「テーブルの上の物を拾う」のような動作を事前に定義し、初期人物姿勢とのマッチングに依存する必要があります。
動的なアーティファクト:高速動作時には、商品のテクスチャにちらつきが発生する場合があります。
DreamActor-H1を使った商品紹介動画の生成フロー:
素材準備:人物画像と商品画像を1枚ずつ用意します。人物画像は正面からの上半身写真が推奨され、生成される動画で人物の特徴がはっきり映るように解像度を800×800以上にする必要があります。商品画像は、ロゴやテクスチャなど細部がはっきり確認できるものを選んでください。
テキスト指示の入力:商品紹介のニーズに応じて、「スマホを手に持って回転させる」「口紅のディテールを見せる」などのカテゴリレベルのテキスト記述を入力し、動画生成に具体的な動作と表示要件を提供します。
動画生成:用意した素材とテキスト指示をDreamActor-H1システムに入力すると、システムは多段階協調アーキテクチャとハイブリッドアテンション機構に基づいて処理を行います。データ処理段階では視覚言語モデリング(VLM)がテキスト指示を解析し、動作特徴抽出モジュールが姿勢推定で人体スケルトンを生成して商品バウンディングボックスと組み合わせて空間関係を構築します。モデルアーキテクチャではグローバルアテンション、参照アテンション、オブジェクトアテンションが協調して動作し、最終的に高 fidelityなヒューマン-オブジェクトインタラクションデモ動画を生成します。
プロジェクトURL:
プロジェクトホームページ:https://submit2025-dream.github.io/DreamActor-H1/
技術論文:https://arxiv.org/abs/2506.10568









