
 脚本プランナー▸
 AIアプリ
 AIニュース
TableRAG:テーブル理解に特化した検索拡張生成フレームワーク
小编 ·

TableRAG:テーブル理解に特化した検索拡張生成フレームワーク
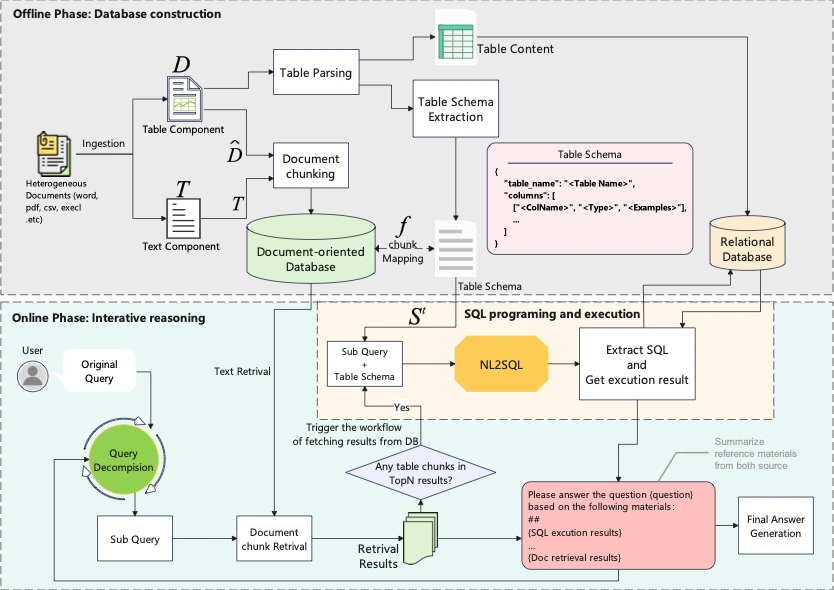
TableRAGは、異種ドキュメント问答における構造情報の損失や全体像の欠如といった問題を解決するためのフレームワークです。SQL実行とテキスト検索を組み合わせることで、表形式のデータを統一的に理解し、複雑な操作を行うことができます。このフレームワークには、オフラインのデータベース構築と4ステップのオンライン反復推論プロセスが含まれています。新しいベンチマークであるHeteQAや他の公開ベンチマークテストにおいて、TableRAGは優れた性能を発揮し、既存のRAGやプログラム的手法を超えて、複雑な異種ドキュメント推論を処理する先進的なソリューションとなっています。
コア原理
クエリ拡張と検索:TableRAGは、クエリ拡張、スキーマ検索、セル検索を通じて、表内の重要な情報を特定します。スキーマとセル値それぞれに対して独立したクエリを生成し、単一のクエリによる冗長な情報を回避します。
スキーマ検索:ai言語モデルは、列名からキーとなる列とそのデータ型を認識でき、列全体をエンコードする必要がありません。例えば、「財布の平均価格はいくらですか?」という質問に対して、言語モデルは「製品」や「価格」といった列名クエリを生成します。
セル検索:言語モデルが生成したクエリに基づき、質問に関連する列名とセルを検索します。例えば、「財布」に関連するセル値を検索します。
頻度認識型切り詰め:セル符号化の予算Bを導入し、異なる値の数Bを超える場合、出現頻度が高い上位B個の値のみを符号化します。
TableRAG主要モジュール
online_inference/main.py:TableRAGの中核となる推論コードであり、TableRAGクラスを含み、オンライン推論の主要なロジックを実装しています。
offline_data_ingestion_and_query_interface/src/interface.py:Flaskフレームワークを使用してSQLクエリインターフェースを提供します。
online_inference/tools/sql_tool.py:SQL生成と実行のツール関数を含み、リトライ機構をサポートしています。
offline_data_ingestion_and_query_interface/src/sql_alchemy_helper.py:SQLAlchemyデータベース操作の補助クラスを提供し、データの挿入とクエリをサポートします。
offline_data_ingestion_and_query_interface/src/service.py:TableRAGリクエストを処理する中核ロジックで、LLMからSQL文を取得して実行することを含みます。
online_inference/chat_utils.py:LLM生成結果を取得するツール関数を含み、異なるAPIバックエンドをサポートします。
offline_data_ingestion_and_query_interface/src/data_persistent.py:DataFrameの列名をクリーニングするためのツール関数です。
offline_data_ingestion_and_query_interface/src/handle_requests.py:大規模モデルの推論インターフェースを呼び出し、例外キャッチと指数バックオフリトライ機構を含みます。
online_inference/tools/retriever.py:セマンティック検索とハイブリッドドキュメント検索の機能を実装し、リコールとリランキングを含みます。
優位性
高効率なデータ符号化:スキーマ検索とセル検索を通じて、TableRAGは言語モデルへの入力長を削減し、表のサイズに依存しないため、符号化効率が向上し、計算コストが低下します。
情報損失の削減:检索されたスキーマとセルのみを言語モデルに提供することで、表全体を処理することによる重要な情報の損失を回避します。
推論能力の向上:TableRAGは重要な情報を提供することで、言語モデルのテーブル推論能力を強化します。
TableRAG応用シーン
データ分析とレポート生成:大規模な表形式データの処理が必要なシナリオ、例えばデータ分析、レポート生成、財務報表処理などに適しています。
クロステーブルQ&A:表に基づく事実検証、シングルホップやマルチホップのテーブル質問応答などのタスクを処理できます。
実験検証
研究者は、ArcadeおよびBIRD-SQLデータセットに基づく百万規模のトークンベンチマークテストを開発し、大規模テーブル理解タスクにおけるTableRAGの性能を評価しました。実験結果は、TableRAGが検索品質と大規模テーブル理解性能の面で既存手法を上回っていることを示しています。
プロジェクトリンク
Github:https://github.com/yxh-y/TableRAG









