
 脚本プランナー▸
 AIアプリ
 AIニュース
Nanonets-OCR-s:画像内の表をMarkdownに変換するモデル
小编 ·

Nanonets-OCR-s:画像内の表をMarkdownに変換するモデル
Nanonets-OCR-sとは?
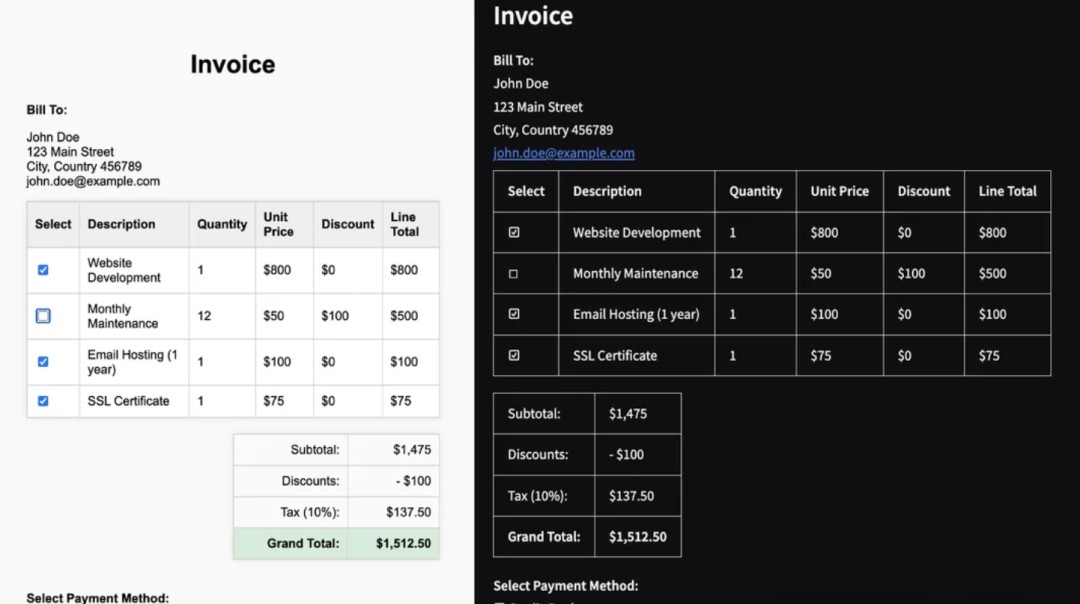
Nanonets-OCR-sは、画像内の表をMarkdown形式に変換し、LaTeX構文も認識できます。また、画像の位置を検出して<img>タグに変換することも可能です。署名は<signature>タグに変換され、チェックボックスなどの記号は顔文字で表現されます。結合セルを含む表の処理にも対応し、HTML形式で出力できます。このモデルのサイズは3.75Bで、Qwen2.5-VL-3B-Instructをファインチューニングしたものであるため、中国語のサポートが充実しています。
機能ハイライト
表変換:複雑な表を正確に抽出し、明確なMarkdownおよびHTML形式に変換できます。
数式認識:文書内の数式を正確にLaTeX構文に変換でき、インライン数式も独立した数式も簡単に対応します。
画像処理:文書内の画像を自動的に認識し、<img>タグで記述するため、後処理が容易になります。
署名と透かしの抽出:文書内の署名と透かしを検出し、それぞれ<signature>と<watermark>タグでマークします。
チェックボックス処理:文書内のチェックボックスやラジオボタンを標準的なUnicode記号に変換し、読み取りや編集を容易にします。
使用方法
Pythonライブラリ経由:
必要なライブラリ(transformersなど)をインストールします。
事前学習済みモデルを読み込み、画像を処理して内容を抽出します。
サーバーインターフェース経由:
サーバーを起動し、Pythonと関連クライアントを通じてリクエストを送信して、変換結果を取得します。
簡略化されたツール経由:
docextなどのツールを使用して、ワンクリックでアプリケーションを起動し、操作フローを簡素化します。
適用シーン
学術研究:論文内の数式、図、表を編集可能なMarkdown形式にすばやく変換し、整理やさらなる研究に役立てます。
ビジネス業務:契約書やレポートなどのファイルを処理し、重要な情報を抽出してフォーマットの一貫性を保ち、業務効率を向上させます。
法律分野:署名や透かしなどの重要な要素を識別・分離し、文書の完全性と正確性を確保します。
優位性
強力な機能:さまざまな文書要素を認識し、さまざまなシーンのニーズに対応します。
スマートで効率的:スマートな認識とセマンティックタグ付けにより、出力内容が処理しやすくなります。
軽量で便利:モデルサイズが適度で、既存技術に基づいて最適化されており、中国語をサポートします。
プロジェクトアドレス
https://huggingface.co/nanonets/Nanonets-OCR-s









