
 脚本プランナー▸
 AIアプリ
 AIニュース
Agentic-Doc:複雑なドキュメントから構造化データを抽出するLandingAIのPythonライブラリ
小编 ·

Agentic-Doc:複雑なドキュメントから構造化データを抽出するLandingAIのPythonライブラリ
Agentic-Doc紹介
agentic-docはLandingaiが発表したPythonライブラリで、複雑なドキュメント(PDF、画像、URLを含む)から構造化データを抽出するために特化しています。このライブラリは関連APIをラップしてユーザーの操作を容易にします。100ページ以上の超長尺ドキュメントを処理できるだけでなく、リクエスト失敗時のリトライ、並行タスクの管理、レート制限の遵守など、ネットワーク問題に自動対応します。さらに、可視化デバッグツールも搭載されており、データ抽出プロセスの理解と最適化に役立ちます。このライブラリはAPIの使用を簡素化し、大容量ファイルを自動的に小さなチャンクに分割して並列処理し、結果をマージします。また、エラー処理とバッチ処理機能を備えており、ユーザーがドキュメントデータをより便利に処理できるようにします。
Agentic-Docのコア機能
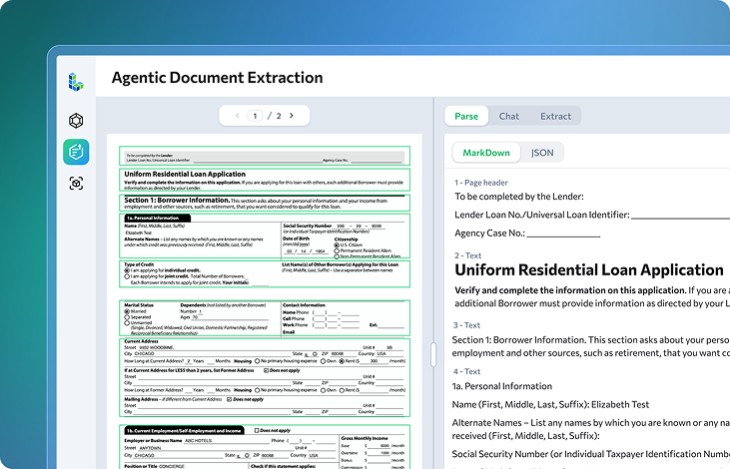
複雑なドキュメント処理:テーブル、画像、動的ページレイアウトなど、複雑なドキュメントレイアウトからデータを抽出できます。
長尺ドキュメント対応:100ページを超えるPDFドキュメントを一度に処理できます。
自動処理:並列処理、タイムアウト、レート制限の問題に自動対応します。
補助ツール:バウンディングボックススライスや可視化デバッガーなどのツールを提供します。
構造化出力:階層化されたJSONおよびMarkdown形式でデータを出力します。
バッチ処理:複数のドキュメントのバッチ処理をサポートし、並列処理で効率を向上させます。
エラー処理:一般的なHTTPエラー(408、429、502、503、504など)を自動的にリトライします。
Agentic-Docの技術的特徴
Pythonベース:Python3.9〜3.12バージョンをサポートします。
APIキー管理:環境変数または.envファイルでAPIキーを設定します。
自動分割とマージ:大容量ファイルを自動分割して並列処理し、その後結果をマージします。
RESTAPIのラップ:RESTAPIの呼び出しを簡素化し、大容量ファイルの自動処理や複数ドキュメントの並列処理などの機能を提供します。
Agentic-Docの応用シナリオ
ドキュメントのデジタル化:紙文書やスキャン画像を構造化データに変換します。
データ抽出:大量の複雑なドキュメントから重要な情報を抽出します。
テーブルとチャートの解析:テーブルとチャート内のデータを自動認識して抽出します。
業界応用:金融、物流、医療、保険、法律など、複雑なドキュメントの分析と処理が必要な業界に適しています。
Agentic-Docのインストールと使用方法
インストール:pip install agentic-doc でインストールします。
設定:APIキーを環境変数として設定します。
対応ファイル形式:PDF、単一画像、URLに対応しています。
基本的な使用方法:ドキュメントを解析して構造化データを返すシンプルな関数呼び出しを提供します。
Agentic-Docの優位性
効率的な処理:手動による介入を削減し、ドキュメント処理の自動化レベルを向上させます。
高精度な抽出:複雑なドキュメントレイアウトにも適用できる、より正確な抽出結果を提供します。
自動化機能:大容量ファイルやバッチドキュメントを自動処理します。
プロジェクトリンク
github:https://github.com/landing-ai/agentic-doc
公式サイト:https://landing.ai/agentic-document-extraction









