
 脚本プランナー▸
 AIアプリ
 AIニュース
VRAG-RL:阿里通義チームが発表した視覚認識ベースのRAGフレームワーク
小编 ·

VRAG-RL:阿里通義チームが発表した視覚認識ベースのRAGフレームワーク
VRAG-RLとは?
VRAG-RLは、アリババ通義(Qwen)チームが最近発表した、視覚認識RAGフレームワークに基づくモデルです。このモデルは、Qwen2.5-VL-3Bで性能を30%、Qwen2.5-VL-7Bで20%向上させています。
VRAG-RLは強化学習によるトレーニングを通じて、モデルに複数ターンの思考・推論能力を持たせ、視覚言語モデル(VLM)の理解力と回答の正確性を段階的に強化します。視覚認識アクション空間を定義することで、モデルが粗から細へと情報密度の高い領域に焦点を当て、重要な視覚情報を正確に抽出できるようにし、VLMの検索、推論、視覚情報理解の能力を向上させます。
さらに、VRAG-RLはマルチモーダル検索と反復推論能力を備えており、複数ターンのインタラクションを通じて視覚情報への理解を段階的に改善し、最終的かつ包括的な回答を生成します。画像理解、チャート分析、複雑なレイアウト解析など、さまざまな視覚タスクに適しています。
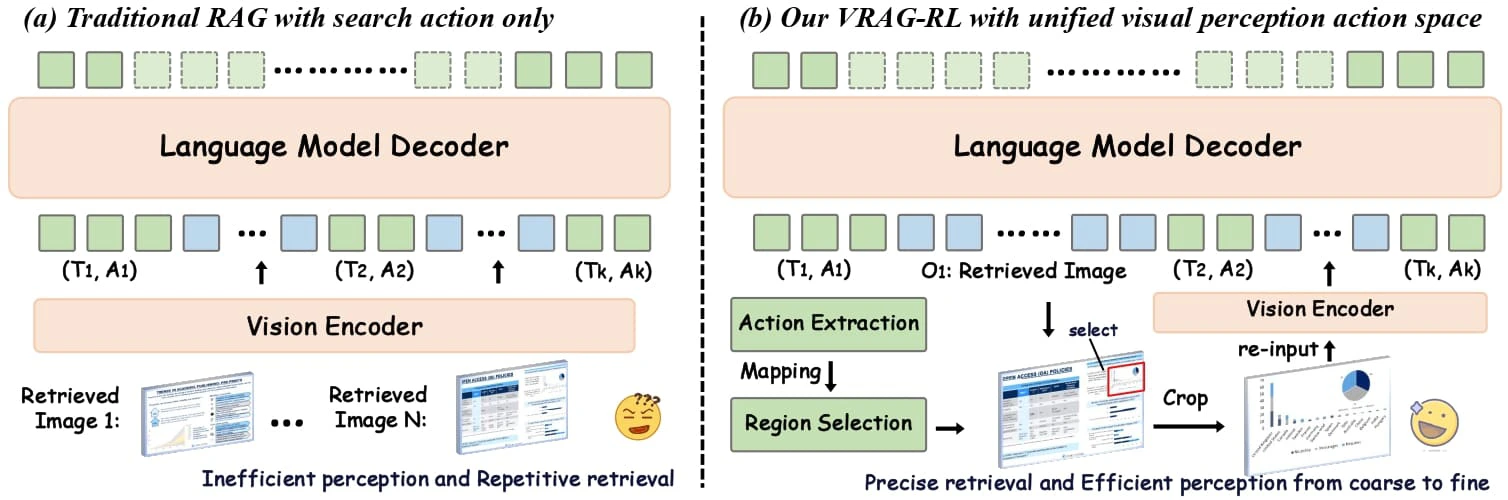
従来のRAG手法の限界
視覚情報処理能力の不足:画像内の情報を効果的に解析できず、視覚データの理解や推論能力が欠如している。
固定されたプロセスによる動的推論の制限:多くが固定された検索 - 生成フローを採用しており、複雑なタスクで推論パスを動的に調整することが難しく、モデルが視覚情報を掘り下げる能力を制限している。
検索効率と推論の深度の不足:複雑な視覚タスクを処理する際に、重要な情報を効率的に特定できず、生成結果の精度が不十分になる傾向がある。
VRAG-RLの主要な革新
視覚認識アクション空間:領域選択、切り取り、ズームなど、さまざまな視覚認識アクションを導入し、モデルが粗粒度から細粒度へと段階的に情報密度の高い領域に焦点を当て、重要な視覚情報を正確に抽出できるようにする。この粗から細への認識アプローチは、視覚情報に対するモデルの理解能力を向上させるだけでなく、検索効率も大幅に向上させる。
強化学習フレームワーク:強化学習(RL)を通じてモデルの推論能力と検索能力を最適化する。モデルは検索エンジンと複数ターンでインタラクションし、単一ターンまたは複数ターンの推論軌道を自律的にサンプリングし、サンプルに基づいて継続的に最適化する。
総合的な報酬機構:検索効率報酬、モード一貫性報酬、モデルに基づく結果報酬を含む総合的な報酬関数を設計。この報酬機構は最終結果に注目し、モデルがより効果的に関連情報を取得できるように検索プロセスを最適化する。
マルチエキスパートサンプリング戦略:大規模モデルの推論能力とエキスパートモデルの正確なアノテーション能力を組み合わせることで、モデルがより効果的な視覚認識戦略を学習できるようにする。
複数ターンインタラクショントレーニング:複数ターンのインタラクショントレーニング戦略に基づき、モデルは外部環境との継続的なインタラクションを通じて推論プロセスを段階的に最適化し、推論の安定性と一貫性を向上させる。
VRAG-RLの技術的優位性
性能の向上:実験結果によると、VRAG-RLは複数の視覚言語ベンチマークデータセットにおいて、既存の手法を大幅に上回る性能を達成している。タスクタイプは、シングルホップからマルチホップ推論、純粋なテキスト理解からチャート認識、複雑なレイアウト解析まで、さまざまな視覚情報豊富なシナリオを網羅している。
複数ターンインタラクションのサポート:推論段階で情報密度の高い領域に段階的に焦点を当て、粗から細へと情報を取得できる。
効率的なトレーニング:業界をリードするGRPOアルゴリズムを導入し、検索エンジンをローカルにデプロイすることで現実世界のアプリケーションシナリオをシミュレートし、検索エンジン呼び出しのコストをゼロに抑え、モデルのトレーニングをより効率的にしている。
VRAG-RLの応用シーン
複雑なチャート分析:財務レポートや科学チャートから重要なデータを抽出する。
デザイン原稿の解析:デザイン原稿のレイアウトや要素を理解・推論する。
ドキュメント検索:画像やテーブルを含むドキュメント知識ベースから情報を効率的に検索する。
マルチモーダルQ&A:テキストと画像を組み合わせてマルチホップ推論を行い、複雑な質問に回答する。
プロジェクトリンク
GitHubリポジトリ:https://github.com/Alibaba-NLP/VRAG
HuggingFaceモデルライブラリ:https://huggingface.co/collections/autumncc/vrag-rl
arXiv技術論文:https://arxiv.org/pdf/2505.22019









