
 脚本プランナー▸
 AIアプリ
 AIニュース
HunyuanVideo-Avatar:テンセント Hunyuan が発表した音声駆動型デジタルヒューマンモデル
小编 ·

HunyuanVideo-Avatar:テンセント Hunyuan が発表した音声駆動型デジタルヒューマンモデル
HunyuanVideo-Avatarとは?
HunyuanVideo - Avatarは、テンセント混元がテンセント混元の動画大規模モデル(HunyuanVideo)を基にオープンソース化した音声デジタルヒューマンモデルです。音声による駆動により、HunyuanVideo-Avatar技術は動的な人物動画を生成し、人物の会話、肢体動作、頭部の動き、表情を表現でき、複数キャラクターが交流するシーンにも対応しています。音声駆動による人物アニメーション分野における3つの課題―高ダイナミックな動画を生成しつつキャラクターの一貫性を維持すること、キャラクターと音声の感情を正確に一致させること、複数キャラクターの音声駆動アニメーションに対応すること―の解決を目的としています。
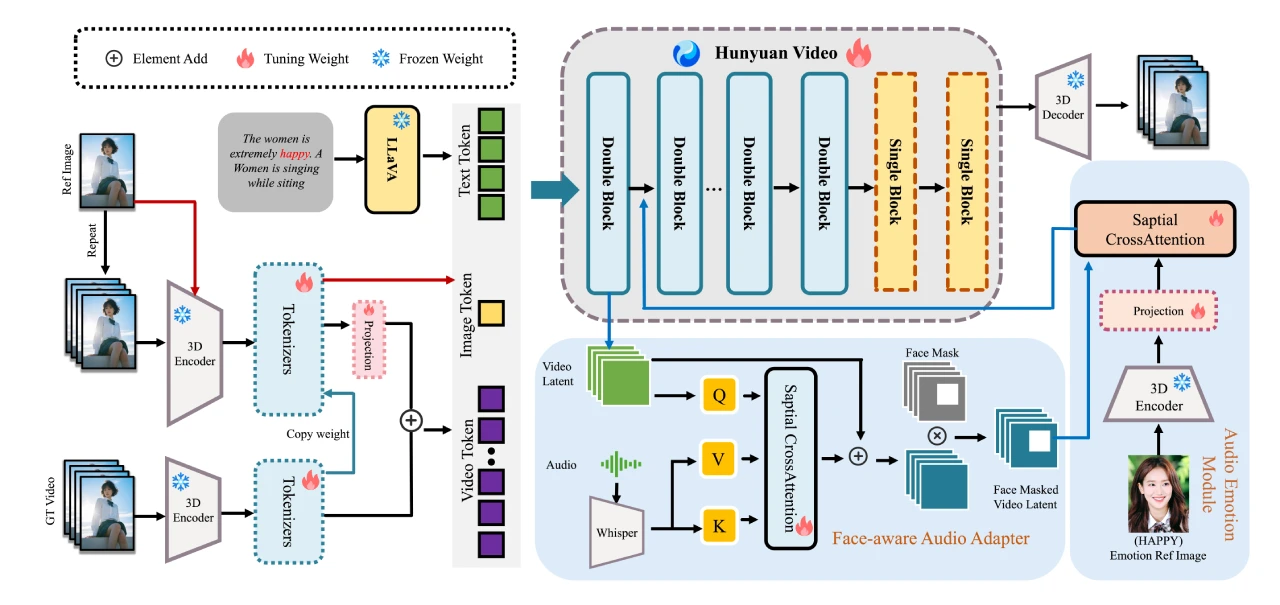
HunyuanVideo - Avatarの機能特徴
複数のシーン対応:頭と肩のアップ、半身、全身などのシーンに対応しており、ユーザーはニーズに応じて適切な撮影視点を選択できます。
多様なスタイルと複数の種シーンに対応:サイバーパンク、2Dアニメ、中国水墨画など複数のスタイル、ロボットや動物などの複数種、ならびに2人掛けのシーンに対応しています。
高い一貫性と高ダイナミックな動画生成:入力された人物画像と音声に基づき、画像と音声の内容を自動的に理解します。例えば、人物がいる環境や音声に含まれる感情などを把握し、画像内の人物に自然に話したり歌わせたりすることで、自然な表情、口の動きの同期、全身の動きを含む動画を生成します。さらに、動画内の主体の一貫性と動画全体のダイナミズムを保証します。
幅広い応用シーン:ショート動画制作、Eコマース、広告など多様な応用シーンに適しており、人物が異なるシーンで話したり、対話したり、演技したりするクリップを生成できます。製品紹介動画や複数人インタラクション広告を迅速に制作でき、制作コストを効果的に削減します。
複数キャラクターの精密な駆動:複数人のインタラクションシーンにおいて、複数キャラクターを精密に駆動し、口の動き、表情、動作と音声の同期を確保することで、自然なインタラクションを実現します。
HunyuanVideo - Avatarの技術革新
キャラクター画像注入モジュール:マルチモーダル拡散Transformer(MM - DiT)アーキテクチャに基づき、キャラクターの一貫性と動画のダイナミズムを確保し、動画生成時における人物像の高い一貫性の維持と、滑らかで自然な人物動作の実現という課題を解決します。
音声感情モジュール(AEM):音声と参照画像から感情情報を抽出し、繊細な表情と動作を生成することで、デジタルヒューマンが音声の感情に応じた表情を表現できるようにします。
顔認識音声アダプター(FAA):顔マスク技術によりキャラクターの音声を分離し、複数人シーンでの精密な駆動を実現します。異なる人物の口の動きや表情を独立して駆動でき、異なる人物間の動作の相互干渉を回避します。
HunyuanVideo - Avatarの使用方法
テンセント混元公式サイト(https://hunyuan.tencent.com/)の「モデル広場 - 混元生動画 - デジタルヒューマン - 音声駆動 - HunyuanVideo - Avatar」から体験できます。現在は14秒以内の音声のアップロードによる動画生成に対応しています。
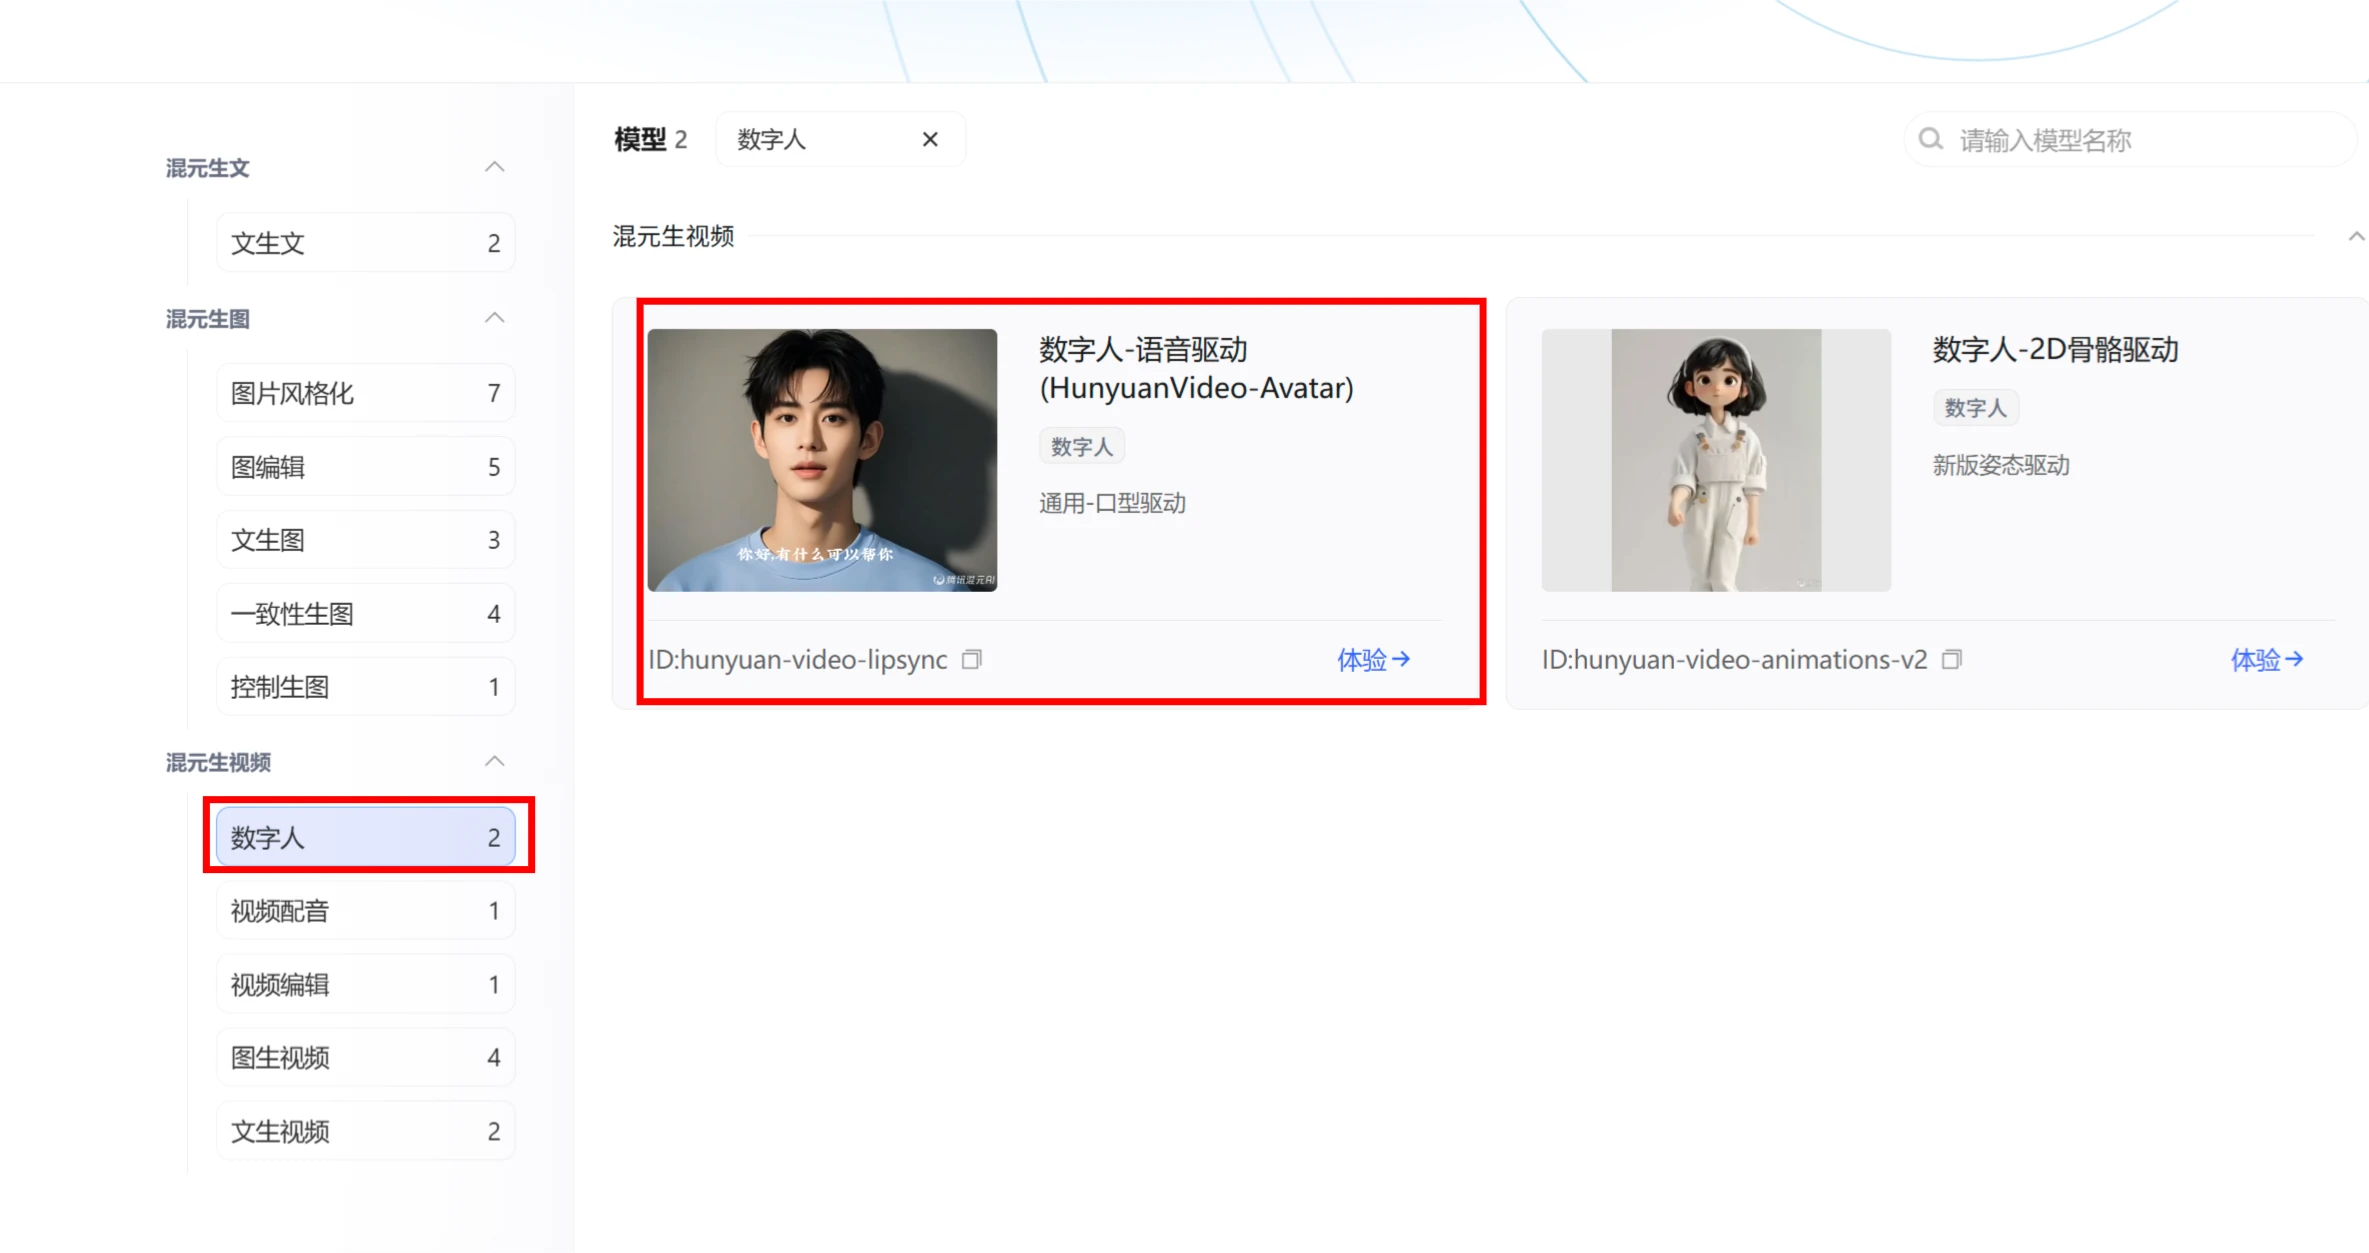
HunyuanVideo - Avatarの応用シーン
ショート動画制作:さまざまなシーンでの対話、演技などの動画クリップを迅速に生成できます。
Eコマース広告:製品紹介動画、複数人インタラクション広告などの制作に使用されます。
バーチャルアシスタントやゲーム:アニメーションアバターを作成し、インタラクション体験を向上させます。
プロジェクトリンク
プロジェクトページ:https://hunyuanvideo-avatar.github.io
GitHubリポジトリ:https://github.com/Tencent-Hunyuan/HunyuanVideo-Avatar









