
 脚本プランナー▸
 AIアプリ
 AIニュース
Alibaba、QwenLong-L1-32Bを発表:長文コンテキスト推論向けLLM
小编 ·

Alibaba、QwenLong-L1-32Bを発表:長文コンテキスト推論向けLLM
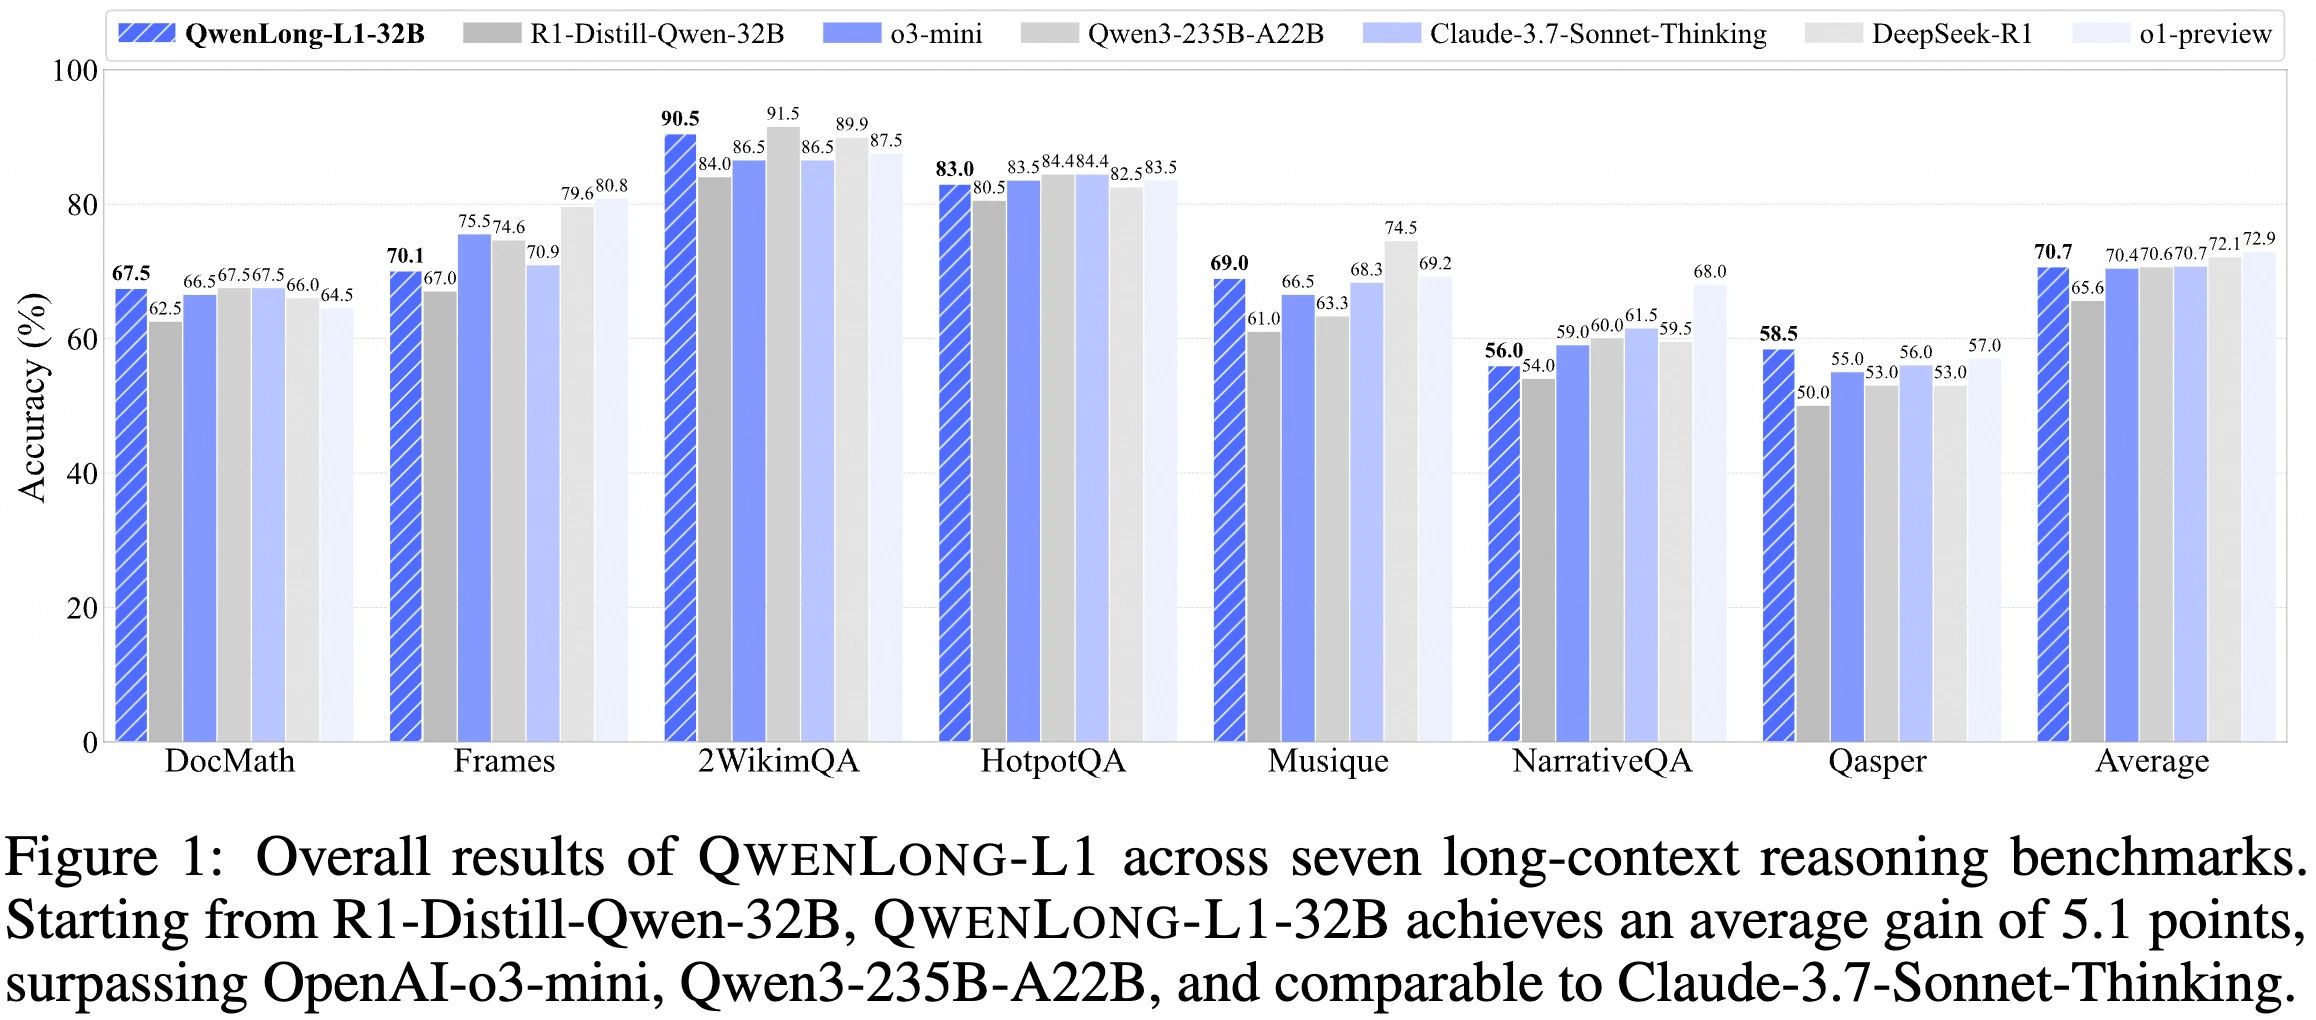
2025年5月26日、阿里巴巴チームがQwenLong-L1-32BとDocQA-RL-1.6Kデータセット(数学、論理、多段階推論の文書質問応答問題1600問を含む)を発表した。強化学習に基づいて訓練された初の長文コンテキスト大規模推論モデルである。そのフレームワークは、ウォームアップ教師あり微調整、カリキュラム誘導強化学習、難易度認識リサンプリング機構により、長文コンテキスト推論の強化学習における訓練効率の低さと最適化プロセスの不安定性という課題を解決し、7つの長文コンテキストDocQAベンチマークで性能がOpenai-o3-miniおよびQwen3-235B-A22Bを上回り、Claude-3.7-Sonnet-Thinkingと同等の性能を達成した。
モデルフレームワーク
基本理念:強化学習(RL)により、短文コンテキストの大規模推論モデル(LRMs)を長文コンテキストシナリオに適応させる。
主要構成要素:
ウォームアップ教師あり微調整(SFT)段階:安定した初期ポリシーの確立。
カリキュラムに基づく段階的強化学習技術:ポリシー進化の安定化。
難易度認識リサンプリング戦略:ポリシー探索の促進。
訓練データ
DocQA-RL-1.6Kという専用の強化学習訓練データセットを使用し、数学、論理、多段階推論の分野を網羅する文書質問応答問題1600問を含む。
性能
7つの長文コンテキスト文書質問応答ベンチマークにおいて、QwenLong-L1-32BはOpenAI-o3-miniやQwen3-235B-A22BといったフラッグシップLRMsを上回る性能を達成し、Claude-3.7-Sonnet-Thinkingと同等のレベルに達し、現在の最先端LRMsの中でリードする性能を示した。
実験設計
数学、論理、多段階推論の分野を網羅する文書質問応答問題1600問を含む、専用のRL訓練データセットDocQA-RL-1.6Kを構築した。
数学推論部分では、DocMathデータセットの問題600問を使用し、そのうち75%を訓練に、25%を評価に使用した。
論理推論部分では、DeepSeek-R1を用いて法律、金融、保険、製造分野の実文書を網羅する多肢選択式問題600問を合成した。
多段階推論部分では、MultiHopRAGとMusiqueからそれぞれ200例ずつサンプリングし、文書横断的な推論を重視した。
2WikiMultihopQA、HotpotQA、Musique、NarrativeQA、Qasper、Frames、DocMathを含む7つの長文コンテキストDocQAベンチマークで評価を行った。
結果と分析
QwenLong-L1-32Bは7つの長文コンテキストDocQAベンチマークで優れた性能を示し、OpenAI-o3-miniやQwen3-235B-A22BといったフラッグシップLRMモデルを上回り、Claude-3.7-Sonnet-Thinkingと同等の性能を達成した。
数学推論ベンチマークDocMathにおいて、QwenLong-L1-32Bは完全一致率およびLLM判定 accuracyで85.3%を達成した。
多段階推論ベンチマークHotpotQAにおいて、モデルの性能は87.6%に達し、既存モデルを大きく上回った。
プロジェクトリンク
Github:https://github.com/Tongyi-Zhiwen/QwenLong-L1
Huggingface:https://huggingface.co/Tongyi-Zhiwen/QwenLong-L1-32B
Modelscope:https://www.modelscope.cn/models/iic/QwenLong-L1-32B









