
 脚本プランナー▸
 AIアプリ
 AIニュース
ParseStudio:PDF解析を簡素化するPythonライブラリ
小编 ·

ParseStudio:PDF解析を簡素化するPythonライブラリ
ParseStudioとは?
PDFドキュメントを処理する際、テキスト、テーブル、画像を抽出するのは煩雑になりがちで、ライブラリによって使い方が異なるため、コードが重複し管理が難しくなることがあります。ParseStudioはこのPythonライブラリで、複数のパーサーを統一されたインターフェースに統合し、数行のコードでPDFドキュメントの解析作業を完了できる简便な方法を提供します。このライブラリはDocling、PyMuPDF、Llama Parseの3つのエンジンを統合しており、テキスト、テーブル、画像の抽出タスクを柔軟に処理できます。ParseStudioの主な特徴には、モジュール化された設計、複数種類のコンテンツを同時に抽出できること、简洁なAPI設計、テーブルを自動的にMarkdown形式に変換できること、画像を抽出する際にメタデータが含まれること、複数のPDFファイルのバッチ処理をサポートしていることが挙げられます。一定のPython基礎を持つ開発者にとって、ParseStudioは実用的なツールです。
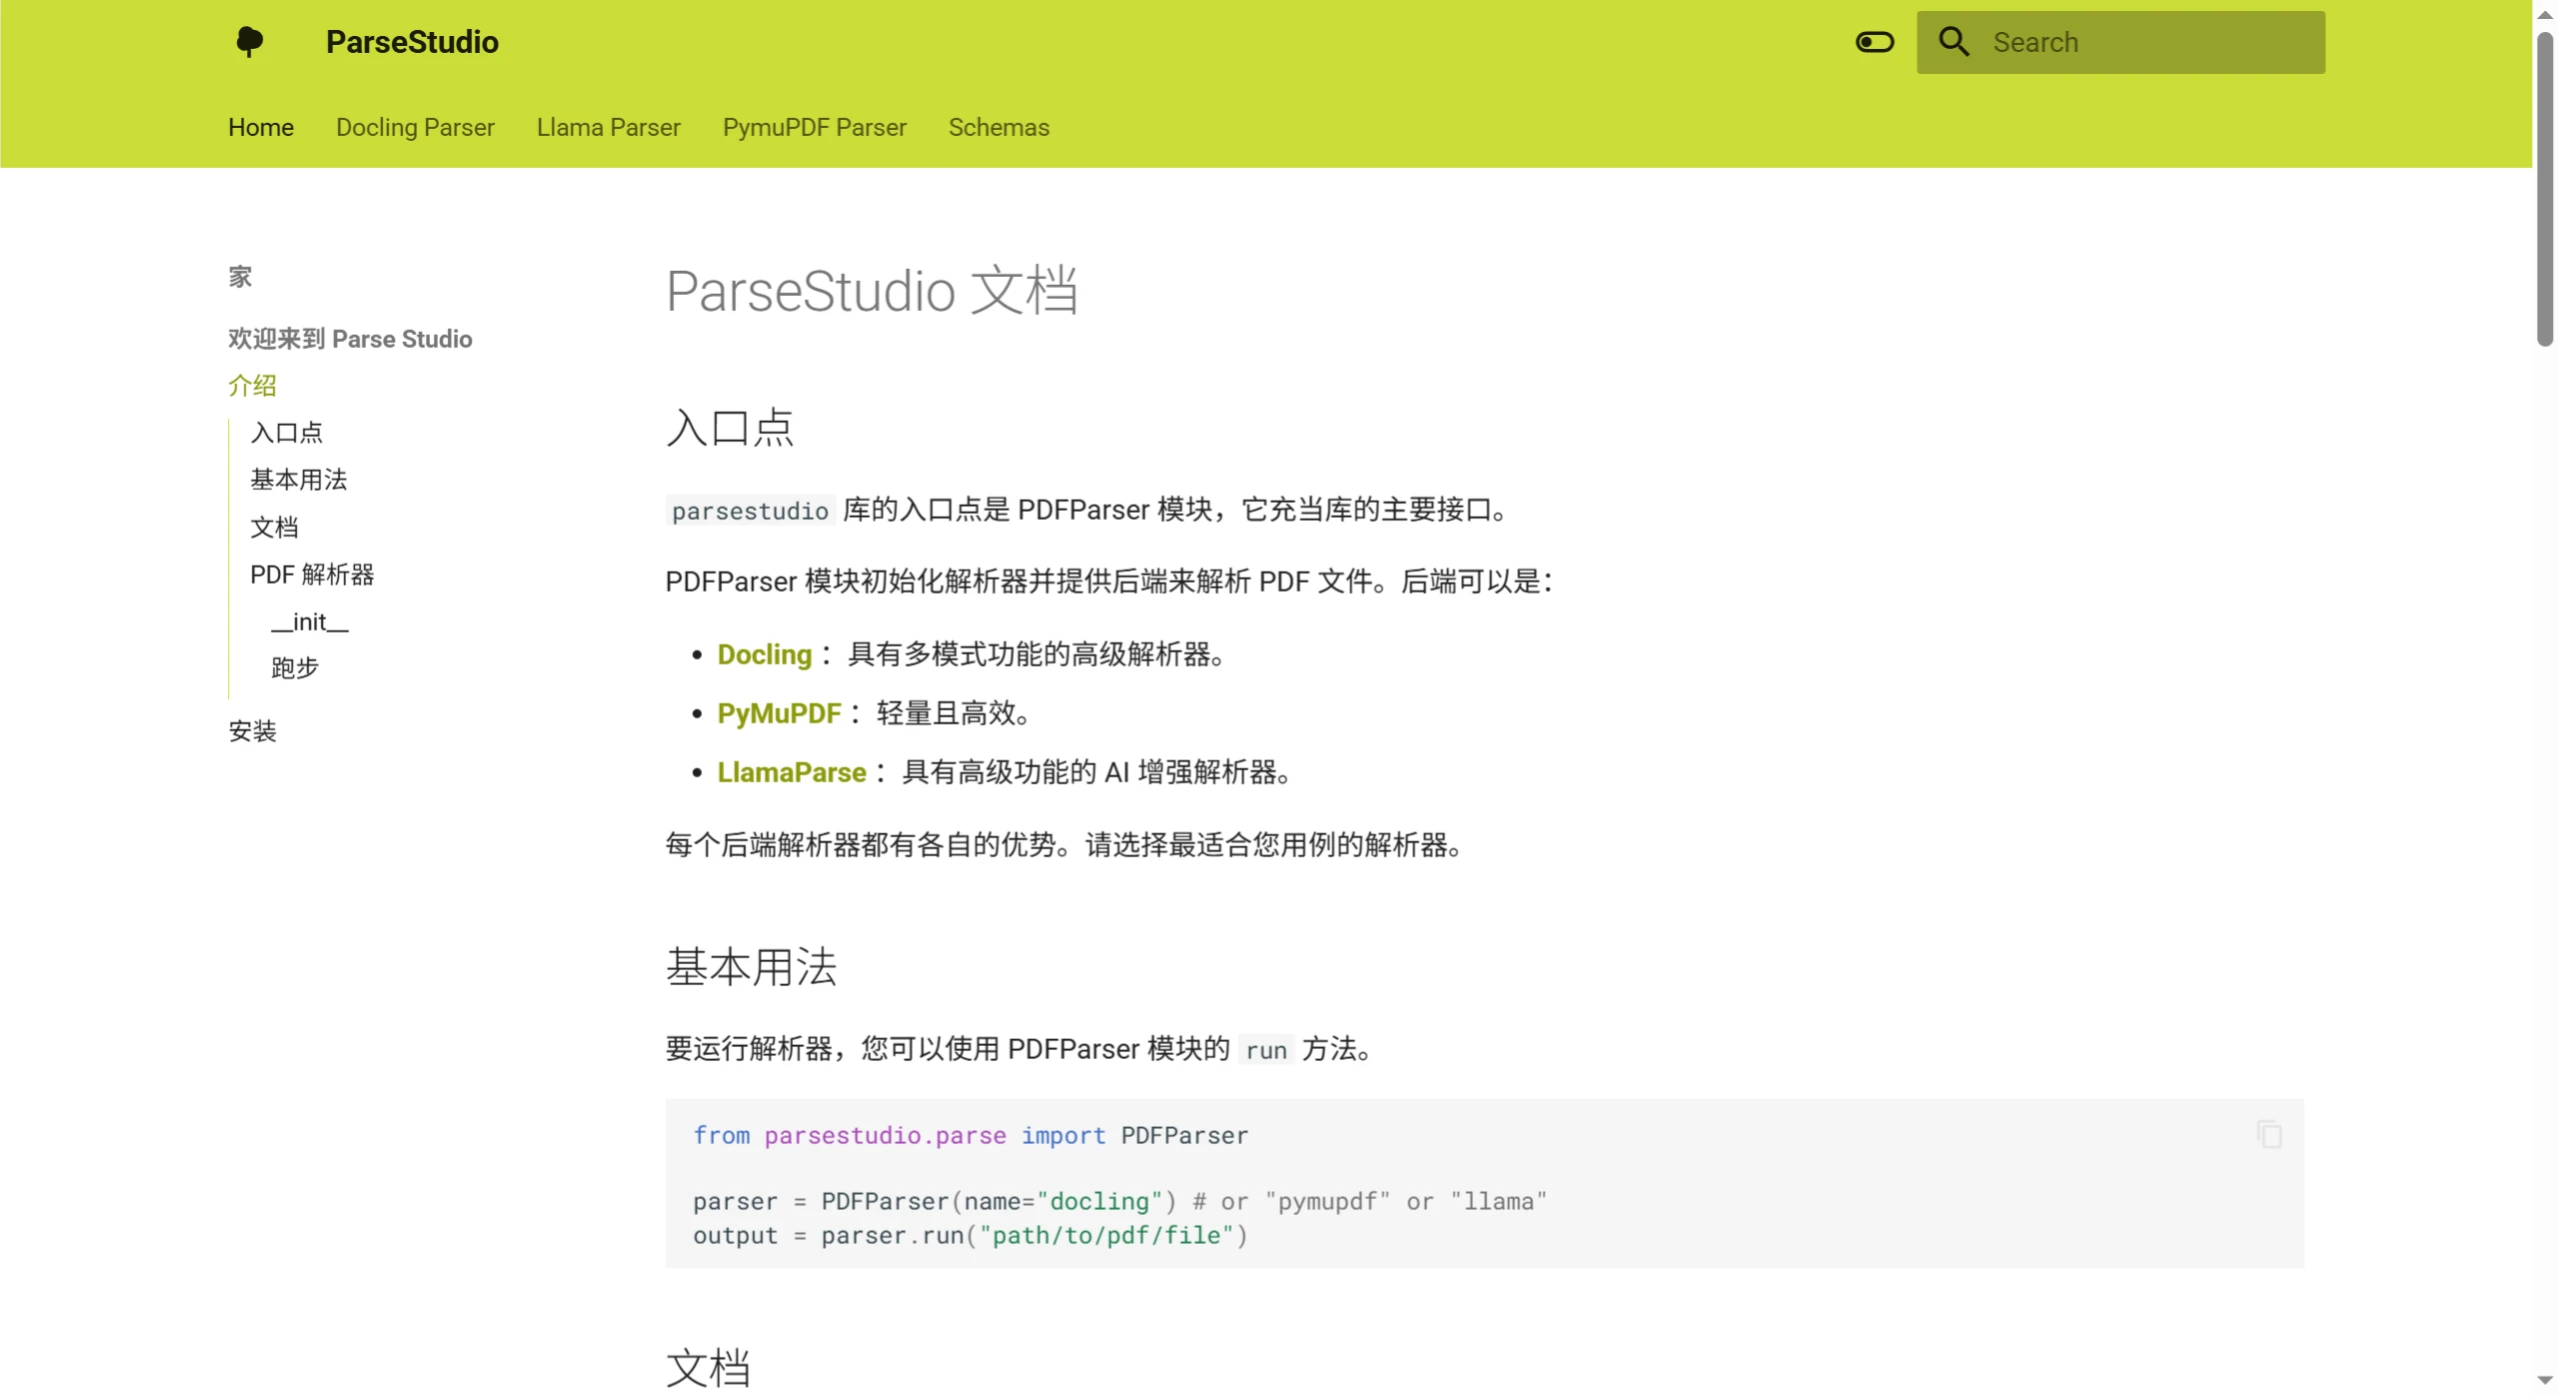
ParseStudioの主な特徴
モジュール化された設計:Docling、PyMuPDF、Llama Parseなど、複数の解析バックエンドから選択でき、異なるニーズに対応できます。
マルチモーダル解析:テキスト、テーブル、画像をシームレスに抽出できます。
統一された構文:統一されたインターフェースを提供することで、異なるバックエンドとの対話を簡素化します。
拡張性:追加のパラメータを通じて解析動作を簡単に調整できます。
ユーザーフレンドリー:バックエンド特有の複雑さを抽象化し、ユーザーがコンテンツの抽出に集中できるようにします。
ParseStudioのインストール方法
pipを使用したインストール:
pip install parsestudio
ソースコードからのインストール:
git clone https://github.com/chatclimate-ai/ParseStudio.git
cd ParseStudio
pip install .
ParseStudioクイックスタート
パーサーのインポートと初期化:
from parsestudio.parse import PDFParser
# 必要なパーサーバックエンドで初期化
parser = PDFParser(parser="docling")  # オプション:"docling"、"pymupdf"、"llama"
PDFファイルの解析:
outputs = parser.run(["path/to/file.pdf"], modalities=["text", "tables", "images"])
# テキストコンテンツにアクセス
print(outputs[0].text)
# テーブルにアクセス
for table in outputs[0].tables:
print(table.markdown)
# 画像にアクセス
for image in outputs[0].images:
image.image.show()
metadata = image.metadata
print(metadata)
サポートされているパーサー
Docling:複雑なドキュメントの詳細なレイアウト分析に適しており、OCRと正確なテーブル抽出をサポートします。
PyMuPDF:軽量で高速、迅速な処理に適しています。
LlamaParse:クラウドベースでAI強化された抽出で、高度な機能を必要とするシナリオに適しています。
Github:https://github.com/chatclimate-ai/ParseStudio









