
 脚本プランナー▸
 AIアプリ
 AIニュース
HRAvatar:単眼動画から高品質な3Dアバターを生成する手法
小编 ·

HRAvatar:単眼動画から高品質な3Dアバターを生成する手法
デジタルヒューマン、VTuber、AR/VRなどの分野が急速に発展する背景の下、リアルで動的、かつ再照明可能な3Dアバターを効率的に生成することが重要な課題となっています。しかし、単眼動画から高品位なアニメーション可能なアバターを生成するには依然として多くの課題があり、既存の3Dガウシアン(3DGS)に基づく手法には、ジオメトリ変形における柔軟性の不足、表情追跡の精度の低さ、現実的な再照明の実現が困難であるなど、再構成品質にいくつかの制限があります。
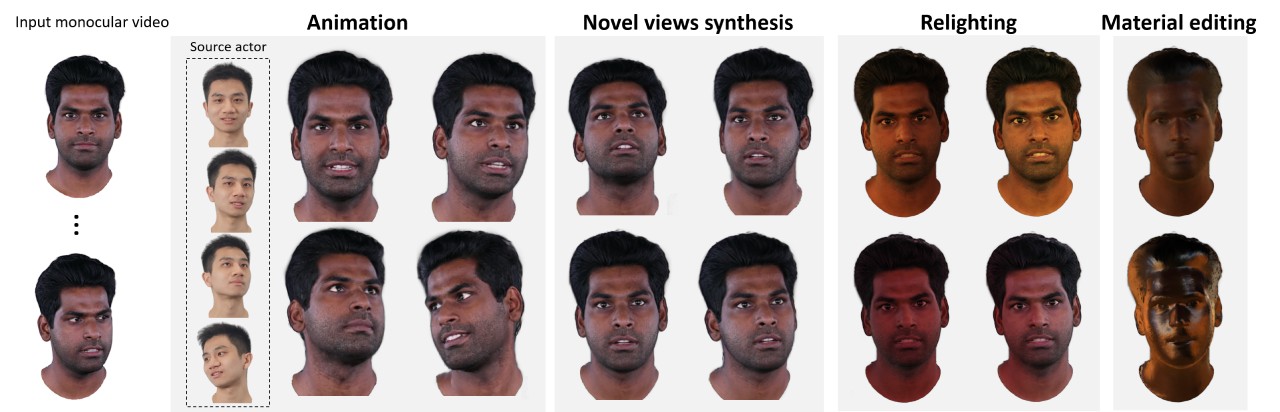
清華大学とIDEAチームの協力により、単眼動画を利用して高品質で再照明可能な3Dアバターを生成する新技術「HRAvatar」が開発されました。学習可能な変形ベースとリニアスキニングを活用することで、パーソナライズされた幾何学的変形を実現し、同時に高精度な表情エンコーダーを備えて追跡誤差を低減し、再構成品質を向上させています。HRAvatarはリアルタイム性とディテール表現に優れており、CVPR2025に採択されています。実験では、複数の評価指標において既存手法を上回り、リアルタイム性能が約155 FPSであり、新たな照明環境下での再照明にも対応していることが示されています。
HRAvatarのコア技術
学習可能な変形ベースとリニアスキニング技術:各点の変形ベースとブレンドスキニング重みを適応的に学習することで、ガウシアン点を標準ポーズからさまざまな表情やポーズに柔軟に変形させ、汎用パラメトリックモデルではパーソナライズされた表情変化を正確に捉えることが難しい問題を解決します。
高精度な表情エンコーダー:3Dアバター再構成と共同で最適化されるエンドツーエンドの表情エンコーダーを導入し、ガウシアン再構成損失による監視を利用して追跡誤差を低減し、再構成品質を向上させます。
外観モデリングと物理シェーディング:アバターの外観をアルベド、ラフネス、フレネル反射などの材質属性に分解し、材質のよりよい分離のためにアルベド疑似事前情報を導入し、簡略化されたBRDF物理モデルでシェーディングを行います。さらに、SplitSum近似技術を導入して環境照明マップを事前計算することで、高品質で再照明可能なリアルタイムレンダリングを実現します。
HRAvatarの技術的優位性
高い再構成品質:すべての評価指標で既存手法を上回っており、特にLPIPSでは再構成されたアバターのディテールがより豊富です。
優れたリアルタイム性能:レンダリング速度が約155FPSに達し、リアルタイム要件を満たします。
HRAvatarで再構成されたアバターは駆動だけでなく、新たな環境光マップ下での再照明や簡単なマテリアル編集も可能で、映画、ゲーム、イマーシブミーティング、AR/VRなどの分野に応用できます。
プロジェクト関連リンク
論文アドレス:https://arxiv.org/pdf/2503.08224
プロジェクトホームページ:https://eastbeanzhang.github.io/HRAvatar/
オープンソースコード:https://github.com/Pixel-Talk/HRAvatar









