
 脚本プランナー▸
 AIアプリ
 AIニュース
Simple Subtitling:映像作品向け自動字幕生成ツール
小编 ·

Simple Subtitling:映像作品向け自動字幕生成ツール
Simple Subtitlingとは?
Simple Subtitlingは、映像作品に自動で字幕を生成するAIツールです。WhisperX技術を用いて音声ファイルをタイムスタンプと話者ID付きの字幕ファイル(SRT)に変換します。その後、話者埋め込みの抽出とクラスタリングによって話者IDを割り当て、音声サンプルが用意されている場合は正確な話者名を割り当てることもできます。具体的には、まず音声をテキストに変換し、タイムスタンプを付与します。次に各話者の特徴を抽出し、凝集型階層クラスタリング(AHC)で特徴をグループ化し、最終的に話者IDを割り当てます。ユーザーが俳優の音声サンプルを提供した場合、話者に名前を付けることも可能です。このツールは字幕生成をより簡単に行い、映像作品を見やすくすることを目的としています。
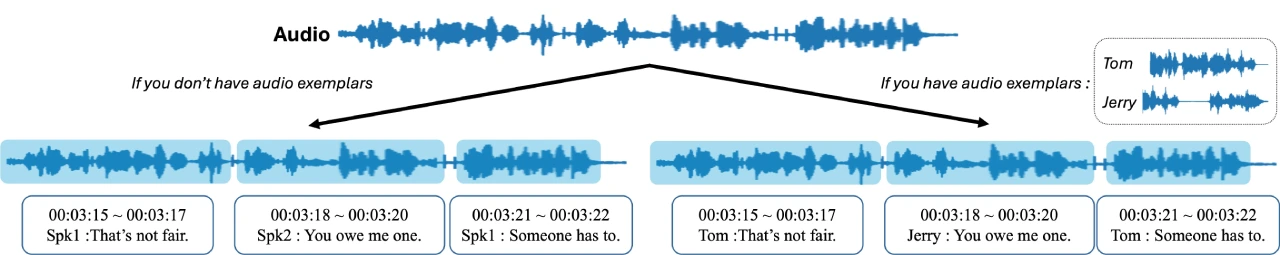
Simple Subtitlingの主な機能
音声認識とタイムスタンプ生成:WhisperX技術を使用し、音声内容を一語一文単位で正確に認識し、タイムスタンプ付きの音声テキストを生成します。
話者識別:文レベルの話者埋め込みを抽出し、凝集型階層クラスタリング(AHC)を適用して埋め込みをグループ化することで、話者IDを割り当てます。
多言語対応:複数の言語の音声入力に対応しており、対応する字幕を生成できます。
カスタム設定:ユーザーは音声サンプルディレクトリを指定し、話者に正確な名前を割り当てることができます。
高精度な音声認識とクラスタリング:高精度な音声認識とクラスタリングを実現し、音声を正確にテキストへ変換するとともに、異なる話者の音声を分類して字幕の正確性と可読性を向上させます。
Simple Subtitlingのインストールと使用方法
インストール手順
Python 3.11を指定して、simplesubという名前のconda環境を作成し、有効化します。
その環境下でプロジェクトに必要なPythonパッケージを、pip install -r requirements.txtコマンドでインストールします。
ffmpegも別途インストールが必要で、具体的なインストール方法については関連ドキュメントを参照してください。
使用方法
基本的な使い方
python main.py --input_file [INPUT_FILE_PATH] --output_file [OUTPUT_SRT_PATH]を実行します。例えばpython main.py --input_file data/friends.wav --output_file result/friends.srtのように実行すると、入力した音声ファイルに基づいて字幕ファイルが生成されます。
音声サンプルを使って話者名を指定する
まず--exemplar_dirディレクトリを特定構造で整理します。各サブフォルダが1人の話者を表し、その中に該当する話者の音声サンプルを含めます。
次にpython main.py --input_file [INPUT_FILE_PATH] --output_file [OUTPUT_SRT_PATH] --exemplar_dir [PATH_OF_EXEMPLARS]を実行します。例えばpython main.py --input_file data/friends.wav --output_file result/friends_exemplars.srt --exemplars exemplarsのように実行します。
パラメータ説明
input_file:入力音声ファイルのパスです。
output_file:出力字幕ファイル(SRT形式)のパスです。
whisper_model_type:Whisperモデルのタイプで、デフォルトは'medium'です。利用可能なタイプは関連ドキュメントで確認できます。
language:言語コード(2文字表記。例えば英語は'en')。Noneの場合、Whisperが最初の30秒間で言語を検出します。デフォルトはNoneです。
embedding_model:話者埋め込み抽出器で、'ecapatdnn'または'wespeaker'を選択できます。デフォルトは'wespeaker'です。
n_cluster:話者数が分かっている場合、このパラメータを指定できます。デフォルトはNoneです。
distance_threshold:n_clusterが指定されていない場合、これがAHC(凝集型階層クラスタリング)の距離閾値となります。デフォルトは0.8です。
exemplar_dir:音声サンプルを含むディレクトリのパスです。デフォルトはNoneです。
exemplar_threshold:「未知」の話者を判定するためのコサイン類似度の閾値で、デフォルトは0.2です。
Github:https://github.com/JaesungHuh/simple-subtitling









