
 脚本プランナー▸
 AIアプリ
 AIニュース
Insert Anything:顔入れ替えや服装変更なども可能なオープンソース画像編集フレームワーク
小编 ·

Insert Anything:顔入れ替えや服装変更なども可能なオープンソース画像編集フレームワーク
Insert Anything 紹介
Insert Anything は、浙江大学、ハーバード大学、南洋理工大学が共同で提案した統一画像挿入フレームワークで、参照画像内のオブジェクトをターゲットシーンにシームレスに統合することができます。芸術創作、リアルな顔交換、映画シーンの構図、バーチャル試着、アクセサリーカスタマイズ、デジタル小道具の交換など、さまざまな実用的なアプリケーションシナリオをサポートしています。
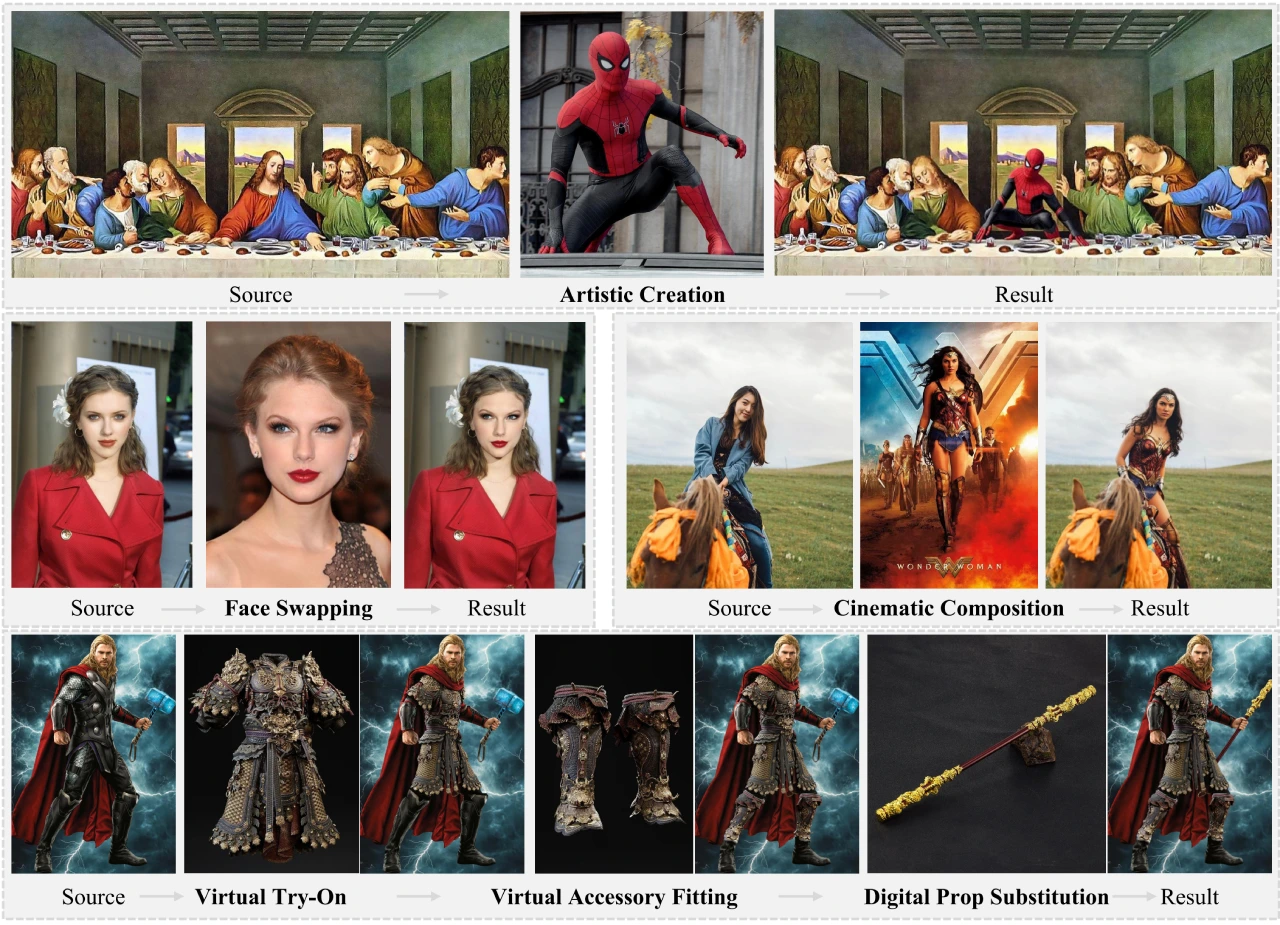
Insert Anything の技術原理
1. AnyInsertion データセット
規模と内容:このフレームワークは、12万組のプロンプト-画像ペアを含む AnyInsertion データセットに基づいており、人物、物体、服装挿入などの多様なタスクをカバーしています。
複数制御モード:データセットはマスクプロンプト(58K ペア)とテキストプロンプト(101K ペア)の 2 つの制御モードをサポートしており、モデルに豊富な学習サンプルを提供します。
2. Diffusion Transformer (DiT)
マルチモーダル注意機構:Insert Anything は DiT のマルチモーダル注意機構を利用して、マスクとテキストによる誘導編集をサポートします。この機構は、画像ブランチとテキストブランチでそれぞれ視覚入力とテキスト記述を処理し、マルチモーダル注意を通じてこれらの情報を融合します。
画像ブランチ:参照画像、ソース画像、マスクを処理し、視覚特徴を抽出してノイズと連結します。
テキストブランチ:テキスト記述をエンコードして意味的誘導を提供します。
3. コンテキスト編集機構
二連画と三連画のプロンプト戦略:
マスクプロンプト二連画:左側が参照画像、右側がマスク付きのターゲット画像です。
テキストプロンプト三連画:左側が参照画像、中央がソース画像、右側がテキスト生成の結果です。
機能:この機構は参照画像をコンテキスト情報として扱い、暗黙的な相互作用によって挿入要素とターゲットシーンの視覚的一貫性を確保しつつ、その固有の特徴を保持します。
優位性
汎用性:単一モデルで多様な挿入タスクを処理でき、タスクごとに個別にモデルを学習する必要がありません。
柔軟性:マスクとテキストの 2 つの制御モードをサポートし、さまざまなユーザーの編集ニーズに対応します。
視覚的一貫性:コンテキスト編集機構により、挿入要素がターゲットシーンと自然に融合することを保証します。
Insert Anything の応用シナリオ
芸術創作:芸術要素をさまざまな背景にシームレスに挿入します。
商業広告:製品画像を広告シーンに挿入します。
ポップカルチャー創作:ポップカルチャー要素を関連するシーンに挿入します。
プロジェクトリンク
プロジェクトホームページ:https://song-wensong.github.io/insert-anything/
論文:https://arxiv.org/abs/2504.15009
Github:https://github.com/song-wensong/insert-anything









