
 脚本プランナー▸
 AIアプリ
 AIニュース
Voila:オープンソースのエンドツーエンドAI音声モデル
小编 ·

Voila:オープンソースのエンドツーエンドAI音声モデル
Voilaとは?
Voilaはエンドツーエンドのai音声モデルで、全二重技術を採用しており、聞き取りと発話を同時に行うことができます。応答遅延はわずか195ミリ秒で、人間の平均反応時間よりも低く、従来のパイプラインシステムを一掃しています。
このモデルには100万種類以上の音声がプリセットされており、自動音声認識(ASR)、テキスト読み上げ(TTS)、多言語音声翻訳など、さまざまな機能をサポートしています。さらに、Voilaはリアルタイムの自律的な対話を実現し、継続的に聞き取り、推論し、ユーザーに積極的に応答します。ユーザーはテキスト指示を通じて話者のアイデンティティ、トーンなどの特性を定義することができ、よりパーソナライズされた自然な音声インタラクション体験を実現できます。
Voilaの機能と特徴
低遅延と全二重対話:Voilaは全二重、低遅延の対話を実現し、応答遅延はわずか195ミリ秒で、人間の平均反応時間を超えています。
音声の詳細保持:トーン、リズム、感情など、豊富な音声の詳細を保持できます。
階層的なマルチスケールTransformerアーキテクチャ:大規模言語モデル(LLMs)の推論能力と強力な音響モデリングを組み合わせ、自然でキャラクターを認識した音声生成を実現します。ユーザーはテキスト指示で話者のアイデンティティ、トーン、その他の特性を定義できます。
強力な音声カスタマイズ能力:100万種類以上のプリセット音声をサポートし、わずか10秒の音声サンプルから新しい音声を効率的にカスタマイズできます。
統一モデル設計:自動音声認識(ASR)、テキスト読み上げ(TTS)、少量のアダプテーションによる多言語音声翻訳など、幅広い音声アプリケーションに適しています。
技術原理
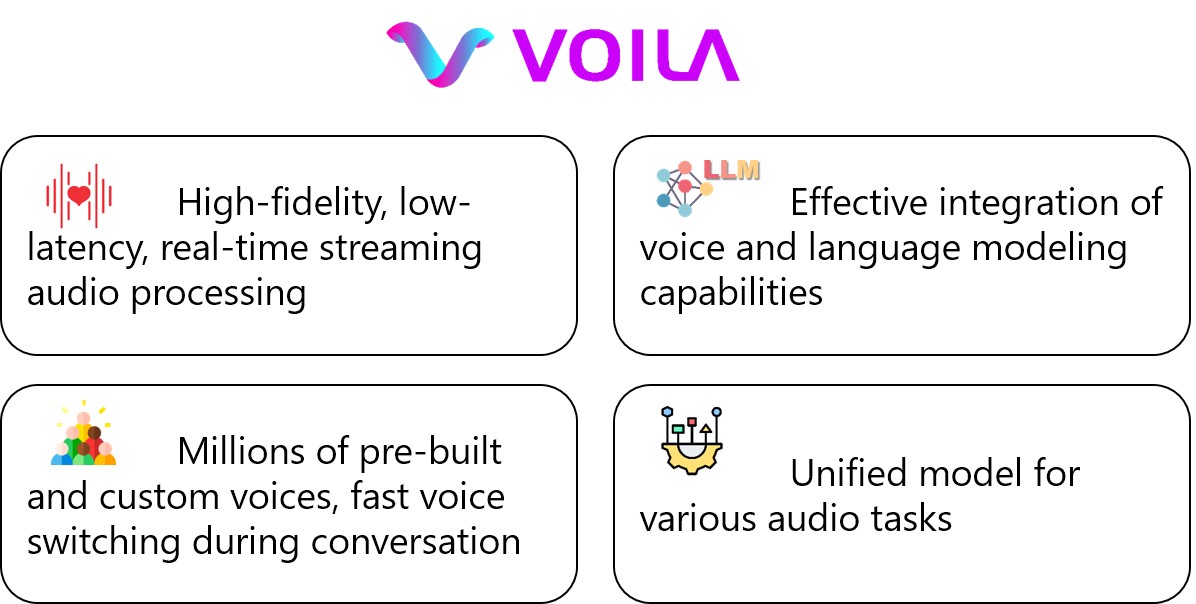
高忠実度、低遅延、リアルタイムストリーミングオーディオ処理:低遅延対話を実現し、音声の詳細を保持します。
音声と言語モデリング能力の効率的な統合:テキストと音声モデリングを組み合わせて、インタラクションの自然性を向上させます。
数百万種類のプリビルトおよびカスタム音声:対話中の迅速な音声切り替えをサポートし、インタラクション体験を豊かにします。
様々なオーディオタスクに対応する統一モデル:1つのモデルで複数のオーディオタスクをサポートし、開発および展開コストを削減します。
Voilaの応用シーン
音声アシスタント:自律的、リアルタイム、かつ感情表現豊かな方法で人間と対話できるスマート音声アシスタントとして機能し、継続的に聞き取り、推論し、積極的に応答することで、流暢でダイナミックかつ感情的に共鳴するインタラクション体験を促進します。
音声ロールプレイ:ロールプレイなどのシナリオでは、ユーザーが話者のアイデンティティ、トーン、その他の特性を定義して、自然でキャラクターを認識した音声生成を実現できます。
多言語音声翻訳:少量のアダプテーションの後、多言語音声翻訳に使用できます。
プロジェクト関連リンク
プロジェクトホームページ:https://voila.maitrix.org/
モデル:https://huggingface.co/collections/maitrix-org/voila-67e0d96962c19f221fc73fa5
デモ:https://huggingface.co/spaces/maitrix-org/Voila-demo
論文:https://arxiv.org/abs/2505.02707
GitHubリポジトリ:https://github.com/maitrix-org/Voila









