
 脚本プランナー▸
 AIアプリ
 AIニュース
RealtimeVoiceChat:音声にリアルタイムで応答するAI音声チャットアプリ
小编 ·

RealtimeVoiceChat:音声にリアルタイムで応答するAI音声チャットアプリ
RealtimeVoiceChatとは?
RealtimeVoiceChatは、音声を使ってAIシステムとチャットできるオープンソースプロジェクトで、リアルタイムで音声返信を受け取ることができます。ネットワーク経由で音声断片を転送し、音声をテキストに変換してAIシステムで処理し、そのテキストを音声に変換します。このプロジェクトは複数のAIシステムをサポートしており(デフォルトはOllama、Openaiも利用可能)、音声スタイルも柔軟に選択できます。クライアント・サーバーアーキテクチャを採用しており、低遅延に最適化され、会話のターンを智能的に検出することで、よりスムーズなチャットを実現します。デプロイにはDockerの使用を推奨します。CUDA対応のNVIDIA GPUがあれば、パフォーマンスはさらに向上します。
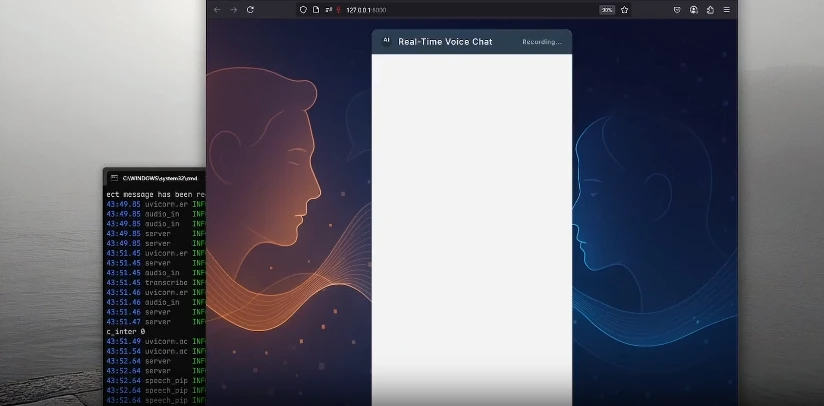
RealtimeVoiceChatの主要機能
ストリーミング音声インタラクション:ユーザーの音声はブラウザでキャプチャされ、WebSockets経由でPythonバックエンドに送信され、リアルタイムでテキストに変換されます。その後LLMに送られ処理され、テキスト応答が再び音声ストリームとしてユーザーに返されます。
低遅延設計:音声チャンクのストリーミングによってアーキテクチャを最適化し、スムーズな会話を実現します。
智能的なターン検出:動的な無音検出により、会話のリズムに応じて発言権を自動的に切り替えます。
柔軟なAIバックエンド:複数のLLMバックエンドをサポート(デフォルトはOllama、OpenAIもサポート)。
カスタマイズ可能な音声:異なるテキスト読み上げエンジン(Kokoro、Coqui、Orpheusなど)を選択できます。
シンプルなWebインターフェース:Vanilla JSとWeb Audio APIで構築されたシンプルなユーザーインターフェース。
Docker化されたデプロイ:依存関係の管理を容易にするため、Docker Composeを使用したデプロイを推奨します。
RealtimeVoiceChatの特徴
リアルタイムインタラクション:ユーザーは音声を使ってAIと会話でき、AIもリアルタイムで音声で応答します。
複数コンポーネントの連携:プロジェクトにはフロントエンドの音声処理とUIインタラクション、そしてバックエンドの音声転写、テキスト処理、音声合成などの機能が含まれています。
高いカスタマイズ性:複数のTTSエンジンとLLMモデルをサポートし、環境変数による設定が可能です。
技術スタック
バックエンド:Python 3.x、FastAPI
フロントエンド:HTML、CSS、JavaScript(Vanilla JS、Web Audio API、AudioWorklets)
通信:WebSockets
コンテナ化:Docker、Docker Compose
コアAI/MLライブラリ:RealtimeSTT(音声からテキスト)、RealtimeTTS(テキストから音声)、transformers(ターン検出、トークン化)、torch/torchaudio(機械学習フレームワーク)、ollama/openai(LLMクライアント)
音声処理:numpy、scipy
インストールとデプロイ
Dockerでのインストール(推奨)
プロジェクトをクローンし、ディレクトリに移動します。
Dockerイメージをビルドします(ベースイメージのダウンロード、Python/ML依存関係のインストール、デフォルトのSTTモデルの事前ダウンロードが行われます)。
サービス(AppとOllama)を起動します。
必要なOllamaモデルを取得します。
ブラウザでhttp://localhost:8000にアクセスして、音声チャットを開始します。
手動インストール
Python仮想環境を作成し、有効化します。
PyTorchをインストールします(ハードウェア構成に応じて)。
その他の依存関係をインストールします(requirements.txt)。
FastAPIサーバーを起動します。
ブラウザでhttp://localhost:8000にアクセスして、音声チャットを開始します。
設定とカスタマイズ
TTSエンジンと音声:server.pyとaudio_module.pyで設定します。
LLMバックエンドとモデル:server.pyとllm_module.pyで設定します。
STT設定:transcribe.pyで設定します。
ターン検出の感度:turndetect.pyで設定します。
SSL/HTTPS:server.pyで設定します。
プロジェクトリポジトリ
GitHubリポジトリ:https://github.com/KoljaB/RealtimeVoiceChat









