
 脚本プランナー▸
 AIアプリ
 AIニュース
ACE-Step:新しいオープンソース音楽生成基盤モデル
小编 ·

ACE-Step:新しいオープンソース音楽生成基盤モデル
ACE-Stepとは?
ACE-Step は、ACE Studio と StepFun が共同で開発した新しいオープンソースの音楽生成基盤モデルです。拡散ベースの生成技術、Sana の深層圧縮オートエンコーダ、軽量リニアトランスフォーマーを統合することで、既存の音楽生成手法における生成速度、音楽の連続性、制御性の限界を克服しました。このモデルは A100 GPU 上で 20 秒以内に最大 4 分間の音楽を合成でき、LLM をベースとしたベースラインよりも 15 倍高速です。また、旋律、和声、リズムの各指標で優れた音楽の連続性と歌詞アラインメントを実現し、音声クローンや歌詞編集などの高度な制御メカニズムをサポートします。一方で、出力の不安定さや特定スタイルの性能低下などの制限も挙げられています。
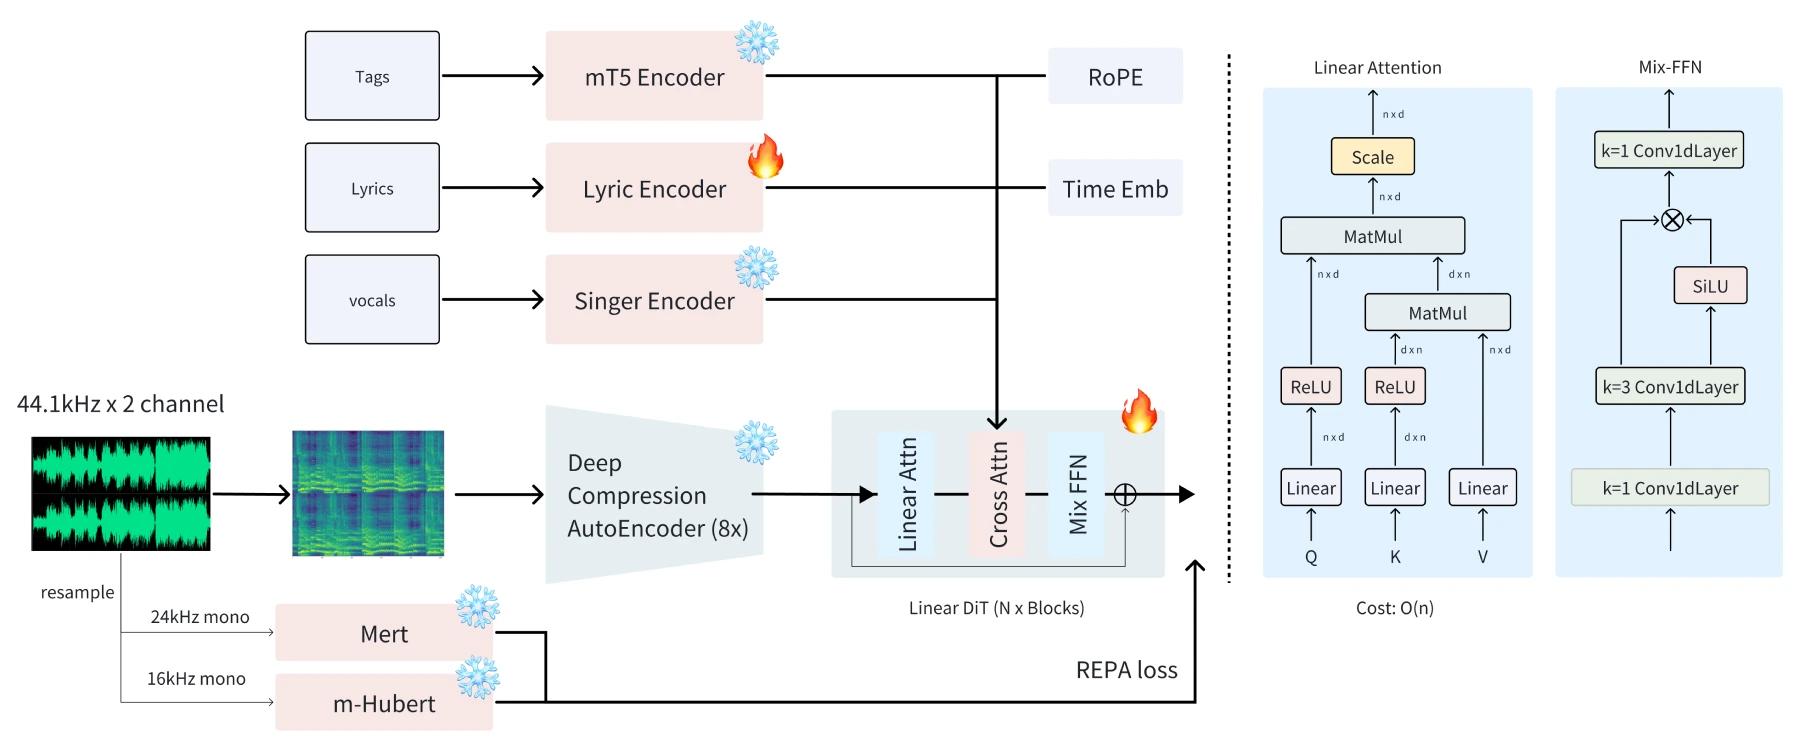
ACE-Stepのコアアーキテクチャ
ACE-Step は、拡散モデル、深層圧縮オートエンコーダ、軽量リニアトランスフォーマーを統合し、トレーニング中に MERT と m-hubert を用いて意味表現(REPA)をアラインメントすることで、高速な収束を実現しています。このアーキテクチャ設計により、生成速度、音楽の連続性、制御性の間でバランスを達成しています。
ACE-Stepの優位性
生成速度:ACE-Step は NVIDIA A100 GPU 上でわずか 20 秒で最大 4 分間の音楽を生成でき、大規模言語モデル(LLM)をベースとしたベースライン手法よりも 15 倍高速です。
音楽の連続性:このモデルは、旋律、和声、リズムの各指標において、優れた音楽の連続性と歌詞アラインメント能力を発揮します。
細部保持:ACE-Step は微細な音響ディテールを保持し、音声クローン、歌詞編集、リミックス、トラック生成などの高度な制御メカニズムをサポートします。
ACE-Stepの機能と特徴
多様なスタイル:主要な音楽スタイルをサポートし、短タグ、説明文、応用シナリオの説明など多様な記述形式を処理できます。実験的な入力テストでも良好な性能を発揮し、複数楽器のインストゥルメンタルトラックも生成可能です。
多言語サポート:19 言語をサポートしていますが、データの偏りにより、一部の言語では性能がやや劣ります。性能が比較的良好上位 10 言語には、英語、中国語、ロシア語などが含まれます。
高い制御性:
Variations Generation:トレーニング不要の推論時最適化技術を活用し、初期ノイズと追加ガウスノイズの混合比率を調整することで、原曲との類似度が異なるバリエーションを生成します。
Repaint:ターゲット音声入力にノイズを加え、ODE プロセスにマスク制約を適用することで、特定の部分を変更できます。さらに、バリエーション生成技術と組み合わせることで、部分的なスタイル、歌詞、ボーカル変更を実現します。
Edit:flow-edit 技術を活用し、旋律、ボーカルの音色、バックグラウンドミュージックを変更せずに歌詞を修正できますが、一度に修正できる歌詞は短い区間のみです。
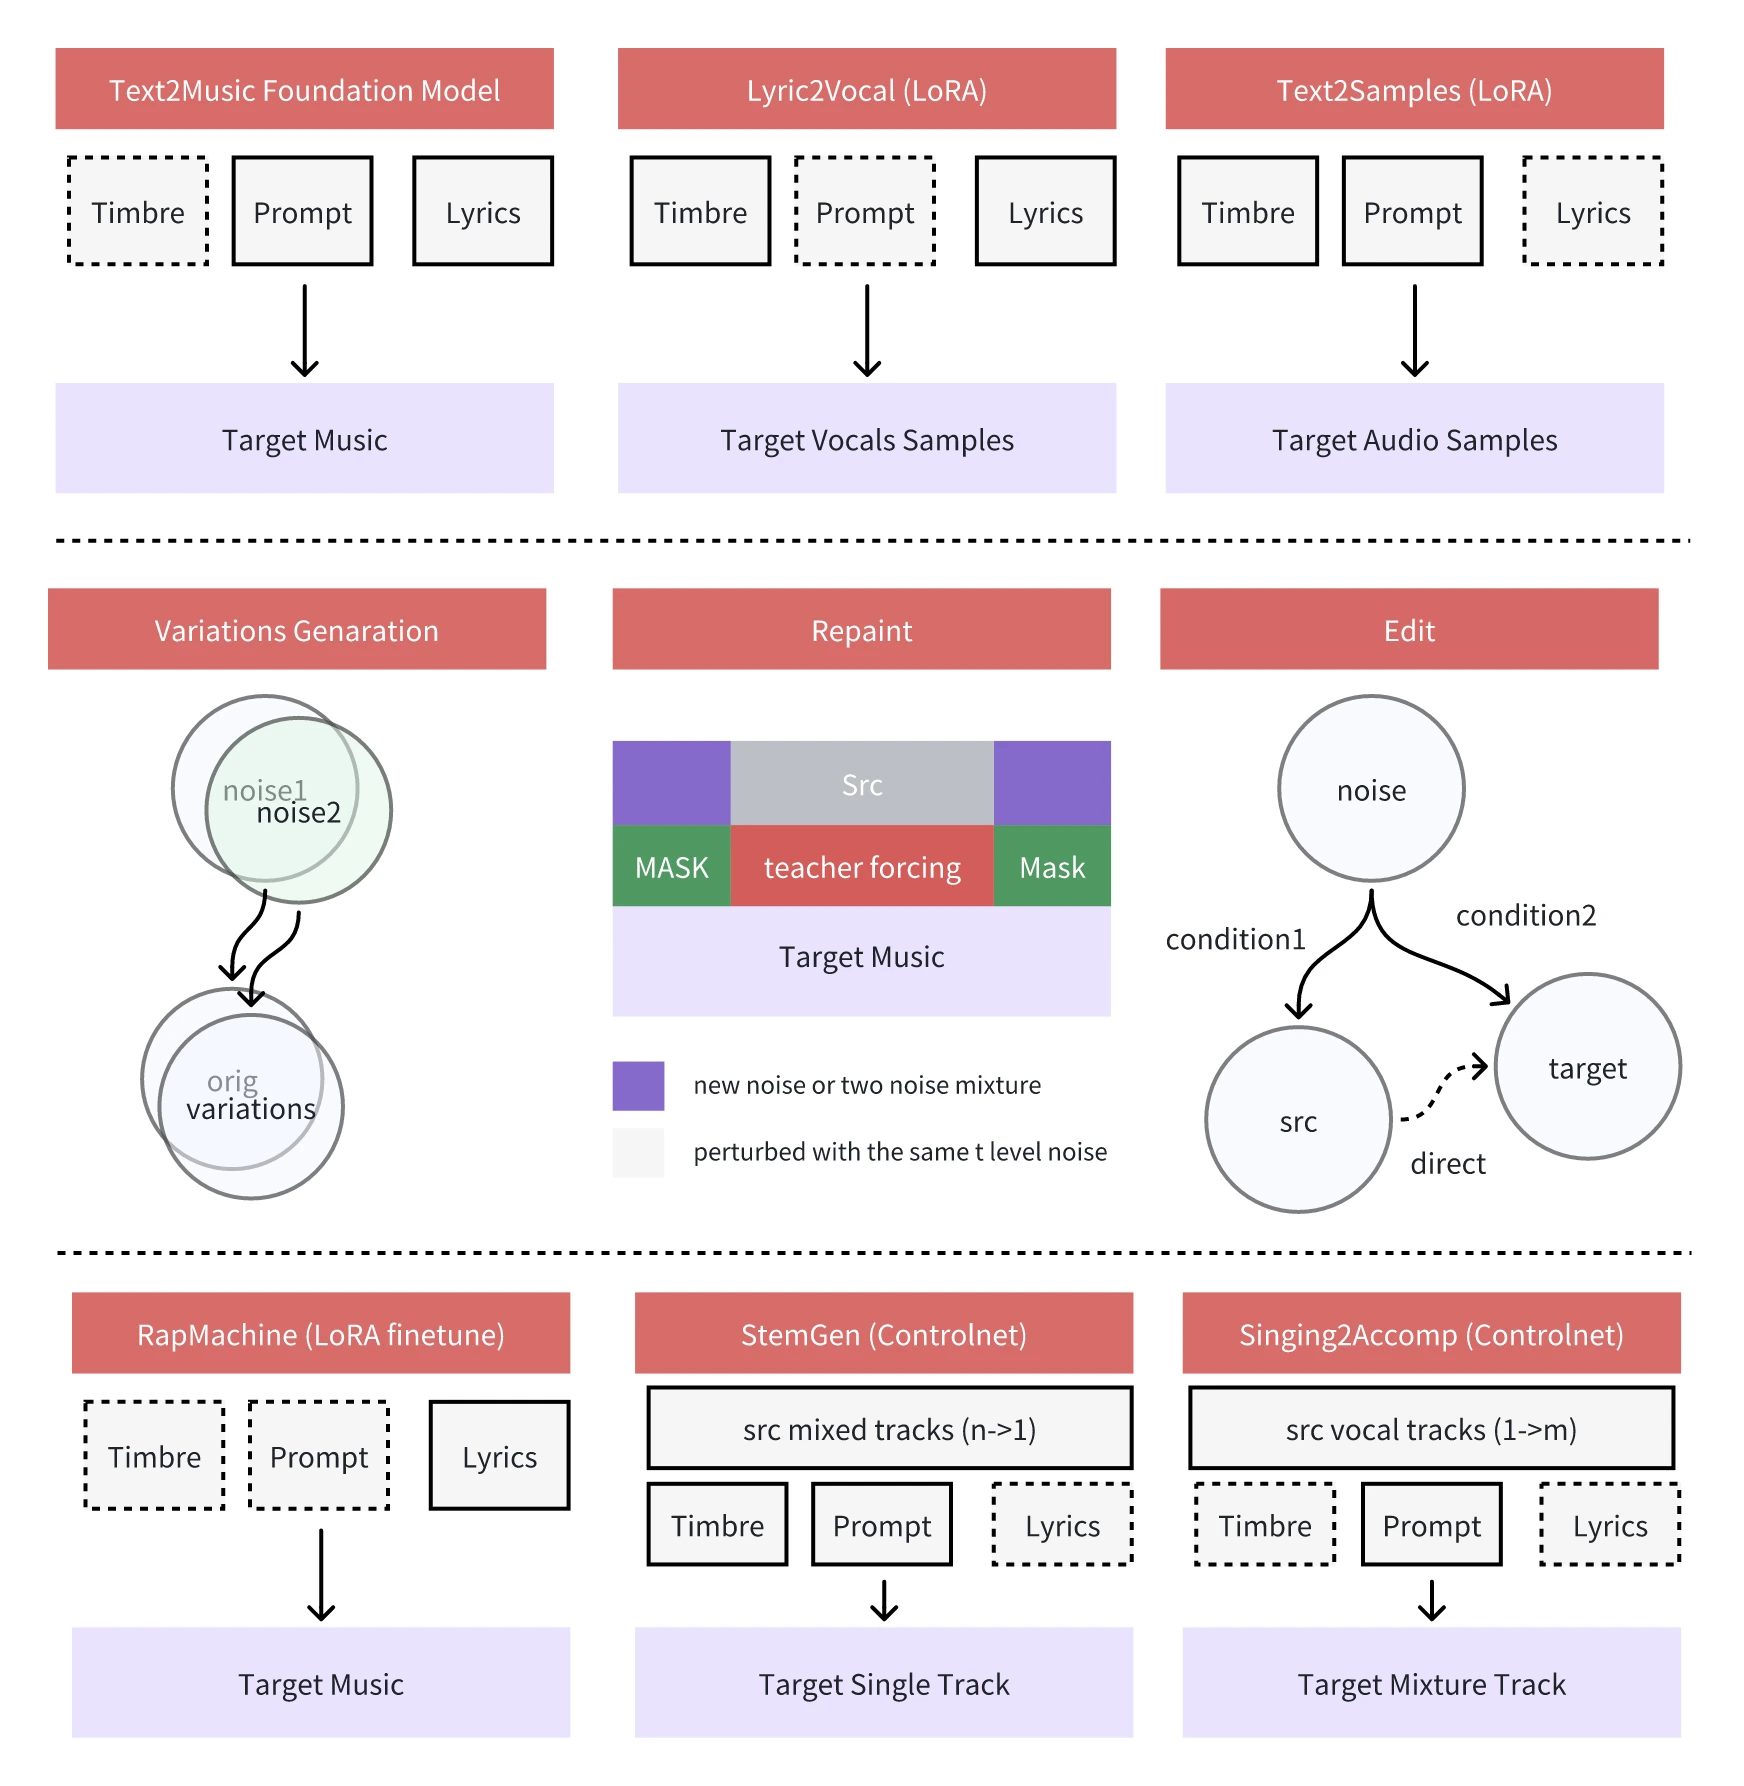
ACE-Stepの応用シナリオ
Lyric2Vocal(LoRA):純粋なボーカルデータに基づく LoRA ファインチューニングにより、歌詞から直接ボーカルサンプルを生成し、ボーカルデモや楽曲制作の補助などに活用できます。
Text2Samples(LoRA):純粋な楽器およびサンプルデータに基づく LoRA ファインチューニングにより、テキスト記述からコンセプト的な音楽制作サンプルを生成し、楽器ループやサウンドエフェクトの作成などに活用できます。
ACE-Stepの制限事項
出力の不安定さ:ランダムシードや入力時間に敏感で、結果が不安定です。
スタイルの偏り:中国語ラップなどの特定のスタイルでは性能が劣ります。
連続性の問題:再描画や拡張操作時に遷移が自然ではありません。
ボーカル品質の向上が必要:合成されたボーカルは粗く、ディテールに欠けます。
制御の粒度不足:より精细な音楽パラメータ制御が必要です。
多言語歌詞の最適化:多言語歌詞のサポートを強化し、正確性と自然さを向上させる必要があります。
ACE-Stepに関するよくある質問
ACE-Step は他の音楽生成モデルと比較して最大の優位性は何ですか?
回答:ACE-Step の最大の優位性は、既存モデルにおける生成速度、音楽の連続性、制御性のトレードオフ問題を解決したことです。A100 GPU 上で 20 秒以内に最大 4 分間の音楽を合成でき、LLM ベースのベースラインモデルよりも 15 倍高速です。同時に、旋律、和声、リズムの各指標でより優れた音楽の連続性と歌詞アラインメントを実現し、音声クローン、歌詞編集などの強力な制御機能を備えています。これらの機能を同時に実現できるモデルは他にはありません。
ACE-Step の多言語サポートにはどのような問題がありますか?
回答:ACE-Step は 19 言語をサポートしていますが、データの偏りの影響により、あまり一般的でない言語では性能が劣ります。多言語歌詞を処理する際には、正確性と自然さの面で改善の余地があり、異なる言語におけるモデル全体のパフォーマンスを向上させるために、多言語歌詞のさらなる最適化が必要です。
ACE-Step の応用シナリオにおいて、Lyric2Vocal と Text2Samples はそれぞれどのような制作プロセスに適していますか?
回答:Lyric2Vocal は純粋なボーカルデータに基づく LoRA ファインチューニングで、楽曲制作におけるボーカルデモの环节に適しており、クリエイターが歌詞の歌唱効果を迅速にテストするのに役立ちます。また、ガイダンストラックの制作、楽曲制作の補助、ボーカルアレンジメント実験にも活用できます。Text2Samples は純粋な楽器およびサンプルデータに基づく LoRA ファインチューニングで、音楽制作の初期段階で楽器ループ、サウンドエフェクト、さまざまな音楽要素を迅速に作成し、コンセプトサンプルを提供することで制作効率を向上させるのに適しています。
関連リンク
https://ace-step.github.io/









