
 脚本プランナー▸
 AIアプリ
 AIニュース
Spatial Speech Translation:空間をまたぐ音声翻訳プロジェクト
小编 ·

Spatial Speech Translation:空間をまたぐ音声翻訳プロジェクト
Spatial Speech Translationとは?
Spatial Speech Translationは、実用的な空間横断型の音声翻訳プロジェクトです。両耳装着型のウェアラブルデバイスを使用することで、複数話者やノイズ環境下でも音声翻訳を行いながら、音の原来の方向感を保持します。本プロジェクトはリアルタイム音声翻訳をサポートし、Apple M2チップ上で高速な推論を実現します。さらに、翻訳プロセスにおいて話者のトーンや感情を保持できるため、翻訳後の音声がより自然でスムーズになります。
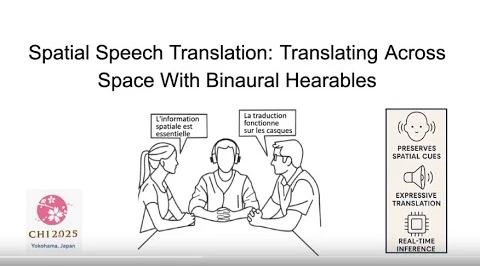
Spatial Speech Translationの主な機能
複数話者の音声分離と翻訳:複数話者や干渉条件下でも、目的の音声を正確に分離して翻訳できます。
リアルタイム音声翻訳:Appleチップ上でリアルタイム動作をサポートし、低遅延の翻訳体験を提供します。
空間手がかりの保持:両耳レンダリング技術により、入力音声の空間手がかり(方向、距離など)を翻訳後の出力音声に保持します。
多言語サポート:フランス語から英語への翻訳モデルを提供し、ドイツ語、スペイン語など他の言語への拡張も計画されています。
表現力豊かな音声翻訳:話者のイントネーションや感情を保持する翻訳をサポートし、翻訳後の音声により一層的表现力を与えます。
Spatial Speech Translationの技術実装
分離と位置特定の統合モデル:分離モデルと位置特定モデルを学習することで、異なる話者の音声を識別し、その空間的位置を特定します。
ストリーミング音声処理:StreamSpeech技術に基づき、リアルタイムのストリーミング音声入力と翻訳をサポートします。
両耳レンダリング:両耳装着型ウェアラブルデバイスの特性を活かし、翻訳音声の空間化された出力を実現します。
多段階学習プロセス:事前学習、分離認識のファインチューニング、表現力ある音声生成を含み、モデルの性能と適応性を向上させます。
Spatial Speech Translationの使用方法
環境構築:Condaとpipを使って必要な依存関係をインストールし、音声分離、ストリーミング音声処理、両耳レンダリングに必要なツールを導入します。
モデル学習:分離と位置特定モデルの学習、音声翻訳モジュールの事前学習とファインチューニングなど、詳細な学習手順を提供します。
推論と評価:分離された音声に対する翻訳をサポートし、モデルの性能を検証するための評価スクリプトを提供します。
優位性と革新性
複数話者サポート:複数話者環境下での音声翻訳を初めて実現しました。
空間手がかりの保持:両耳レンダリング技術により、没入感のある音声翻訳体験を提供します。
リアルタイム性:リアルタイム音声翻訳をサポートし、ダイナミックな交流シーンに適しています。
表現力ある翻訳:話者のイントネーションや感情を保持し、より自然な翻訳を実現します。
Spatial Speech Translationの応用
国際会議やビジネスイベント:国際会議、ビジネス交渉、セミナーなどで、参加者は異なる国から集まり、言語もさまざまです。両耳デバイスを活用することで、リアルタイムに翻訳音声を聞くことができ、さらに話者の声の方向や远近も把握できます。
観光と文化体験:観光客が歴史的遺跡、博物館を訪問したり、文化イベントに参加する際、両耳デバイスを使えば解説の翻訳をリアルタイムに聞くことができ、同時に解説者の声の空間的位置も把握できます。
リモート会議とコラボレーション:リモート会議では、参加者は異なる場所に居り、言語も異なります。両耳音声翻訳技術により、翻訳音声をリアルタイムに聞くことができ、仮想空間内における話者の位置を感じ取ることができます。
教育とトレーニング:多言語教育環境では、学生が両耳デバイスを使って教師の解説の翻訳をリアルタイムに聞くことができ、さらに教師の声の方向や远近も把握できます。これは、言語学習者が音声を理解し模倣するのに非常に役立ちます。
カスタマーサービスと接客:空港、ホテル、カスタマーセンターなどで、スタッフが異なる言語にすることで異なる言語の顧客とリアルタイムに交流し、より自然で効率的なサービスを提供できます。
プロジェクトアドレス
https://github.com/chentuochao/Spatial-Speech-Translation









