
 脚本プランナー▸
 AIアプリ
 AIニュース
Muyan-TTS:Muyanが開発したポッドキャスト向けオープンソース・学習可能なTTSモデル
小编 ·

Muyan-TTS:Muyanが開発したポッドキャスト向けオープンソース・学習可能なTTSモデル
Muyan-TTSとは?
Muyan-TTSは、北京沐言智语が発表したオープンソースで学習可能なTTSモデルであり、ポッドキャスト向けに設計され、予算は5万ドル以内に抑えられています。Muyan-TTSは10万時間以上のポッドキャスト音声データで事前学習されており、ゼロショットTTS合成をサポートし、高品質な音声を生成できます。また、数十分間の目標音声による話者適応にも対応しています。
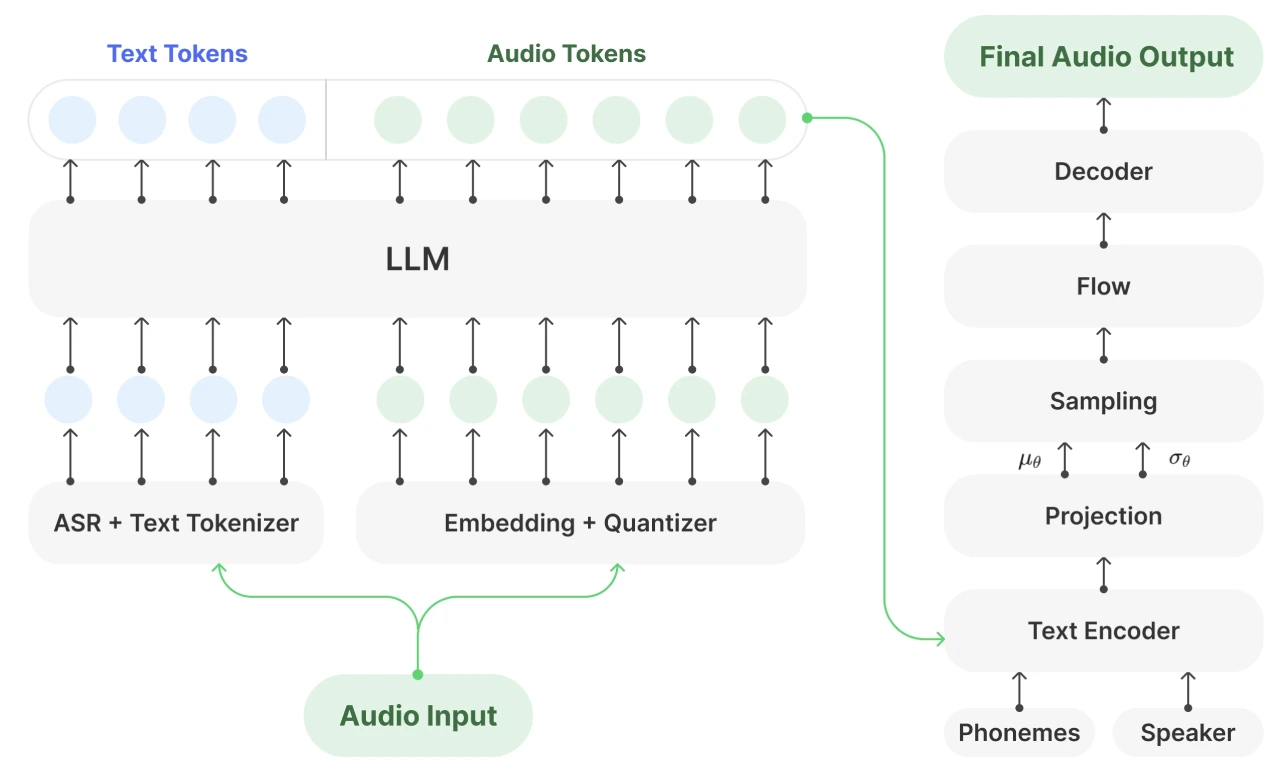
Muyan-TTSのモデル特徴
大規模事前学習:Muyan-TTSはLlama-3.2-3Bモデルに基づき、10万時間以上のポッドキャスト音声データで事前学習されており、ゼロショット音声合成を実現し、高品質な音声を生成できます。
話者適応のサポート:数十分間の目標話者の音声データにより、Muyan-TTSは特定の話者の音声特徴にさらに適応でき、高度にカスタマイズされた音声合成を実現します。
アーキテクチャ設計:Muyan-TTSはGPT-SoVITSの二段階構造を採用しており、言語モデル部分はLlama-3.2-3Bをバックボーンとして事前学習を継続し、デコーダー部分はSoVITSアーキテクチャを使用しています。LLMの意味モデリング能力とVITSモデルの音素から音素(G2P)特性を組み合わせ、ハルシネーション現象を効果的に削減しています。
データ処理:10万時間以上の高品質な音声と対応する書き起こしを含む並列コーパスを構築しており、ポッドキャストなどの長尺音声シナリオのTTS学習に適しています。
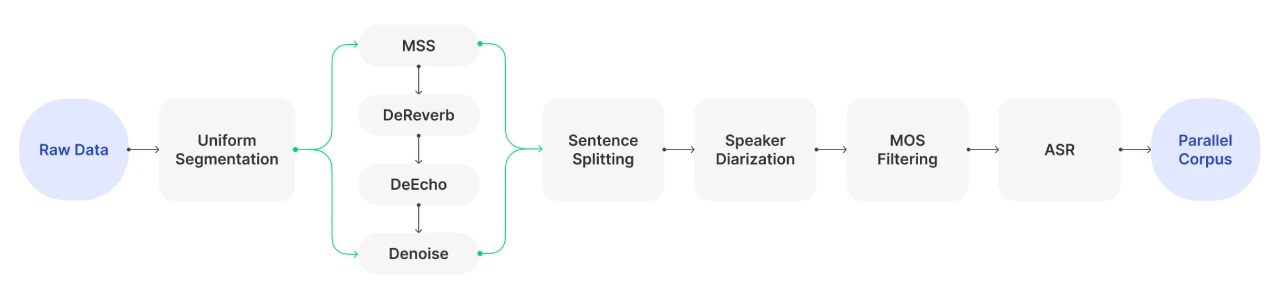
オープンソースと学習
オープンソース情報:Muyan-TTSは完全にオープンソースであり、完全なデータ収集・処理フロー、詳細な学習方法、最適化された推論フレームワークが提供されています。コードとモデルはGitHubで入手できます。
学習コスト:学習コストについては、A10およびA100 GPUのレンタル価格がそれぞれ1時間あたり0.5ドルおよび1ドルと仮定すると、Muyan-TTSの合計学習コストは約50,540ドルです。
性能
ゼロショット合成:LibriSpeechデータセットにおいて、Muyan-TTSのゼロショット合成性能は出色しており、単語誤り率はCosyVoice2に次ぐ結果で、平均意見スコアはSpark-TTSおよびGPT-SoVITS v3を上回っています。
教師あり微調整モデル:教師あり微調整を経たMuyan-TTS-SFTは、音声品質と話者類似度の面でベースモデルを上回っていますが、WERはやや低下しています。
推論速度:Muyan-TTSの推論速度はテスト対象モデルの中で最速であり、1秒の音声合成にわずか0.33秒しかかからないため、リアルタイム音声生成シナリオに適しています。
Muyan-TTSの応用シナリオ
Muyan-TTSは、MCナレーション、インタビュー再現、音声要約など、さまざまな音声コンテンツ形式に適しています。合成品質、パーソナライズ能力、実行効率を兼ね備えており、ポッドキャストなどの長尺音声シナリオに適しています。
制限事項
デコーダー内のG2Pモジュールに依存しているため、完全な音素シーケンスが必要で、ストリーミング推論を実現できません。
学習データが主に英語であるため、多言語音声合成能力には限界があります。
学習コーパスに指示レベルのアノテーションが不足しているため、Muyan-TTSは現在、指示追従型TTSタスクをサポートしていません。
Muyan-TTSのインストールと使用方法
インストール手順
1. リポジトリをクローンして仮想環境を作成します:
git clone https://github.com/MYZY-AI/Muyan-TTS.git
cd Muyan-TTS
conda create -n muyan-tts python=3.10 -y
conda activate muyan-tts
make build
2. FFmpegをインストールします(Ubuntuシステム):
sudo apt update
sudo apt install ffmpeg
3. モデルをダウンロードします:
Muyan-TTSおよびMuyan-TTS-SFTモデルはHugging FaceまたはModelScopeからダウンロードできます。
chinese-hubert-baseの重みをダウンロードする必要もあります。
ダウンロードしたすべてのモデルをpretrained_modelsディレクトリに配置してください。
使用方法
音声合成を行うには、以下のコマンドを実行します:
python tts.py
コア推論コードは以下の通りです:
async def main(model_type, model_path):
tts = Inference(model_type, model_path, enable_vllm_acc=False)
wavs = await tts.generate(
ref_wav_path="assets/Claire.wav",
prompt_text="Although the campaign was not a complete success, it did provide Napoleon with valuable experience and prestige.",
text="Welcome to the captivating world of podcasts, let's embark on this exciting journey together."
)
output_path = "logs/tts.wav"
with open(output_path, "wb") as f:
f.write(next(wavs))
print(f"Speech generated in {output_path}")githubリポジトリ:https://github.com/MYZY-AI/Muyan-TTS









