
 脚本プランナー▸
 AIアプリ
 AIニュース
Xiaomi MiMo:Xiaomi初の推論特化型オープンソース大規模言語モデル
小编 ·

Xiaomi MiMo:Xiaomi初の推論特化型オープンソース大規模言語モデル
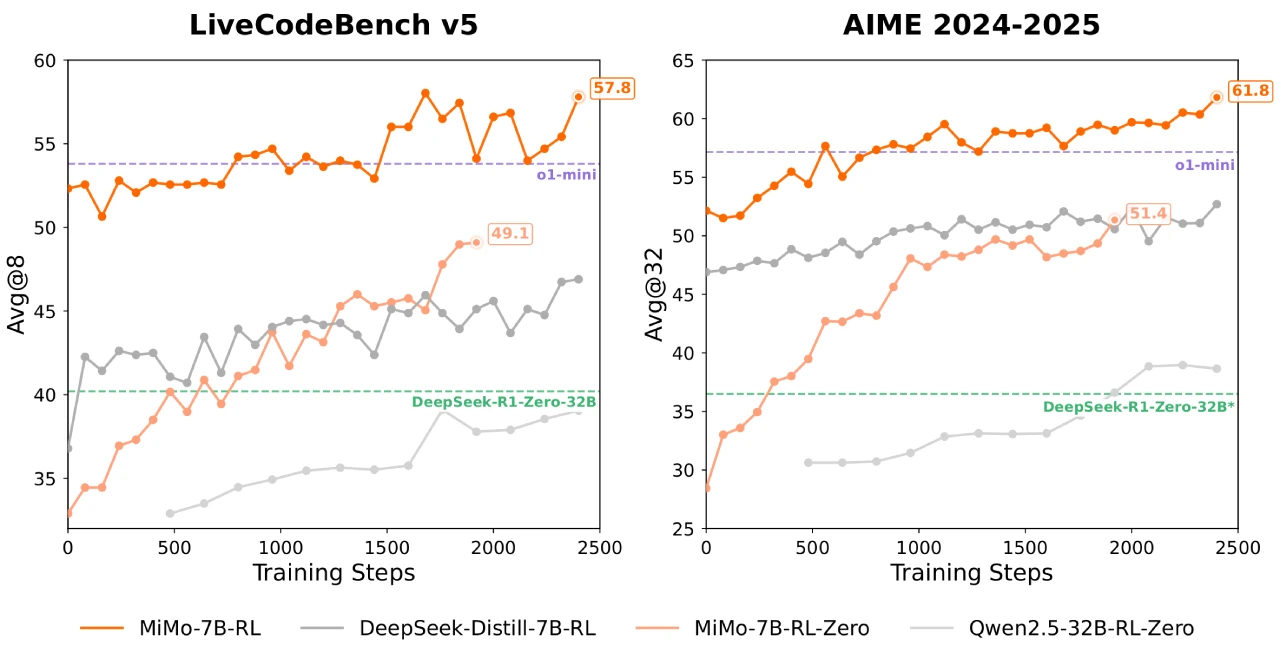
Xiaomi MiMoは、2025年4月30日にシャオミ社が発表した、推論のために生まれた初のオープンソースai大規模モデルです。MiMo - 7Bシリーズモデルは、言語モデルの推論ポテンシャルを十分に掘り起こし、後学習だけでなく、推論に特化した事前学習戦略にも注力しています。このシリーズモデルは、比較的コンパクトな7Bサイズでありながら、多くの32Bモデルの推論能力を超える性能を発揮しており、中でもMiMo - 7B - RLは、数学およびコード推論タスクにおいてOpenAI o1 - miniに匹敵する性能を実現しています。
MiMoの主な特徴
事前学習
データ前処理の最適化:テキスト抽出ツールキットを改善し、複数次元のデータフィルタリングを採用することで、事前学習データ内の推論パターンの密度を高めます。
合成データの生成:多様な戦略を用いて、大量の多種多様な合成推論データを生成します。
3段階データミックス:事前学習には3段階のデータミックス戦略を採用し、MiMo - 7B - Baseは約25兆トークンで事前学習されます。
マルチトークン予測:追加の学習目標としてマルチトークン予測を導入し、モデル性能の向上と推論の高速化を実現します。
後学習
高品質な学習データ:RL学習データとして厳選された13万問の数学およびコード問題を採用しており、各問題は慎重にクリーニングと難易度評価が行われ、ルールベースの検証器によりデータ品質が保証されています。
コード報酬メカニズム:難易度の高いコード問題に対し、テスト難易度駆動型のコード報酬を導入し、難易度の異なるテストケースに細粒度のスコアを割り当てることで、戦略を最適化します。
データリサンプリング:簡単な問題に対してデータリサンプリング戦略を実施し、ローリングサンプリングの効率を高め、戦略更新を安定化させます。
RLインフラ
シームレスローリングエンジン:シームレスローリングエンジンを開発し、連続ローリング、非同期報酬計算、Early Termination機能を統合。GPUのアイドル時間を削減し、学習速度を2.29倍、検証速度を1.96倍に高速化します。
MTPサポート:vLLMにおけるMTPをサポートし、RLシステム内の推論エンジンの堅牢性を強化します。
MiMoモデルバージョン
MiMo - 7B - Base:卓越した推論ポテンシャルを備えたベースモデル
MiMo - 7B - RL - Zero:ベースモデルから学習されたRLモデル
MiMo - 7B - SFT:ベースモデルから学習されたSFTモデル
MiMo - 7B - RL:SFTモデルから学習されたRLモデルで、性能はOpenAI o1 - miniに相当します。
技術的な詳細とイノベーション
事前学習データの最適化:多次元データフィルタリングと合成推論データ生成により、事前学習データの品質と推論パターンの密度を向上させました。
MTPモジュール:事前学習にMTPモジュールを導入し、推論タスクにおける性能と推論速度を大幅に向上させました。
RLインフラ:シームレスロールアウトエンジン(Seamless Rollout Engine)を開発し、RL学習と検証プロセスを高速化、それぞれ2.29倍と1.96倍の速度向上を実現しました。
テスト難易度駆動型報酬メカニズム:コード問題におけるスパース報酬問題に対処するため、テスト難易度に基づく報酬メカニズムを提案し、困難な問題におけるモデルの学習効率を向上させました。
実験と結果
事前学習モデルの性能
MiMo-7B-Base:複数のベンチマークテストで、BBH、SuperGPQAなど、他の7Bパラメータ規模のオープンソースモデルを上回りました。
推論ポテンシャル評価:pass@k指標を用いてモデルの推論ポテンシャルを評価した結果、MiMo-7B-Baseはすべてのベンチマークテストでより高いpass@kスコアを示しました。
後学習モデルの性能
MiMo-7B-RL-Zero:MiMo-7B-Baseから直接RL学習を行い、強力な推論能力を示しました。
MiMo-7B-RL:SFTモデルからRL学習を行い、最終的に数学およびコードタスクにおいてOpenAIのo1-miniモデルを上回りました。
具体的なパフォーマンス:
AIME 2025において、MiMo-7B-RLは55.4点を獲得し、o1-miniを4.7点上回りました。
LiveCodeBench v5およびv6において、MiMo-7B-RLはo1-miniを大きく上回りました。
関連リンク
Hugging Faceプラットフォーム:https://huggingface.co/XiaomiMiMo
GitHubリポジトリ:https://github.com/XiaomiMiMo/MiMo
技術レポート:https://github.com/XiaomiMiMo/MiMo/blob/main/MiMo-7B-Technical-Report.pdf









