
 脚本プランナー▸
 AIアプリ
 AIニュース
Alibaba、最新モデルQwen3を発表:2つの思考モードと多言語対応
小编 ·

Alibaba、最新モデルQwen3を発表:2つの思考モードと多言語対応
アリババは2025年4月29日にQwen3シリーズモデルを正式にリリースしました。これはQwenシリーズ大規模言語モデルの最新の言語モデルであり、フラッグシップモデルQwen3-235B-A22Bや小型MoEモデルQwen3-30B-A3Bなど、複数のモデルがコード、数学、一般能力などのベンチマークテストで優れたパフォーマンスを発揮しています。Qwen3は複数のモデルの重みをオープンソース化し、複数のプラットフォームで利用可能にしました。
Qwen3は2つの思考モードをサポートし、多言語能力を備え、エージェントとコード能力を最適化しています。事前学習データ量は約36兆トークンに達し、事前学習は3つの段階に分けられ、事後学習は4段階の学習フローを採用しています。
モデルのハイライト
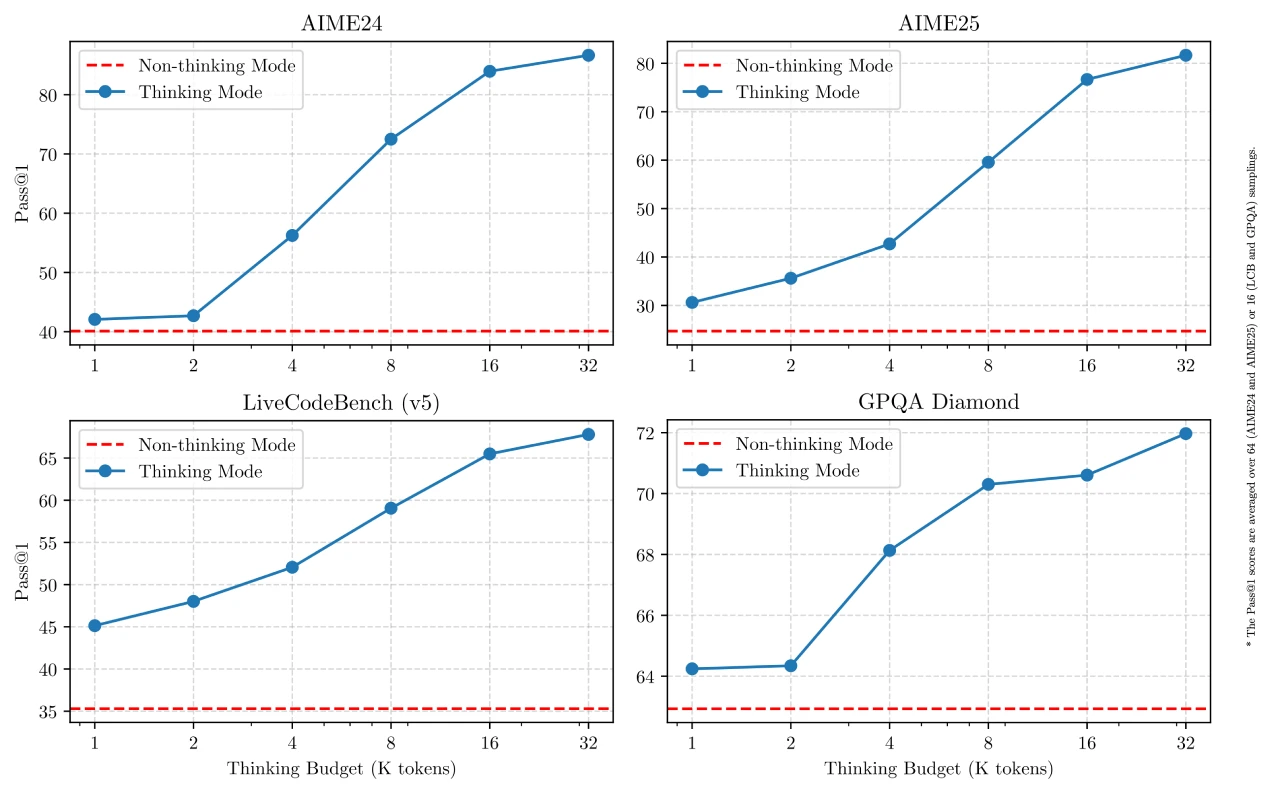
複数の思考モード:思考モードと非思考モードの2つをサポートしています。思考モードは複雑な問題に適しており、モデルは段階的に推論します。非思考モードは簡単な問題に適しており、迅速に対応します。2つのモードの組み合わせにより「思考バジェット」制御能力が強化され、ユーザーは必要に応じて設定できます。
多言語能力:119の言語と方言をサポートし、印欧語族や漢蔵語族など複数の語族を網羅しており、国際的なアプリケーションの可能性を提供します。
強化されたエージェント能力:エージェントとコード能力が最適化され、MCPのサポートが強化され、Qwen-Agentを通じてツール呼び出しのコードの複雑さが軽減されます。
Qwen3のパフォーマンス
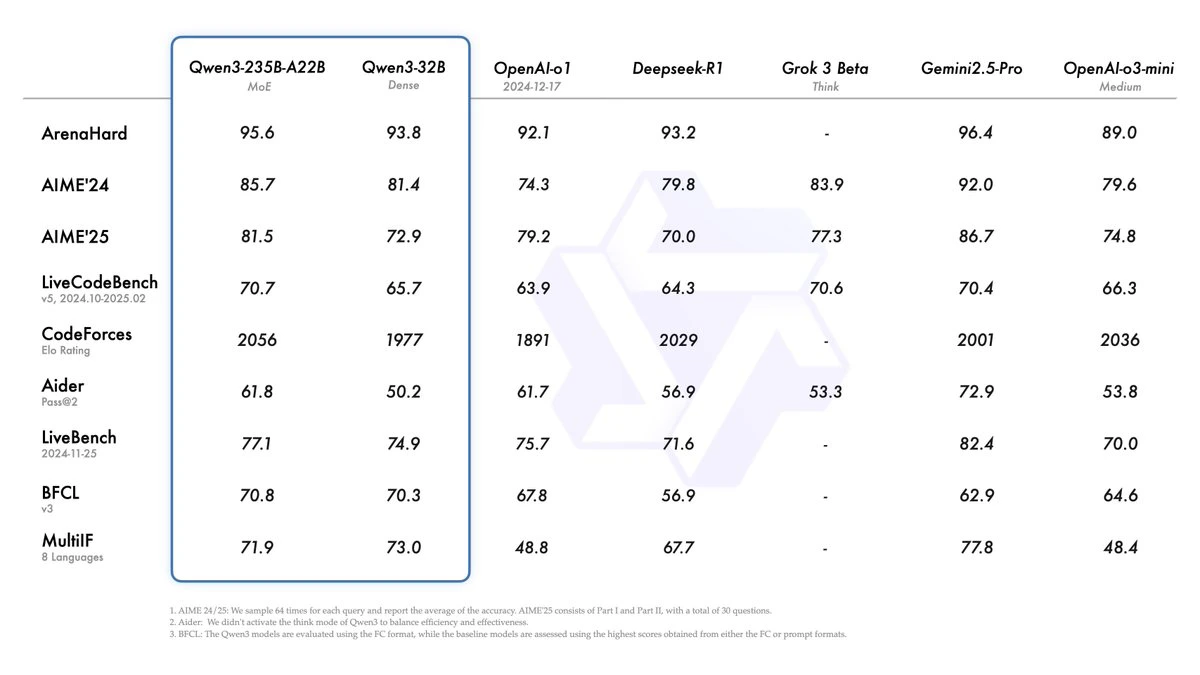
フラッグシップモデル:Qwen3-235B-A22Bはこのシリーズのフラッグシップモデルであり、総パラメータ数2350億以上、活性化パラメータ数220億以上を誇ります。コード、数学、一般能力などのベンチマークテストにおいて、このモデルはDeepSeek-R1、Openaiのo1およびo3-mini、マスク氏のGrok-3、GoogleのGemini-2.5-Proなどのトップモデルと比較して、非常に競争力のある結果を示しています。
小型モデル:小型MoEモデルQwen3-30B-A3Bの活性化パラメータ数はQwQ-32Bの10%ですが、より優れたパフォーマンスを発揮します。さらに、Qwen3-4Bのような小型モデルでもQwen2.5-72B-Instructの性能に匹敵します。
Qwen3の技術的特徴
ハイブリッド推論モデル:Qwen3は中国国内初の「ハイブリッド推論モデル」であり、「速思考」と「遅思考」を同一モデルに統合しています。この設計により、モデルは複雑な問題に対して深い推論を行うことができ、簡単なリクエストに対しては迅速に対応することができます。
多言語サポート:Qwen3は119言語をサポートし、約36兆トークンに基づいて学習されており、学習データ量はQwen2.5の2倍です。
コンテキスト長:Qwen3は最大256Kのコンテキスト長をサポートしており、これにより長文書の分析、コード生成、多輪対話などの複雑なタスクを処理することができます。
Qwen3モデルのパフォーマンスとコスト
フラッグシップ版Qwen3-235B-A22B:総パラメータ数は2350億、活性化パラメータは220億です。DeepSeek-R1と比較すると、総パラメータ数は後者の3分の1のみであり、展開コストは半分以上の節約が見込まれます。さらに、このモデルは「深い思考」モードを必要に応じて有効にすることができ、H20 GPU 4枚のみでローカル展開を実現できます。
Qwen3-30B-A3B:総パラメータ数は300億、活性化パラメータは30億であり、全体的なパフォーマンスはQwen2.5-32Bに匹敵します。
Qwen3の機能特性
MCPプロトコルのネイティブサポート:Qwen3シリーズはツール呼び出し能力を備え、自身のQwen-Agentフレームワークと組み合わせることで、プログラミングの複雑さを大幅に軽減し、スマートフォンやパソコンでのエージェント操作などのタスクをサポートし、AIを対話から実行へと推進します。
多言語サポート:119言語をサポートし、中国語、英語、フランス語、スペイン語、ロシア語、アラビア語などを含みます。
オープンソースモデル:Qwen3シリーズは合計8モデルがオープンソース化されています:
6つのDenseモデル:0.6B、1.7B、4B、8B、14B、32B
2つのMoEモデル:Qwen3-30B-A3Bおよびフラッグシップ版Qwen3-235B-A22B
最小モデルQwen3-0.6B:軽量で、スマートフォンなどのエッジデバイスへの展開に非常に適しており、良好な理解および生成能力を維持しているため、エッジでのスマートアプリケーションに非常に適しています。
学習プロセス
事前学習:データセットはQwen2.5と比較して大幅に拡張され、約36兆トークンに達し、Qwen2.5の2倍です。データソースにはウェブ、PDFドキュメントなどが含まれ、専門モデルを利用して数学やコードのデータを合成しています。事前学習は3つの段階に分かれており、基本的な言語スキルの学習から知識集約型データの学習を追加し、コンテキスト長を32Kトークンに拡張するまでを行います。
事後学習:4段階の学習フローを採用し、長い思考チェーンのコールドスタート、長い思考チェーンの強化学習、思考モードの融合、および一般的な強化学習を含み、思考推論と迅速な対応能力を兼ね備えたハイブリッドモデルを開発します。
使用方法
基本的な使用方法:Hugging FaceのtransformersでQwen3-30B-A3Bを使用するための標準サンプルコードがあり、enable_thinkingパラメータを変更することで思考モードを切り替えることができます。
展開:sglang>=0.4.6.post1またはvllm>=0.8.4を使用することで、OpenAI API互換のAPIエンドポイントを作成でき、特定のパラメータを削除することで思考モードを無効にできます。
ローカル開発:ollama、LMStudio、llama.cpp、ktransformersなどのツールを使用してローカル開発を行うことができます。
高度な使用方法:ソフトスイッチングメカニズムが提供されており、ユーザーのプロンプトやシステムメッセージに/thinkと/no_thinkを追加することで、ターンごとに思考モードを切り替えることができます。
関連リンク
ブログ:https://qwenlm.github.io/zh/blog/qwen3/
HF:https://huggingface.co/collections/Qwen/qwen3-67dd247413f0e2e4f653967f
github:https://github.com/QwenLM/Qwen3
Demo:https://huggingface.co/spaces/Qwen/Qwen3-Demo
Qwen Chat:https://chat.qwenlm.ai









