
 脚本プランナー▸
 AIアプリ
 AIニュース
No-OCR:OCRテキスト抽出が不要なドキュメント処理ツール
小编 ·

No-OCR:OCRテキスト抽出が不要なドキュメント処理ツール
No-OCRとは?
No-OCRは、複雑なOCRテキスト抽出を必要としないドキュメント処理ツールです。PDFファイルをアップロードするだけで、複数のドキュメントコレクション内のコンテンツを迅速に検索・照会でき、従来のOCR技術に依存しないため、ドキュメント分析の効率を向上させます。PDF/ドキュメントコレクションの作成と管理をサポートし、「ケース」ごとに分類して整理できるほか、Hugging Faceスタイルのデータセットも自動構築します。さらに、No-OCRはベクトルベースのPDFページや関連画像の検索機能(LanceDBを使用)を備え、Qwen2-VLによる画像やチャートの視覚的質問応答も可能です。テキストとビジュアルクエリのハイブリッド検索をサポートし、Dockerで簡単にデプロイでき、設定もシンプルで、詳細な開発インストール手順も提供されています。
No-OCRの特徴
OCR不要:OCR技術に完全に依存しないため、視覚コンテンツが豊富なPDFファイルに適しています。
シンプルで使いやすい:PDFファイルをアップロードするだけで検索でき、複雑な視覚コンテンツ(テーブル、チャート、レイアウトなど)にも対応します。
オープンソースモデル:オープンソースのLLM(大規模言語モデル)に基づいてコンテンツの検索と解釈を行います。
デプロイ可能:Dockerデプロイをサポートし、あらゆるエンタープライズ環境に対応します。
No-OCRの使用シーン
適用シーン:ドキュメントにテーブル、チャート、レイアウトなどの豊富な視覚コンテンツが含まれている場合、No-OCRは非常に良い選択肢です。
不適用シーン:ドキュメントが主にプレーンテキストコンテンツである場合、従来のBM25検索の方が適している可能性があります。
混合コンテンツ:ドキュメントにテキストと視覚コンテンツが混在している場合、必要に応じてソリューションを調整する必要があるかもしれません。
No-OCRのアーキテクチャ設計
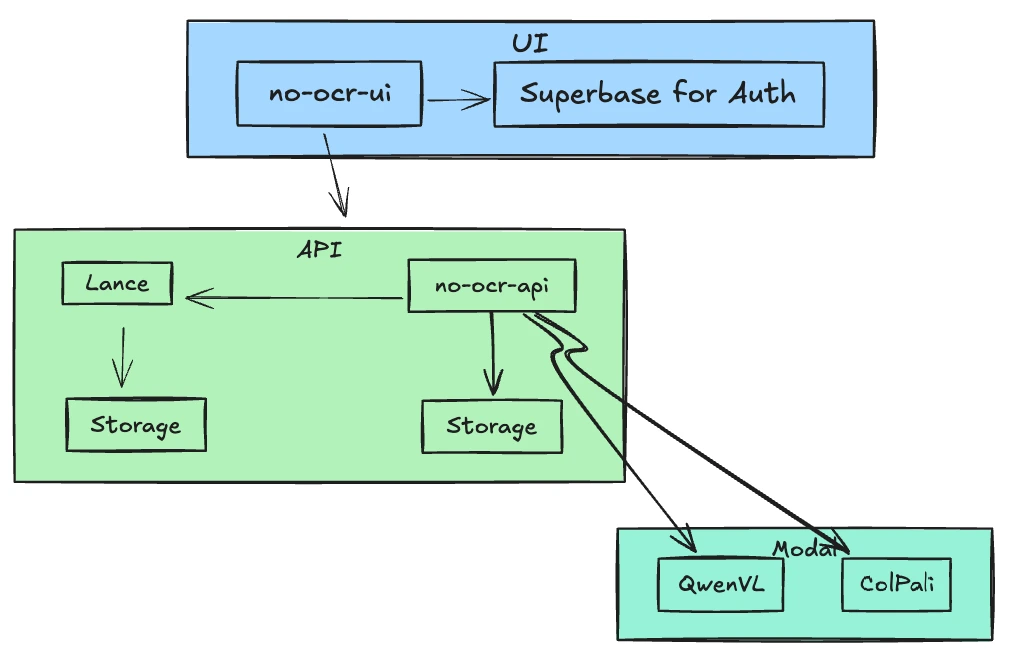
シンプルなアーキテクチャ:データベースやメッセージキューに依存せず、すべての永続化操作はファイルシステムに基づいています。
主要サービス:
Modal:LLMのデプロイに使用。
Qdrant:多ベクトル検索に使用。
Supabase:ユーザー認証と認可に使用。
ケースの作成:ユーザーがPDFファイルをアップロードしケース名を指定すると、システムがPDFをデータセットに変換してQdrantにアップロードします。
検索フロー:ユーザーが検索クエリを入力すると、LLMが関連ページを識別しコンテンツを解釈します。
No-OCRのLLMモデル
ColPaliファミリー:画像検索に使用され、画像を検索可能な形式に変換します。
Qwen2-VLファミリー:視覚コンテンツ推論に使用され、特にQwen2-VL-7B-Instructモデルは、現在最も先進的なオープンソース視覚モデルの一つです。
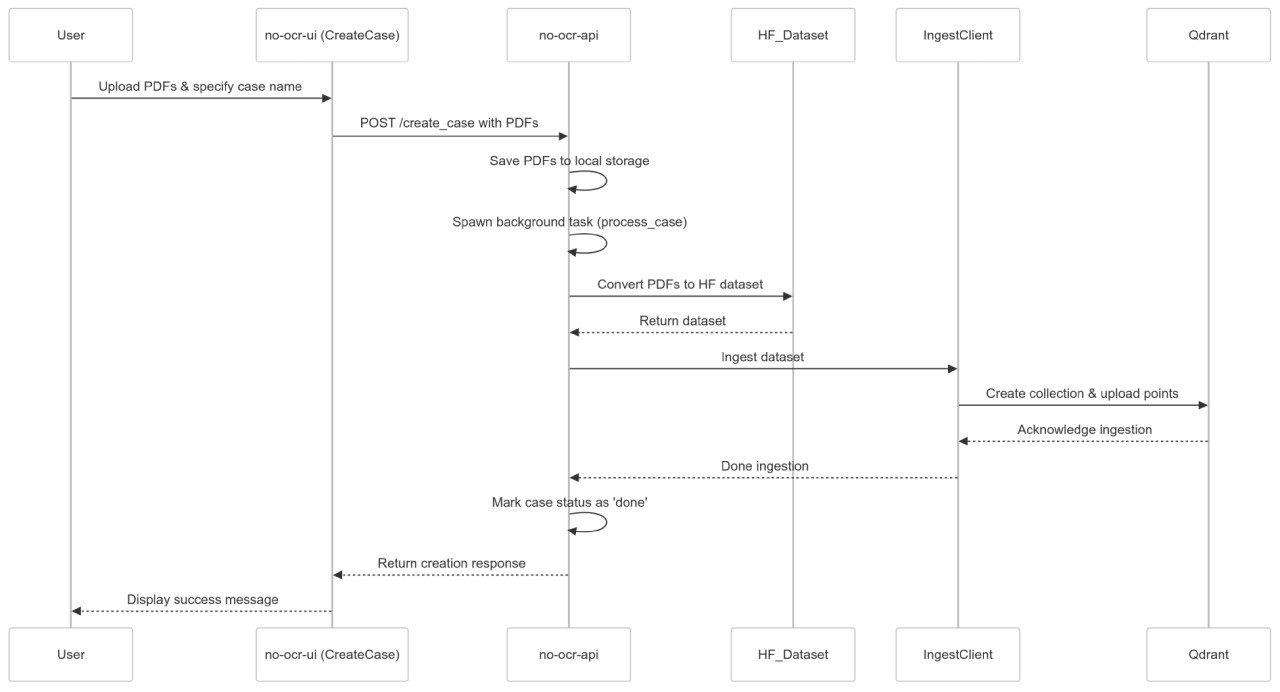
ケース作成フロー
動作原理
No-OCRプラットフォームは簡素化されたRAGアプローチを採用しており、ユーザーはPDFファイルをアップロードしてケースを作成するだけで、システムがこれらのファイルを処理し検索可能にします。視覚要素に関する質問を含むあらゆる質問が可能で、プラットフォームはトップクラスのオープンソース推論モデルを利用して回答を提供します。
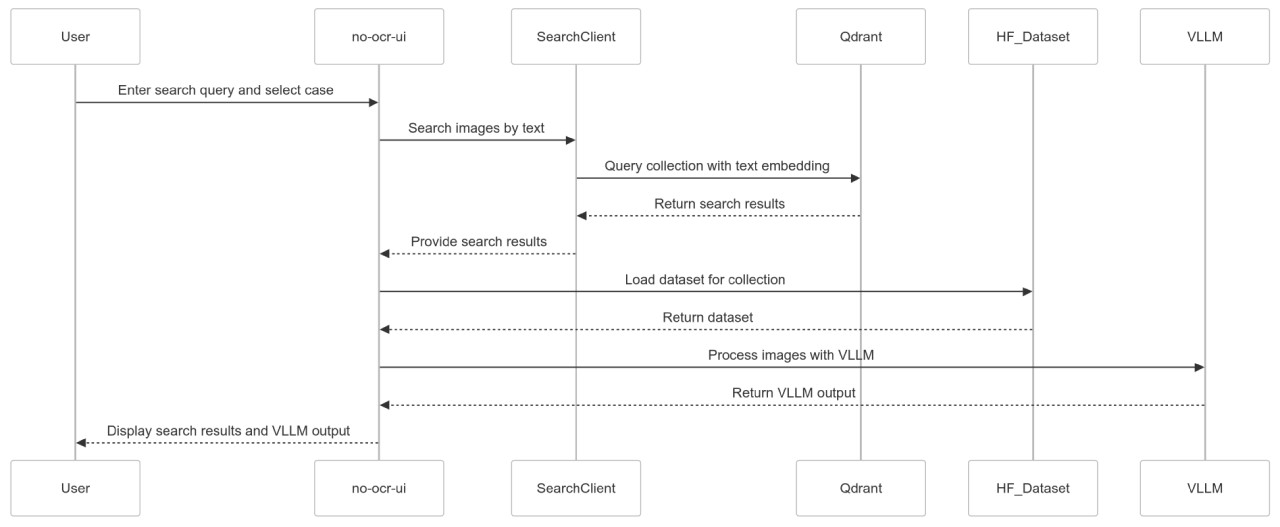
検索フロー
No-OCRの使用手順
複雑なPDFをアップロードして処理:ユーザーが challenging なPDFファイルをアップロードして新しいケースを作成し、複雑なOCR処理なしで埋め込みを生成します。
検索可能にする:処理完了後、ユーザーはテキストベースのクエリを実行でき、PDFレイアウトがどれだけ複雑でも、関連ページと引用を迅速に見つけられます。
視覚関連の問題を提起する:プラットフォームが関連ページを迅速に特定し、専門的なオープンソース視覚モデルを通じてさらに回答を精錬するため、PDFにチャートや図表が含まれていても、文脈を考慮した洞察を提供します。
TLDR:https://no-ocr.com/about
Github:https://github.com/kyryl-opens-ml/no-ocr









