
 脚本プランナー▸
 AIアプリ
 AIニュース
Video-R1:香港中文大学と清華大学が共同発表した世界初の動画版R1モデル
小编 ·

Video-R1:香港中文大学と清華大学が共同発表した世界初の動画版R1モデル
Video-R1とは?
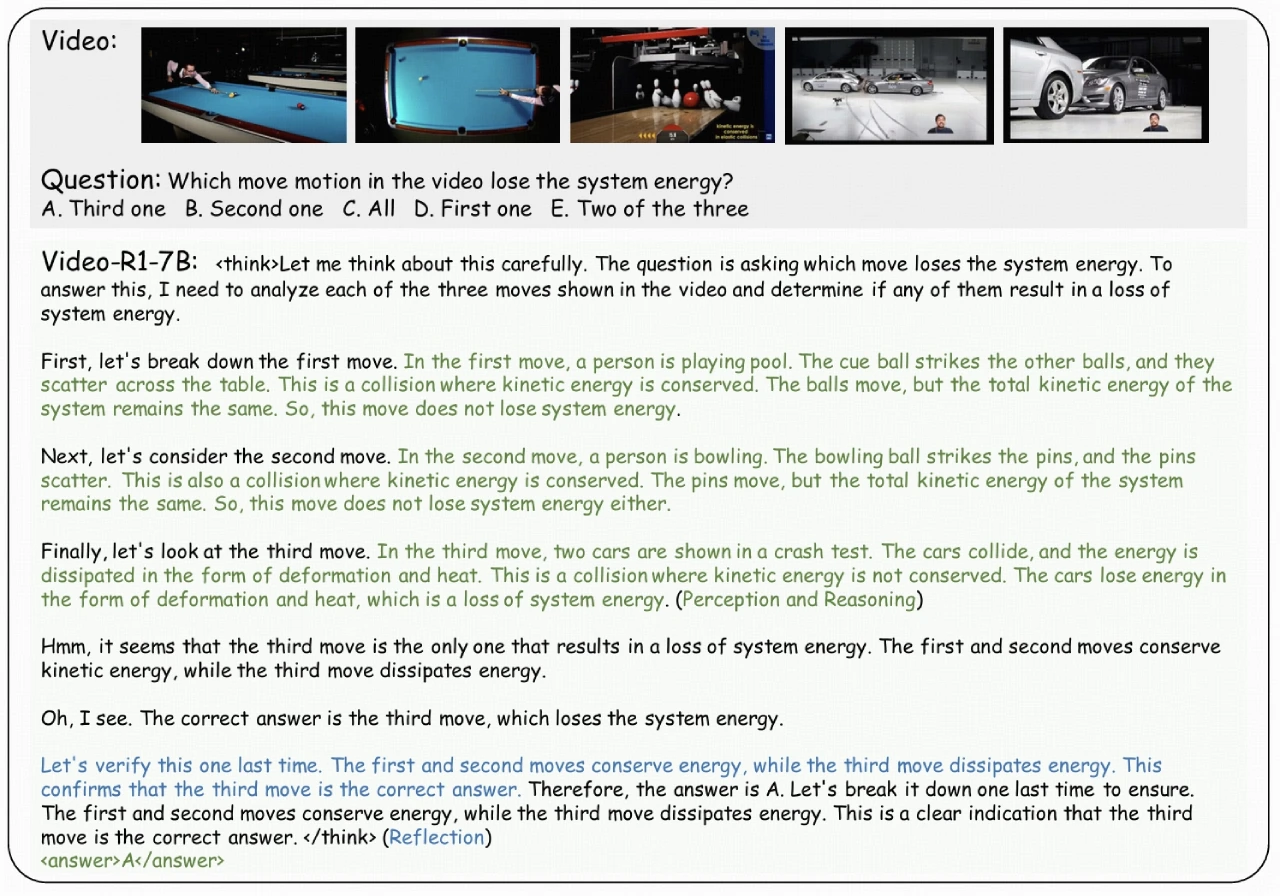
Video-R1は、香港中文大学と清華大学が共同で発表した世界初の動画版R1モデルであり、強化学習によってマルチモーダル大規模言語モデル(MLLMs)の動画推論能力を向上させます。
Video-R1の機能
時間認識推論:Video-R1はT-GRPOアルゴリズムを導入し、順序を入れ替えた入力と順序通りの入力の動画フレームを比較することで、モデルが時間情報を利用して推論するよう奨励し、動画内の時系列関係をより深く理解できるようにします。
混合データトレーニング:高品質な動画推論データが不足している問題を解決するため、Video-R1は画像と動画を組み合わせたデータセットでトレーニングを行います。Video-R1-COT-165k(SFTコールドスタート用)とVideo-R1-260k(RLトレーニング用)が含まれており、静的画像の推論能力から動的動画の推論能力への移行を可能にします。
多様な出力タイプ:Video-R1は、多肢選択、数値、OCR、自由形式、回帰など、さまざまな回答出力タイプをサポートしています。
自己反省的な推論行動:モデルは推論プロセス中に自己反省を行い、より正確な結論を導くために推論の方向を調整します。この「ああ、分かった瞬間」は、モデルが内部フィードバックループを積極的に行っていることを示しています。
Video-R1の技術
時間認識アルゴリズムT-GRPO:このアルゴリズムはモデルの時系列理解能力を強化し、モデルがイベント間の因果関係を深く考察できるようにします。従来のGRPOアルゴリズムと比較して、T-GRPOは報酬メカニズムを通じて時間理解を結び付け、順序通りの入力でより高い正解率を上げた場合にのみモデルが報酬を得られるようにします。
画像と動画の混合データセット:研究者らは2つの高品質データセットを作成しました。Video-R1-COT-165k(画像中心)とVideo-R1-260k(高品質動画中心)で、動画推論データの不足という問題を解決しています。この混合トレーニング手法により、モデルは「画像について話す」から「動画を深く考える」へと進化し、真のマルチモーダル理解を実現します。
強化学習トレーニング戦略:Video-R1は強化学習トレーニングを通じて、トレーニングプロセス中にモデルが徐々に最適でない推論パターンを捨て、より効率的で論理的な表現パスを形成します。
Video-R1の応用
動画コンテンツ分析:Video-R1は動画内の動的コンテンツを効率的に解析・理解することができ、主要な動画クリップの自動生成、行動認識、スマートタグ生成などの機能に使用できます。
動画検索と推薦:深い推論を通じて、Video-R1はユーザーのニーズをより正確に理解し、ユーザーの興味により合った動画コンテンツの推薦を提供できます。
自動運転の視覚理解:モデルは動画内の時系列関係と因果論理を理解でき、自動運転システムが道路環境をより適切に認識・予測するのに役立ちます。
動画監視とセキュリティ:Video-R1は監視映像のリアルタイム分析に使用でき、異常な行動やイベントを迅速に識別して公共安全を向上させます。
教育とトレーニング:教育分野では、Video-R1はインテリジェント個別指導システムに使用でき、教育動画コンテンツを分析して学生にパーソナライズされた学習アドバイスを提供できます。
スマートホーム:モデルはスマートホームシステムに統合でき、動画分析を通じてよりスマートな環境認識と自動制御を実現します。
GitHubアドレス:https://github.com/tulerfeng/Video-R1
論文:https://arxiv.org/abs/2503.21776









