
 脚本プランナー▸
 AIアプリ
 AIニュース
WeClone:WeChatのチャット履歴でLLMをファインチューニングし、個人のデジタルツインを作成
小编 ·

WeClone:WeChatのチャット履歴でLLMをファインチューニングし、個人のデジタルツインを作成
WeCloneとは?
WeClone はオープンソースプロジェクトであり、WeChat のチャット記録によって LLM をファインチューニングし、WeChat の音声メッセージと大規模モデルを組み合わせることで高品質な音声クローンを実現し、最終的に WeChat のボットに連携させることで、個人のAIデジタル分身を実現することを目的としています。
WeClone の機能
WeChat のチャット記録による LLM のファインチューニング:ユーザー自身の WeChat チャット記録を用いて言語モデルをファインチューニングし、より個人の言語スタイルや習慣に合ったものにします。
高品質な音声クローン:WeChat の音声メッセージと0.5B 大規模モデルを組み合わせ、高品質な音声クローンを実現します。
WeChat ボットへの連携:ファインチューニングしたモデルを WeChat ボットに連携させ、自動返信などの機能を実現し、個人のデジタル分身として機能します。
WeClone の特徴
ハードウェア要件:デフォルトでは chatglm3-6b モデルを使用し、LoRA 手法でのファインチューニングには約16GB の VRAM が必要です。他のモデルや手法は自行で設定可能です。
ソフトウェア要件:Python 3.10 の使用を推奨し、特定バージョンの PyTorch、Transformers などのライブラリが必要です。
環境構築:Git を使ってプロジェクトをクローンし、Conda を使って環境を作成して依存パッケージをインストールします。
データ準備:PyWxDump を使って WeChat のチャット記録を抽出し、CSV 形式でエクスポートします。
データ前処理:機密情報を除去し、さまざまなデータ処理方式をサポートします。
モデルダウンロード:Hugging Face または魔搭コミュニティから ChatGLM3 モデルをダウンロードすることを推奨します。
モデルのファインチューニング:settings.json を変更してパラメータを設定し、単一 GPU または複数 GPU で学習を行います。
推論とテスト:ブラウザ上のデモと API 推論機能を提供し、一般的なチャットに関する質問のテストをサポートします。
WeChat ボットのデプロイ:QRコードでログインし、プライベートチャットやグループチャットでのボットとの対話をサポートします。
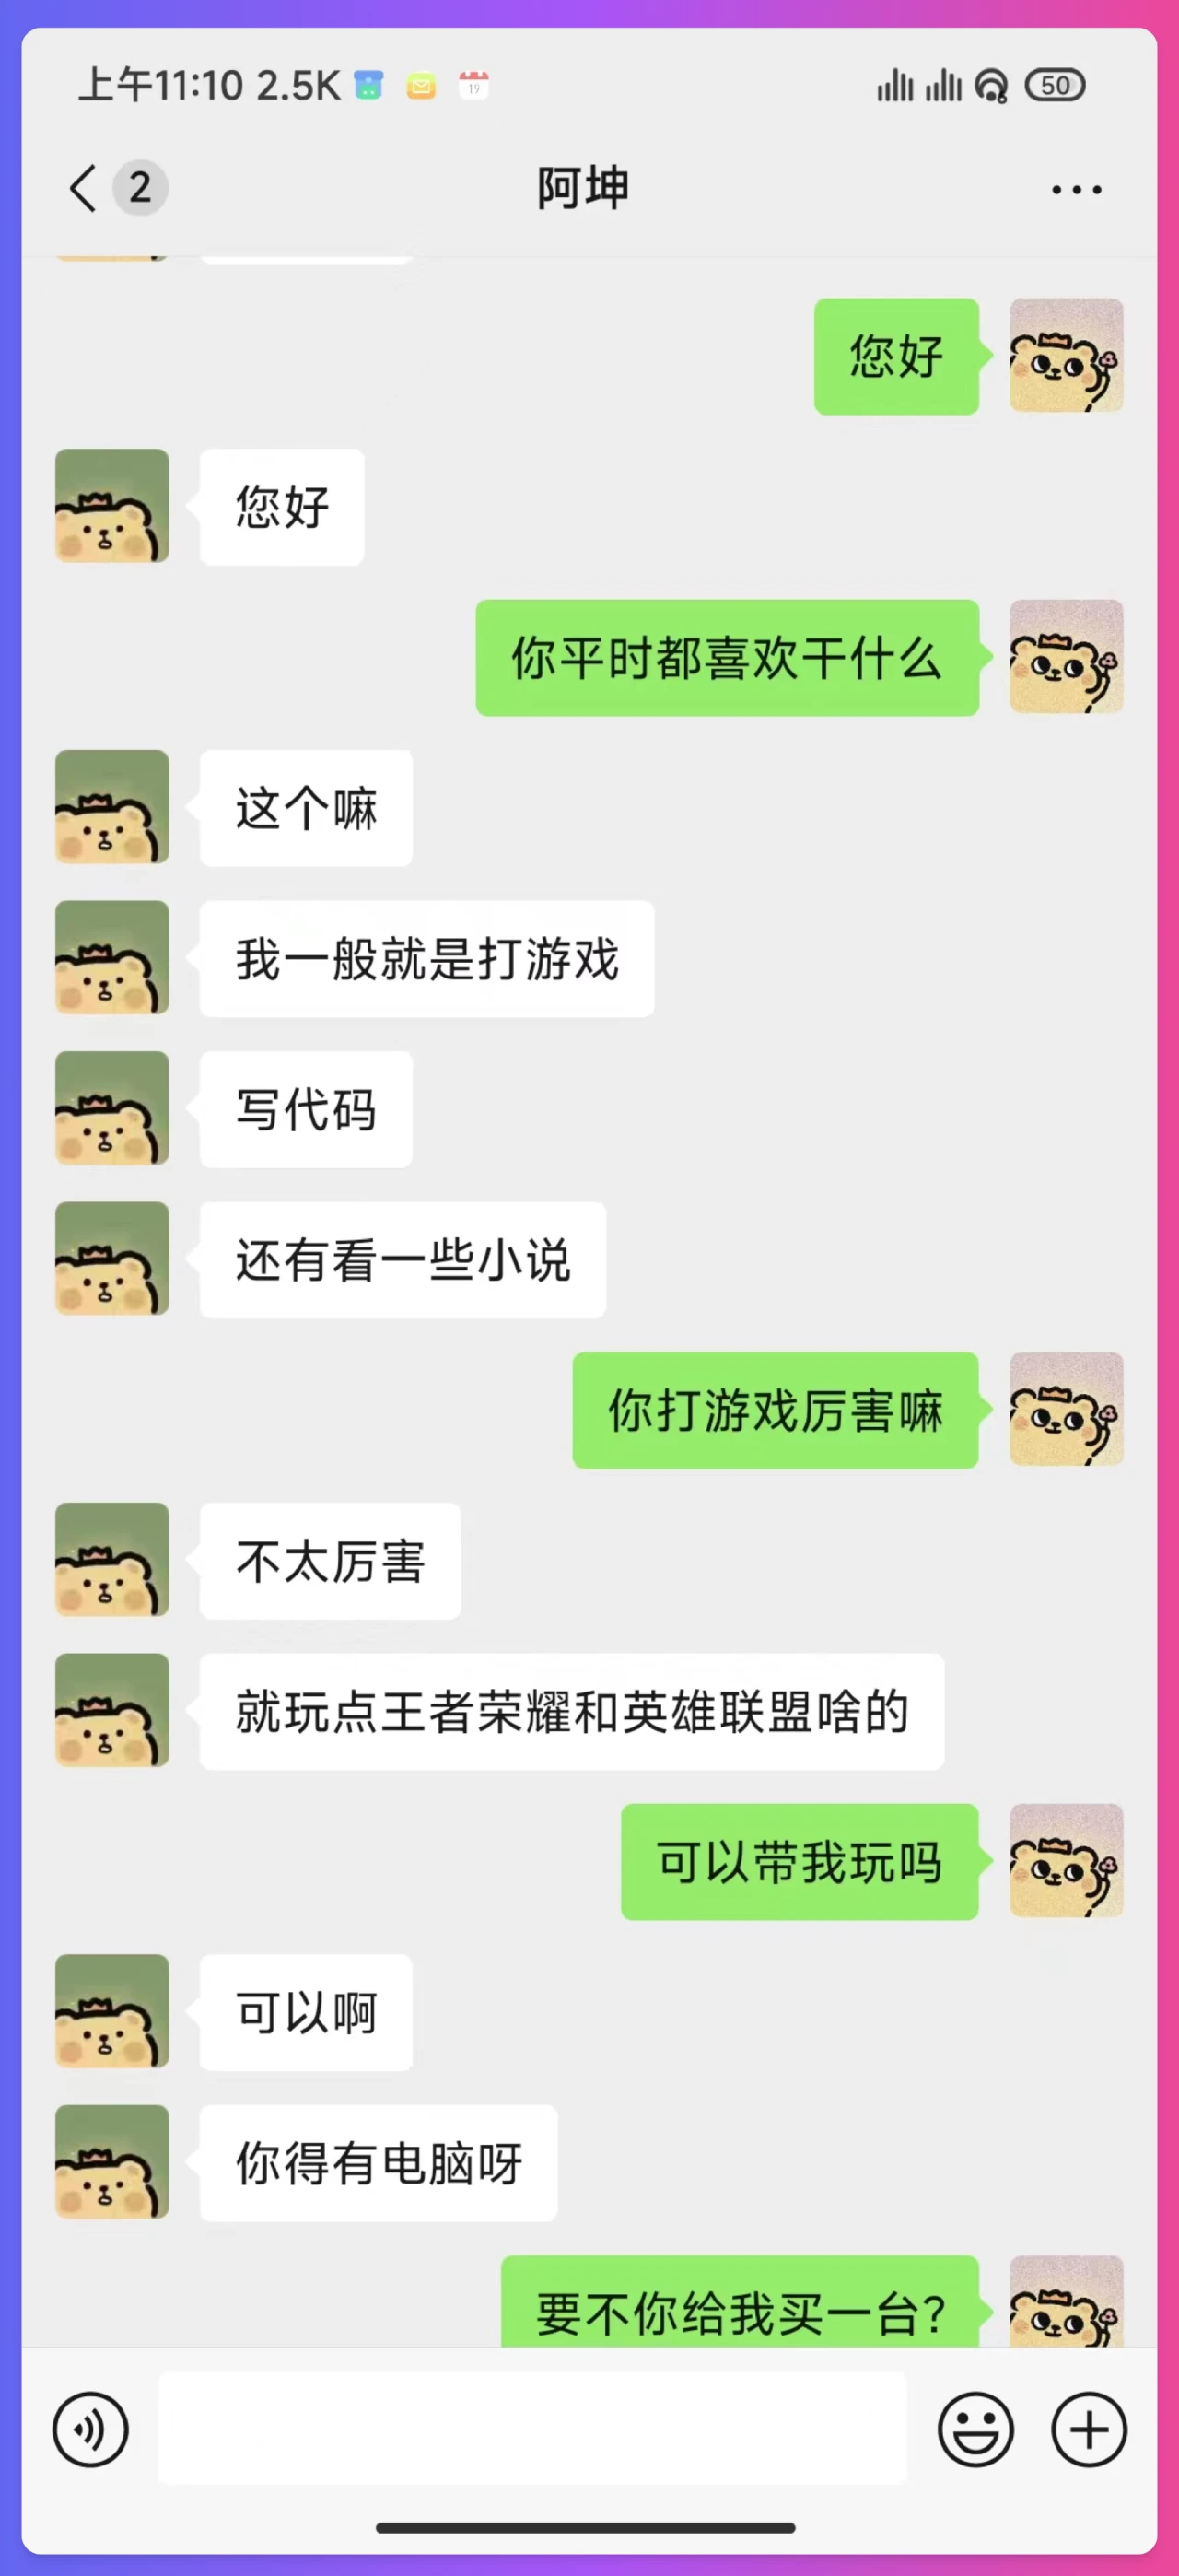
WeClone の使用手順
環境構築
プロジェクトのクローン:ターミナルで以下のコマンドを実行し、WeClone プロジェクトをローカルにクローンします。
git clone https://github.com/xming521/WeClone.git
仮想環境の作成と有効化:Conda を使って新しい Python 環境を作成し、その環境を有効化します。
conda create -n weclone python=3.10
conda activate weclone
依存パッケージのインストール:プロジェクトディレクトリに移動し、プロジェクトに必要な依存パッケージをインストールします。
cd WeClone
pip install -r requirements.txt
データ準備
WeChat チャット記録の抽出:PyWxDump ソフトウェアを使用して WeChat のチャット記録を抽出します。このソフトウェアをダウンロードしてインストールし、データベースの復号化後、チャットバックアップをクリックして、エクスポート形式として CSV を選択します。複数の連絡先やグループチャットのチャット記録をエクスポートできます。
データの配置:wxdump_tmp/export にエクスポートされた csv フォルダーをプロジェクトディレクトリ内の ./data ディレクトリに配置します。つまり、異なる人物のチャット記録のフォルダーをまとめて ./data/csv に配置します。サンプルデータは data/example_chat.csv にあります。
データ前処理
機密情報の除去:プロジェクトはデフォルトでデータから電話番号、身份证番号、メールアドレス、URL などの機密情報を除去します。また、禁止語ライブラリの blocked_words が提供されており、自らフィルタリングが必要な単語や文章を追加することができ、プログラムはデフォルトで禁止語を含む文章全体を削除します。
データ形式の処理:./make_dataset/csv_to_json.py スクリプトを実行してデータを処理します。同一人物が連続して複数の回答をした場合、以下の3つの処理方式のうち1つを選択できます。
csv_to_json.py を使用:複数の回答をカンマで連結します。
csv_to_json-单句回答.py(废弃)を使用:最も長い回答のみを最終データとして選択します。
csv_to_json-单句多轮.py を使用:複数の回答をプロンプトの 'history' に配置します。
モデルのダウンロード
Hugging Face を優先:Hugging Face で ChatGLM3 モデルをダウンロードします。Hugging Face モデルでダウンロードに問題が発生した場合は、魔搭コミュニティのモデルを使用できます。
魔搭コミュニティの使用:魔搭コミュニティのモデルを使用することを選択した場合、魔搭コミュニティのモデルを使用するためにまず以下のコマンドを実行する必要があります。
export USE_MODELSCOPE_HUB=1 # Windows では `set USE_MODELSCOPE_HUB=1` を使用
git lfs install
git clone https://www.modelscope.cn/ZhipuAI/chatglm3-6b.git
注意:魔搭コミュニティの modeling_chatglm.py ファイルは、Hugging Face のものに置き換える必要があります。
パラメータの設定とモデルのファインチューニング
設定ファイルの変更:学習および推論関連の設定は settings.json ファイルに統一されています。必要に応じて以下のパラメータを変更できます。
per_device_train_batch_size および gradient_accumulation_steps を変更して VRAM 使用量を調整します。
データセットの量と品質に応じて num_train_epochs、lora_rank、lora_dropout などのパラメータを変更します。
(オプション)settings.json を変更してローカルにダウンロード済みの他のモデルを選択します。
単一 GPU での学習:以下のコマンドを実行して sft 段階のファインチューニングを行います。
python src/train_sft.py
作者によると、彼自身の loss は 3.5 程度までしか下がらず、下げすぎると過学習になる可能性があるとのことで、彼は統合された有効データ約2万条を使用したそうです。
複数 GPU での学習:複数の GPU がある場合、deepspeed を使用して複数 GPU で学習することができます。まず deepspeed をインストールし、以下のコマンドを実行します。
pip install deepspeed
deepspeed --num_gpus=使用するGPUの数 src/train_sft.py
推論とテスト
ブラウザデモを使用した簡単な推論:プロジェクトではブラウザデモが提供されており、簡単な推論テストを行うことができます。
API を使用した推論:以下のコマンドを実行して api サービスを起動します。
python ./src/api_service.py
一般的なチャット質問によるテスト:以下のコマンドを実行して一般的なチャット質問のテストを行います。
python ./src/test_model.py
WeChat チャットボットのデプロイ
api サービスの起動:まず以下のコマンドを実行して api サービスを起動します。
python ./src/api_service.py
WeChat ボットスクリプトの実行:次に以下のコマンドを実行して WeChat チャットボットを起動します。
python ./src/wechat_bot/main.py
デフォルトではターミナルにQRコードが表示されるので、スキャンしてログインします。プライベートチャットまたはグループチャットで @ ボットに指定して使用できます。
注意事項:WeChat にはアカウント凍結のリスクがあるため、サブアカウントを使用することを推奨し、また银行卡 を绑定 しなければ使用できません。
音声クローンモジュール(WeClone-audio)
Spark-TTS 方案(推奨):
関連モジュールをインポートする。
import SparkTTS
from SparkTTS import SparkTTS
モデルを初期化する。
model = SparkTTS("WeClone-audio/pretrained_models/Spark-TTS-0.5B", "cuda")音声クローン推論を実行する。
with torch.no_grad():
wav = model.inference(
text="要生成的文本内容",
prompt_speech_path="示例音频路径",
prompt_text="示例音频对应的文本",
)
Llasa 方案:
関連モジュールをインポートする。
from text_to_speech import TextToSpeech
初期化を行い、推論を実行する。
tts = TextToSpeech(sample_audio_path, sample_audio_text)
result = tts.infer("要生成的文本内容")Githubアドレス:https://github.com/xming521/WeClone









