
 脚本プランナー▸
 AIアプリ
 AIニュース
PDF Document Layout Analysis:DockerベースのPDFレイアウト解析&PDF OCRサービス
小编 ·

PDF Document Layout Analysis:DockerベースのPDFレイアウト解析&PDF OCRサービス
PDF Document Layout Analysisとは?
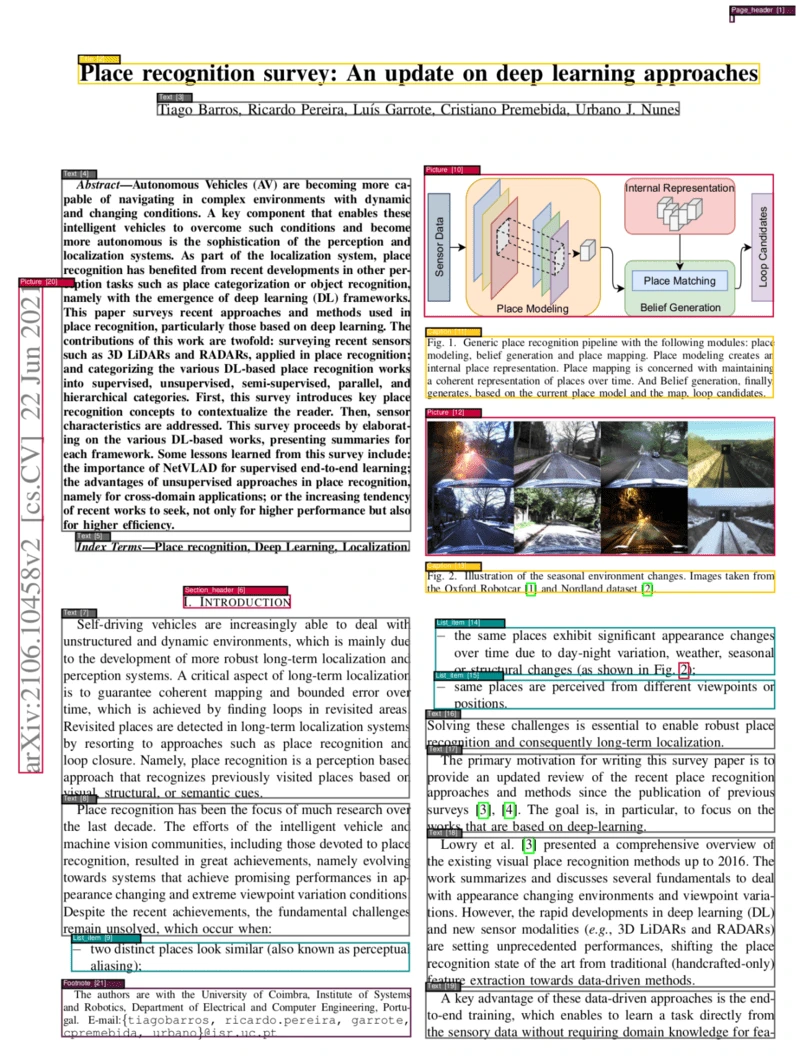
PDF Document Layout Analysis は、Docker ベースの PDF ドキュメントのレイアウト解析用サービスです。PDF ページの各部分を分割および分類し、テキスト、タイトル、画像、表などの要素を正確かつ自動的に認識して、正しい順序を特定することができます。
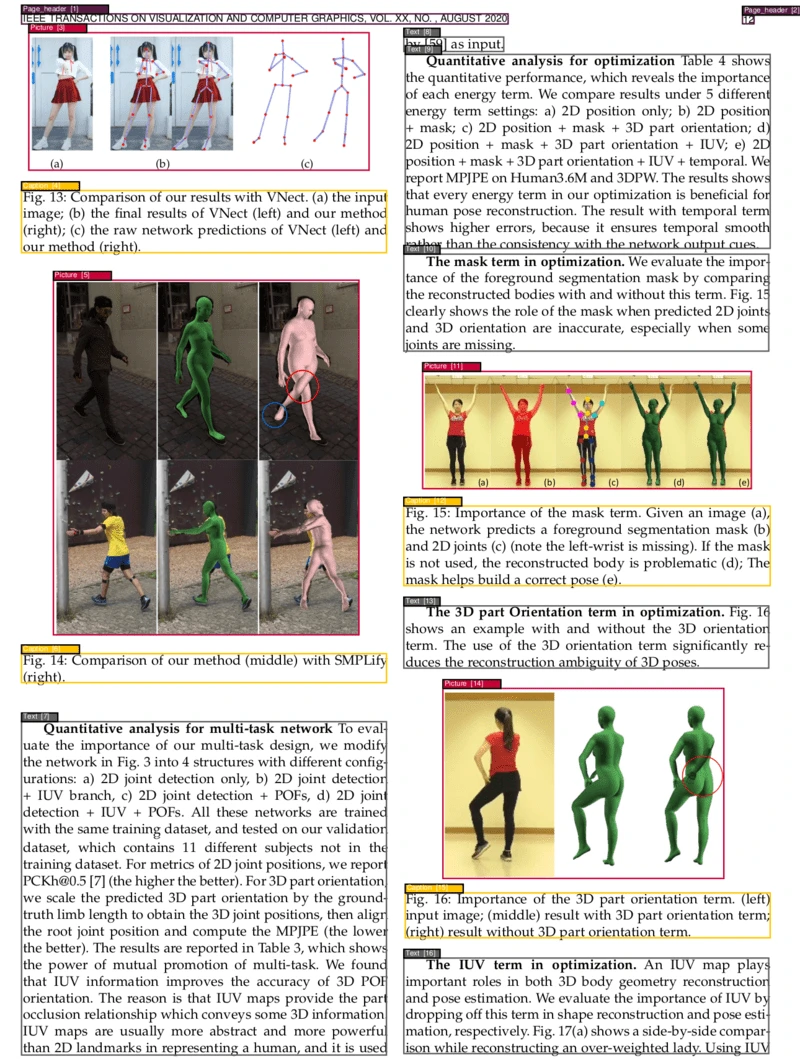
PDF Document Layout Analysisの機能と特徴
1. OCR 機能
多言語サポート:複数の言語の OCR 機能をサポートしており、ユーザーは言語パラメータを指定することで、さまざまな言語の PDF ドキュメントを処理できます。
テキスト抽出:PDF 内の画像や検索不可能なテキストを検索可能なテキスト形式に変換し、後処理や分析を容易にします。
2. ページ分割と分類
複数要素の認識:PDF ページ内のさまざまな要素を認識・分類できます。
テキスト:通常のテキストコンテンツ。
タイトル:ドキュメントのタイトルおよび小見出し。
画像:ページ内の画像。
表:表のコンテンツ。
数式:LaTeX 形式での出力をサポートする数式。
リスト項目:順序付きまたは順序なしのリスト。
ヘッダーとフッター:ページのヘッダーとフッター。
脚注:ドキュメント内の脚注。
その他:画像キャプション、表のタイトルなど。
高精度な分類:先進的な視覚モデル(Vision Grid Transformer - VGT など)や機械学習モデル(LightGBM など)を使用し、高精度な分類結果を保証します。
3. 要素の並べ替え
論理順序:ページのレイアウトと要素の種類に基づいて、要素の論理順序を自動的に決定し、出力結果がドキュメントの読み順と一致するようにします。
カスタム並べ替えルール:Poppler の初期読み順と段落タイプを組み合わせて要素を並べ替え、論理的で一貫した出力を保証します。
4. 可視化出力
可視化 PDF:分析結果を新しい PDF ファイルとして可視化する機能をサポートしており、ユーザーは分割と分類の結果を直感的に確認できます。
注釈機能:可視化出力では、異なる種類の要素が異なる色やスタイルで注釈付けされ、区別しやすくなっています。
5. 表と数式の抽出
表の抽出:表を Markdown、LaTeX、HTML などさまざまな形式で抽出でき、さらなる処理や分析が容易です。
数式の抽出:数式は LaTeX 形式で出力されるため、学術・工学ドキュメントでの使用に便利です。
PDF Document Layout Analysisの使用シーン
学術研究:研究論文からテキスト、図、表、参考文献を抽出・整理し、文献レビューやデータ分析を容易にします。
法律ドキュメントの分析:法律文書、契約、判例ファイルを分析・構造化します。
ビジネスレポート:財務データ、グラフ、主要指標を自動抽出し、インサイトやサマリーの生成を容易にします。
アーカイブとデジタル化:歴史的ドキュメント、原本、記録をデジタル化・分類し、検索しやすい形式で保存します。
出版・メディア:原本、記事、レポートのコンテンツを整理・フォーマットし、一貫性と品質を保証します。
クイックスタート
サービスの実行:GPU モードと非 GPU モードの両方をサポート。
OCR 機能:複数言語をサポートし、curl コマンドで呼び出し可能。
分割結果の取得:curl コマンドで PDF ファイルを送信し、分割された結果を取得します。
サービスの停止:サーバーを停止するコマンドを提供。
依存関係と要件
Docker Desktop:Docker Desktop 4.25.0 以降のインストールが必要。
GPU サポート:GPU アクセラレーションが必要な場合は、対応する GPU サポートソフトウェアをインストールする必要があります。
ハードウェア要件:最低 2 GB のメモリが必要。GPU を使用する場合は 5 GB の GPU メモリが必要です。
モデル
視覚モデル(Vision Grid Transformer - VGT):デフォルトモデルで、Alibaba 研究チームによってトレーニングされた、より複雑なレイアウト分析をサポートしますが、より多くのリソースを必要とします。
LightGBM モデル:非視覚モデルで、Poppler によって抽出された XML 情報を使用して分類と分割を行い、速度が速く、リソース消費が少ないモデルです。
データ
学習データ:DocLayNet データセットを使用。タイトル、脚注、数式、リスト項目など 11 種類のカテゴリを含みます。
使用方法
基本コマンド:curl コマンドで PDF ファイルを送信し、視覚モデルまたは非視覚モデルの使用を選択します。
可視化出力:分析結果を PDF ファイルとして可視化することをサポート。
表と数式の抽出:表と数式をさまざまな形式(LaTeX、Markdown など)で抽出することをサポート。
出力順序
並べ替えルール:Poppler の初期読み順と段落タイプに基づいて並べ替え、論理的な出力順序を保証します。
パフォーマンスと速度
パフォーマンス:VGT モデルは PubLayNet データセットで優れた性能を発揮し、平均正解率は 96% を超えます。
速度:非視覚モデルは CPU 上で 1 ページあたり 0.42 秒、視覚モデルは GPU 上で 1.75 秒、CPU 上で 13.5 秒の処理速度です。
関連リンク
GitHub:https://github.com/huridocs/pdf-document-layout-analysis
DockerHub:https://hub.docker.com/r/huridocs/pdf-document-layout-analysis









