
 脚本プランナー▸
 AIアプリ
 AIニュース
UNO:バイトダンスが開発した多主体条件付き画像生成モデル
小编 ·

UNO:バイトダンスが開発した多主体条件付き画像生成モデル
UNOとは?
UNOはバイトダンス研究チームが開発した多主体条件付き画像生成モデルであり、拡散変換器のコンテキスト生成能力を通じて、高一貫性を持つ多主体ペアデータを生成します。
UNOの主な特徴
複数画像条件生成:単一主体および複数主体による画像生成をサポートし、1枚または複数の参照画像に基づいて新しい画像を生成できます。
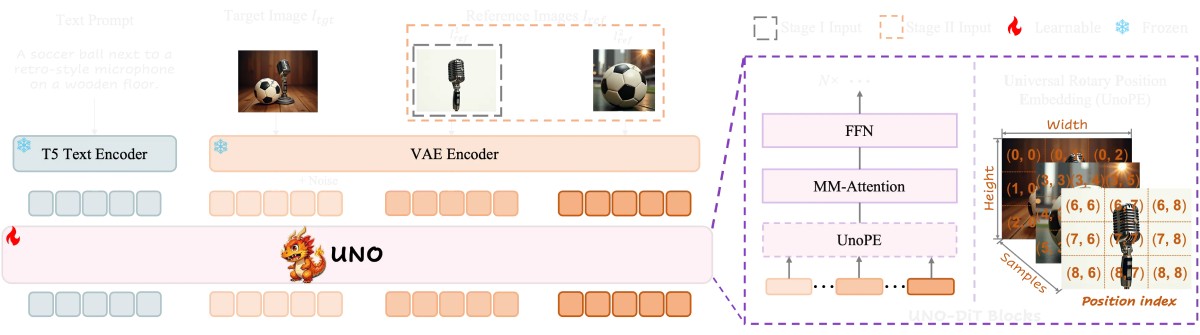
段階的クロスモーダル整合:異なるモーダル(テキストと画像など)を段階的に整合させることで生成の一貫性を高め、2つの段階に分かれます。第1段階では、単一主体のコンテキスト生成データを用いて事前学習済みのテキスト-to-画像モデルをファインチューニングし、主体-to-画像モデルに変換します。第2段階では、生成された多主体データペアを用いて学習を継続します。
汎用回転位置埋め込み:多様な解像度とアスペクト比の画像生成をサポートし、視覚的主体制御を拡張する際に発生する属性混同の問題を効果的に緩和します。
UNOの重要なメカニズム:
段階的クロスモーダル整合(Progressive Cross-Modal Alignment):2つの段階に分かれます。第1段階では、単一主体のコンテキスト生成データを用いて事前学習済みのテキスト-to-画像モデルをファインチューニングし、主体-to-画像モデルにします。第2段階では、生成された多主体データペアを用いて学習を継続します。
汎用回転位置埋め込み(Universal Rotary Position Embedding、UnoPE):視覚的主体制御を拡張する際に発生する属性混同の問題を効果的に緩和し、多様な解像度とアスペクト比の画像生成をサポートします。
UNOの仕組み
UNOは拡散変換器のコンテキスト生成能力を活用して、高一貫性を持つ多主体ペアデータを生成します。テキスト-to-画像モデルから反復的に学習され、独自の段階的クロスモーダル整合や汎用回転位置埋め込みなどのメカニズムにより、単一主体および複数主体による駆動生成において、高一貫性と制御性の両立を実現しています。
UNOの応用シーン
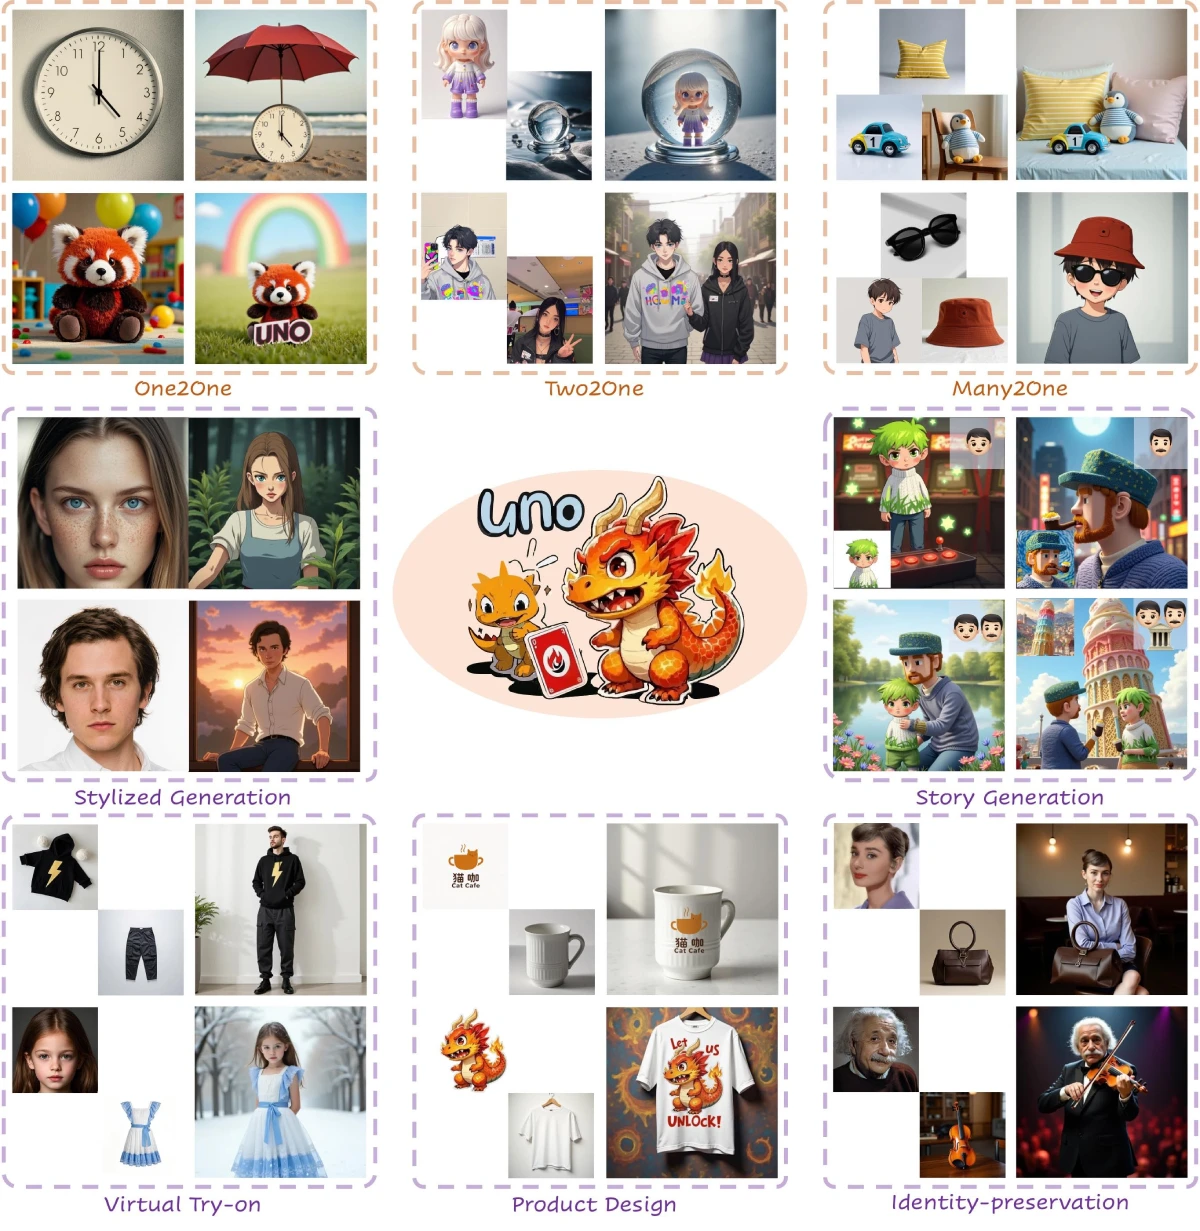
単一主体生成:1枚の参照画像から画像を生成します。例えば、時計の画像から、海辺にある時計の画像を生成できます。
複数主体生成:複数の参照画像から画像を生成します。例えば、人形の画像と水晶玉の画像を参照として、人形が水晶玉の中にいる画像を生成できます。
コンテキスト生成:コンテキストプロンプトを通じて高一貫性を持つ画像を生成します。例えば、「赤い日傘のある海辺の時計」というプロンプトと時計の参照画像を組み合わせて、記述に合った画像を生成できます。
UNOの使用方法
環境設定:
仮想環境を作成し、依存関係をインストールします:
python -m venv uno_env
source uno_env/bin/activate
pip install -r requirements.txt
モデル重みのダウンロード:自動ダウンロード(推論スクリプトを実行する際にコードが自動でダウンロード)、または手動でhuggingface-cliを使用して指定のディレクトリに重みをダウンロードします。
推論例:以下のコマンドを実行して画像を生成します:
python inference.py --prompt "A clock on the beach is under a red sun umbrella" --image_paths "assets/clock.png" --width 704 --height 704
学習:学習スクリプトを実行します:
accelerate launch train.py
関連リンク
プロジェクトホームページ:https://bytedance.github.io/UNO
GitHubリポジトリ:https://github.com/bytedance/UNO
arXiv論文:https://arxiv.org/abs/2504.02160
デモ:https://huggingface.co/spaces/bytedance-research/UNO-FLUX









